高性能の秘密はグーグルの“力業”か
この仕組みはどうなっているのか。AIエンジニアの動詞さんがその仕組みを解説しています。2025年3月に書かれた記事と基本的には同様であろうと推測されています。
重要なのは、画像も音声もテキストもすべてをリファレンスできるモデルに入れる「Any-to-Any(すべてからすべて)」の考え方です。従来は画像やテキストが別々にAIを学習させていましたが、すべて抽象概念として処理してトークン化してしまい、一つのモデルで学習させてしまう。そうすることで、種類を問わずにそれぞれのトークンを参照できるようにするというものです。
2023年12月に発表された米アレン人工知能研究所が中心になって実施した研究「Unified-IO 2: 視覚・言語・音声・動作を統合した自己回帰型マルチモーダルモデルの拡張」では、any-to-anyモデルである「Unified-IO 2」が、テキスト、画像、画像の変化過程、オーディオ、オーディオの変化過程といった情報を入力することで、様々なバリエーションのあるデータを出力できるようになると説明されています。
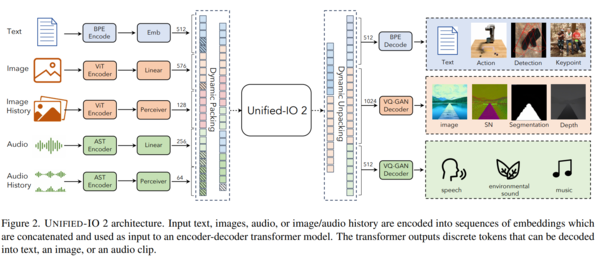
「Unified-IO 2: 視覚・言語・音声・動作を統合した自己回帰型マルチモーダルモデルの拡張」のP.4より
また、学習量を増加させれば、その性能が向上することが証明されています。10億、30億、70億とパラメーター数を向上させると、学習の失敗が減少する傾向がはっきりと出ており、モデルのスケールアップをすると予測力を着実に上げるというスケーリング則が観察できることがわかっています。単純に言えば、この方式は、多数のデータで学習を進めれば進めるほど性能が上がるということが証明されているのです。
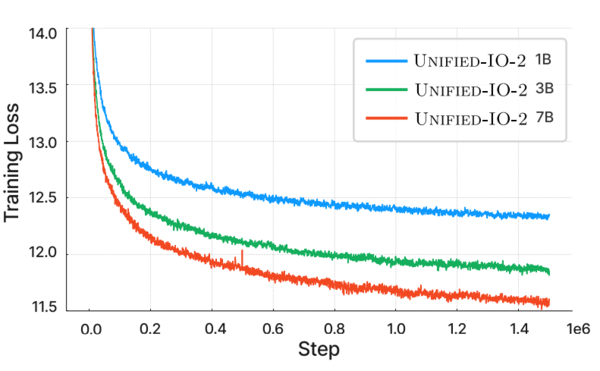
「Unified-IO 2: 視覚・言語・音声・動作を統合した自己回帰型マルチモーダルモデルの拡張」のP.5より
関連する研究は、2023年末から2024年初めにかけて登場したとされていますが、グーグルはそれらの研究を取り込み、データも計算資源も豊富に持っているために、強力に学習を進めて今回のモデルを作成できたということでしょう。要するに、方法論は確立されており、力業で、実現までたどり着いていると言えるのです。
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第177回
AI
AIに「法隆寺の五重塔」を作らせてみた 修正を重ねてたどり着いた驚きの完成度 -
第176回
AI
無料ツールとAIでMV制作が激変 After Effectsまで自動操作できた -
第175回
AI
AIが人間のようにゲームをプレイ 話題の「Jev」を試してわかったこと -
第174回
AI
AIでMVを作るのは想像以上に大変だった 制作34時間、繰り返した“ダメ出し”でわかったこと -
第173回
AI
OpenAI「Astra」は何でもできる、だからこそ“プロの指示”が必要になる -
第172回
AI
ついにAIキャラクターと“ビデオチャット”へ 「MiniMax H3」がリアルタイム生成に接近 -
第171回
AI
5秒の動画を3秒で出せる 動画生成AI「MiniMax H3」が爆速に進化 -
第170回
AI
「うわ、すげえ!」Unreal EngineをCodexに操作させたら制作の常識が変わった -
第169回
AI
もはやローカル動画生成AIの枠におさまらない。MiniMax H3の奥が深すぎる -
第168回
AI
とんでもない動画生成AIが出てきた 無料で試し放題の「MiniMax H3」を徹底検証 -
第167回
AI
“Fable級が無料”は本当か AI市場を震撼させた「Kimi K3」を試した結果 - この連載の一覧へ