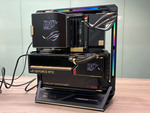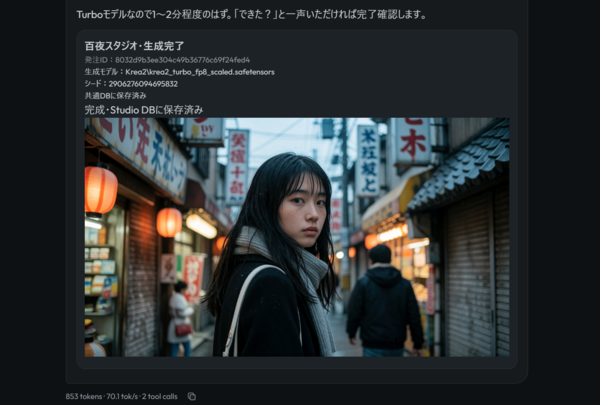
Strata環境で画像を解析してプロンプトを作成し、画像を生成した状態
9月24日に一般公開された「Strata」というローカルLLM向け技術が話題沸騰中です。これまで、ローカルLLMで動かせるモデルの大きさは、使用するPCのVRAMの容量や、RAMとVRAMで共有するユニファイドメモリの容量によって決まっていました。そのため、強力な思考能力を持つローカルLLMまでは動かすことができなかったのです。ところがStrataはVRAMだけでなく、RAMとSSDに必要なデータを分割して持たせることで、その壁を打ち破り、さらに生成の高速化も実現しました。VRAMを搭載したローエンドPCでさえ動かすことができるため、今後のローカルLLMの活用方法を大きく変化させることは確実です。
80GBクラスのAIモデルが、RTX 4090で高速動作
Strataは現在、Alibabaの「Qwen3.8-Flash-Next」のみに対応しています。このモデルは総パラメータ数125B(1250億)ですが、作業内容に応じて使う部分(エキスパート)を切り替えるMoE(Mixture of Experts)方式のため、推論時に有効なのは6B(60億)です。応答の精度も高く、一部のプログラミングや画像解析などにも使えるほどの高い性能を持つと言われています。OpenAIのGPTや、AnthropicのClaudeといった最新のクラウドAIにはかなわないにせよ、1年あまり前に主力だった「GPT-4o」にも匹敵する性能だとも言われています。
ただし、ファイルサイズは圧縮済みでも80GBを超えます。128GB以上のユニファイドメモリを搭載した「Mac Studio」やNVIDIAの小型AI専用PC「DGX Spark」での動作を前提としているモデルです。そのため、コンシューマ向けのビデオカード搭載PCでは、そもそも動作しませんでした。現実的な選択肢としては「Qwen3.8-27B」が挙げられます。ただ、RTX 4090/5090を搭載したハイエンドPCでも、約16~19GBに圧縮したバージョンを使う必要があり、その賢さには限界がありました。
ところが、Strataでは5倍近いパラメータ数を持つQwen3.8-Flash-Nextが動作するというのです。さらにNVIDIAのCUDAライブラリに最適化されているため、生成速度もユニファイドメモリを搭載したPCよりも速いとされています。
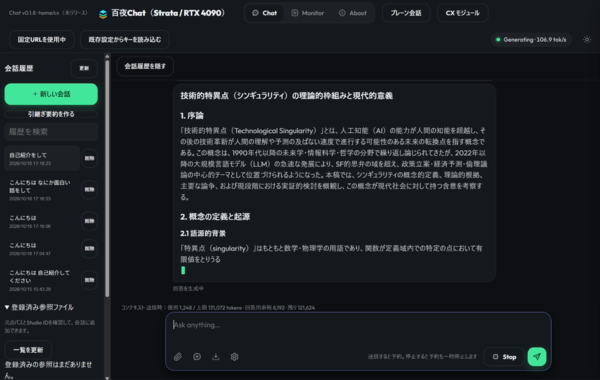
Strata環境でシンギュラリティについてのレポートを書かせているところ。クライアントUIには機能を追加し、かなりカスタマイズしている
△Strata環境が実際に動作しているところ
筆者のRTX 4090搭載PC環境(RAM 64GB)で試したのがこの動画です。筆者の場合は、インストールから環境設定まで、すべてGPT-6 Astraに任せたため、難しい作業をせずに設定を完了させることができました。動作させているのは「sc117-qwen3.8-flash-next-abliterated-iq3_s」で、モデル本体は83.86GBもあります。本来であれば、どうやっても動きません。
「シンギュラリティ」についてのレポートを書かせたところ、毎秒約80トークンの速度で出力しました。テキストが表示される速度はクラウドAIよりも速いぐらいで、その高速さにかなり驚かされます。Strata+Qwenは、VRAMもメモリ(RAM)もギリギリまで使うため、できるだけ使用メモリを減らす必要があります。そこで、RTX 4090搭載PCを専用サーバとして扱い、他のPCから専用クライアントを通じてやりとりしています。
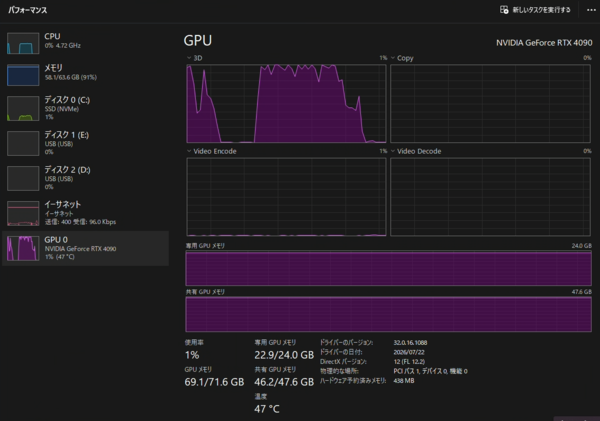
RTX 4090搭載PCが動作している状態。VRAMに収まりきらないデータの一部はRAMに退避させているため、RAMを目いっぱい使っている
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第177回
AI
AIに「法隆寺の五重塔」を作らせてみた 修正を重ねてたどり着いた驚きの完成度 -
第176回
AI
無料ツールとAIでMV制作が激変 After Effectsまで自動操作できた -
第175回
AI
AIが人間のようにゲームをプレイ 話題の「Jev」を試してわかったこと -
第174回
AI
AIでMVを作るのは想像以上に大変だった 制作34時間、繰り返した“ダメ出し”でわかったこと -
第173回
AI
OpenAI「Astra」は何でもできる、だからこそ“プロの指示”が必要になる -
第172回
AI
ついにAIキャラクターと“ビデオチャット”へ 「MiniMax H3」がリアルタイム生成に接近 -
第171回
AI
5秒の動画を3秒で出せる 動画生成AI「MiniMax H3」が爆速に進化 -
第170回
AI
「うわ、すげえ!」Unreal EngineをCodexに操作させたら制作の常識が変わった -
第169回
AI
もはやローカル動画生成AIの枠におさまらない。MiniMax H3の奥が深すぎる -
第168回
AI
とんでもない動画生成AIが出てきた 無料で試し放題の「MiniMax H3」を徹底検証 - この連載の一覧へ