ComfyUIで導入し、高速化LoRAで生成時間を短縮
導入は容易で、最新のComfyUIのテンプレートからMossと検索するだけで見つかります。ただし、基本設定はBaseモデルです。Moss-Imageは、Baseモデルと調整済みのSFTモデルの2種類が存在しますが、通常の画像生成では、追加学習によって出力を調整したSFTモデルをお勧めします。また、基本的には50ステップ(ステップは画像を段階的に生成する処理の回数)が前提となっています。そのため、生成にはかなり時間がかかり、筆者のA6000環境(RTX 3090程度に相当)では1536×1024の画像を生成すると、1枚につき約1分半~2分待つ必要がありました。
しかし、すぐに8ステップでの生成を可能にする高速化LoRA「lodestones MOSS Image SFT 8steps dmd latest.safetensors」が登場しました。これを組み込むだけで、生成時間はかなり短くなります。筆者の環境では1枚20秒程度で生成できます。ただし、弱点もあり、色あせたり、画像や文字が崩れたりする傾向が高まります。筆者が防止策を試したところ、16ステップに増やすと、生成時間は10秒程度長くなりますが、崩れにくくなりました。
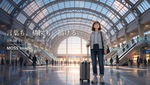
作例と同じプロンプトとシード値を使っていますが、8ステップでは色味が薄かったり、「アスキー旅行」が「アスキン旅行」になるなど、文字の一部が崩れています。しかし、16ステップでは画像の品質は50ステップほどではないにせよ、品質はかなり向上しています。普段の利用では高速化LoRAを適用し、16ステップで生成することをお勧めします。
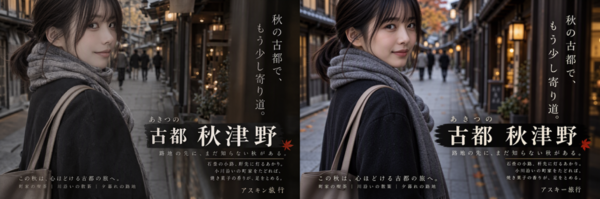
左が8ステップ、右が16ステップ
様々な複雑な条件を反映した画像を生成できるのが特徴で、広告用の画像を作成したり、幅広い年齢層の人物を複数描いたり、テキストの指定をかなり自由に反映したりできるなど、NanoBananaやGPT-Imageといったマルチモーダル型の画像AIに匹敵するかなり幅広い表現能力を持っていることがわかります。以下の作例は「Claude Opus 5.5」に作成させたプロンプトで、ComfyUIを通じてMoss-Imageで生成したものです。
ちなみに、プロンプトを処理するテキストエンコーダーにはAlibabaのQwen系(Qwen3.5-9B)を採用していることもあり、日本語のプロンプトも認識します。
また、筆者が確認した限りでは、アダルト系はヌードまでは生成できますが、それ以上に露骨なものの生成はうまくいかず、そもそも学習データに含まれていない可能性が高そうです。
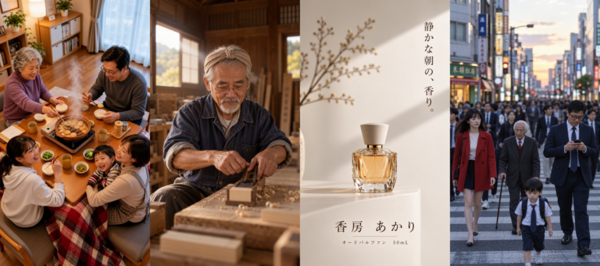
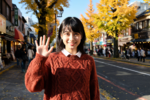
Moss-Imageに作らせた実写作例いろいろ
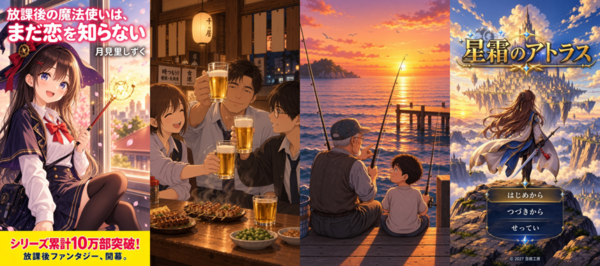
Moss-Imageに作らせたアニメ風作例いろいろ
漫画も作成可能です。かなり細かい指示にも応じるため、漫画を作らせることもできます。ただし、そのプロンプトは非常に複雑になるため、人間が手作業で書くのは不可能に近く、LLMと共同で作成することをお勧めします。参考までに、記事の最後に、1ページ目のプロンプトを掲載しておきます。これをAIに読ませて、自由に改造して利用してください。
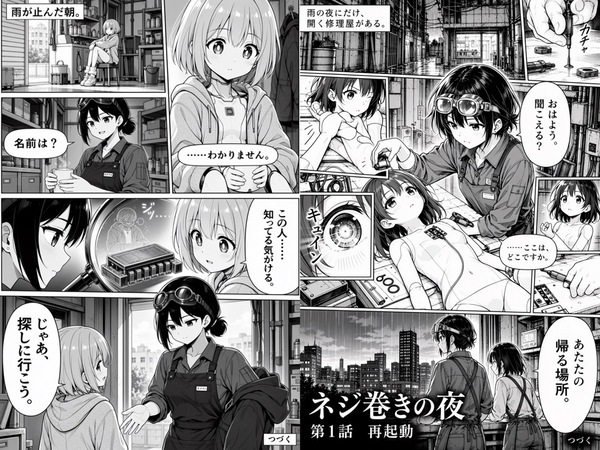
Moss-Imageが生成した漫画。プロンプトはOpus 5.5が作成。現状はリファレンス機能がないのでキャラの一貫性は弱い
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第180回
AI
“AI彼女”が別人になる前に──記憶と人格を自分のPCに移植する -
第178回
AI
GPT-4o級モデルが自宅のPCで動いた! ローカルAIの常識を変える「Strata」 -
第177回
AI
AIに「法隆寺の五重塔」を作らせてみた 修正を重ねてたどり着いた驚きの完成度 -
第176回
AI
無料ツールとAIでMV制作が激変 After Effectsまで自動操作できた -
第175回
AI
AIが人間のようにゲームをプレイ 話題の「Jev」を試してわかったこと -
第174回
AI
AIでMVを作るのは想像以上に大変だった 制作34時間、繰り返した“ダメ出し”でわかったこと -
第173回
AI
OpenAI「Astra」は何でもできる、だからこそ“プロの指示”が必要になる -
第172回
AI
ついにAIキャラクターと“ビデオチャット”へ 「MiniMax H3」がリアルタイム生成に接近 -
第171回
AI
5秒の動画を3秒で出せる 動画生成AI「MiniMax H3」が爆速に進化 -
第170回
AI
「うわ、すげえ!」Unreal EngineをCodexに操作させたら制作の常識が変わった - この連載の一覧へ