

レジスターを増やしてスケジューラーの待機時間を減らす
次がバックエンド。こちらは構造的には大きな違いはないが、以下が異なる。
- 整数レジスターは160→192に、浮動小数点レジスターは256→320にそれぞれ増量
- ROB(Re-Order Buffer)は256→320に増量
- FPUはAVX512FとVNNIをサポート
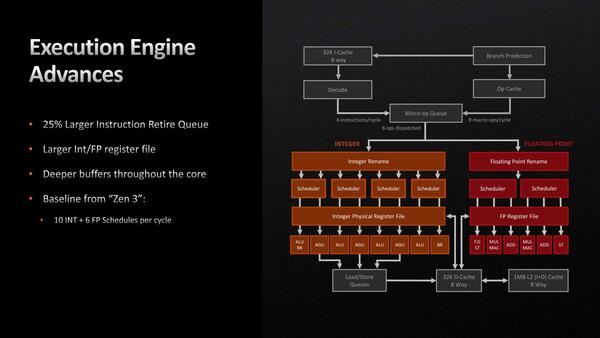
基本的にInteger側にはほとんど変更はない。大きな変更があったのはFloating Point側である
レジスターの増量は、In-Flight(命令を実行可能状態にして、実行ユニットが空くのを待つ状態:実行中の命令もここには含まれる)できる命令数を増やすことが可能になる。レジスターが一杯だと、In-Flight状態として登録できないからだ。
スケジューラーのエントリー数そのものは増えていないが、レジスターを増やしたということは、これまではレジスター数がネックになってスケジューラーがフルに活用できていなかったということと思われる。
ROBの増量もこれと同じである。ROBは命令を実行し終わった後で、その後処理を完了するまで保持をするためのものである。アウト・オブ・オーダーの場合、必ずしも命令の実行順序はプログラムの実行順序とは限らず、しかもある処理結果を別の命令で利用したりする。
あと、結果をメモリーに書き出したりする場合もあるので、それを書き出し終わる(書き出しには時間がかかる)までは命令完了とならない。そこで実行はしたけど完了していない命令を保持するのがROBである。これがあふれると、それ以上命令を実行できなくなるのでパイプラインが一時的に停まることになる。ROBを増やすことで、こうした状況に陥る確率を減らせるわけだ。
それと大きな違いはFPUの構成である。初代Zenの世代でFPUが非対称構成になっており、本来4つのFPUを全部連動させれば256bitのSIMD演算が可能(初代はSSEのみの対応で、256bit幅のAVXは未対応だった)はずながら、FP3がFP1と異なる構成になっている関係で連動できない、という妙な設計思想だった。
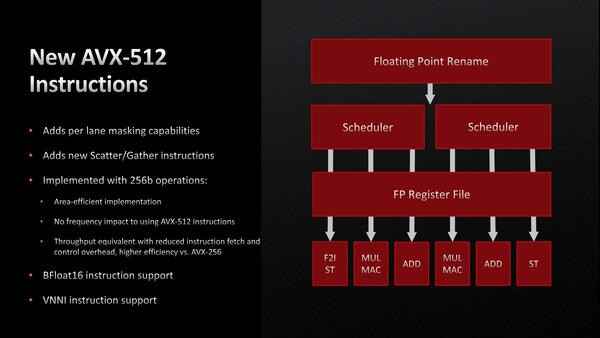
Bfloat16のサポート(AVX512_BF16)も追加されている。とはいえ、VNNIもそうだが、このあたりはRyzen向けというよりはEPYC向けということになる
以前この件でAMDのどなたか(誰に聞いたのかは忘れてしまった)に質問したのだが「いやリソースを最適化した結果こうなった」という、あまり明確でない返事が戻ってきた記憶がある。その後、Zen 2でFPUの幅は倍増し、AVXに対応したが、相変わらず非対称構成は変わらずであり、これはZen 3にも引き継がれた。
まだ筆者はZen 4のFPUの構成を確認できてはいないのだが、2組4つのFPUが連動して動作するようになったことでAVX512F(F:Fundamental AVX512の基本的な命令セット)をサポートできるようになったということから考えると、やっとFP1とFP3が対称構成となったのではないかと考えられる。
加えてこのFPUではVNNIのサポートも追加された。VNNIはCascade Lake世代のXeonで搭載されたAVX512の拡張命令で、元はIntel DL Boost(Intel Deep Learning Boost)という名前で説明されていた。実をいうとVNNIは、当初AVX512の拡張として提供され始めたが、これをAVX2にバックポートしたAVX2 VNNIという命令セットも存在している。
VNNIは要するに畳み込み演算を高速に行なうもので、例えば積和演算はAVX512Fならば、
VPMADDUBSW(Multiply and Add Packed Signed and Unsigned Bytes)
VPMADDWD(Multiply and Add Packed Integers)
VPADDD(Add Packed Integers)
この3つの命令を順番に実行することで実現できるが、これをVPDPBUSD(Multiply and Add Unsigned and Signed Bytes) という1つの命令で代替できる。単純に命令数で数えても3分の1になるわけで、これによってAI処理に付き物の畳み込み演算を高速化できる、というものだ。
これを利用することでAI/機械学習処理をAVX512ベースで高速に処理できるという謳い文句であるが、正直言うとインテルがAlder LakeでAVX512そのもののサポートを外しており、AVX2 VNNIのみなので、サーバー向けはともかくコンシューマー向けにAVX512-VNNIを利用したAIアプリケーションがどの程度出てくるのか? はちょっと不明確である。
もちろんZen 4コアはRyzen 7000シリーズだけでなくGenoaベースのEPYCでも利用されるから、こちらで活用の余地はあるとは思うのだが、コンシューマー向けとしてはあまり期待しない方が良いかもしれない。
ただ、Skylake以降の世代で、AVX-512の動作にはペナルティーがあった(AVX512の連続動作をかける場合、最大動作周波数をやや下げる必要がある)のに対し、はっきりと“No frequency impact”と断じているあたりは、絶対性能よりも性能/消費電力比を取った構成と考えられる。
※お詫びと訂正:記事初出時、Alder Lakeに関する記載で一部誤りがありました。記事を訂正してお詫びします。(2022年10月8日)
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第898回
PC
AI特化とは一線を画すHPCの怪物! 富士通「Monaka」が目指す3D積層と256bit SVE2の真価 -
第897回
PC
NVIDIA独自コア「Olympus」の真価 Vera CPUが見せたIPC全振りの重厚構造とメモリー帯域依存 -
第896回
PC
Arm自社設計「AGI CPU」の全貌、10-wideデコードと2ダイ構成で見せた優等生的な実力 -
第895回
PC
IBM ZがArmを取り込む衝撃! 次世代メインフレーム「z18(仮)」のネイティブDual-ISA戦略の狙い -
第894回
PC
AMD「Ryzen AI Embedded X100」のリアルタイムAI制御が、Jetsonの弱点であるCPU性能を突く -
第893回
PC
インテル製GPU「Crescent Island」の正体、容量480GBメモリーでエージェント型AIとKVキャッシュ問題に挑む -
第892回
PC
Hot Chipsで明かされた「Wildcat Lake」の全貌 Foverosを捨てMCPを選んだインテルの舞台裏 -
第891回
PC
謎多き次世代Xeon「Diamond Rapids」を解剖、3D Meshの進化と新命令セットAPXがもたらす変革 -
第890回
PC
Samsung「SF2P」の全貌! GAA最大の弱点であるPMOS性能低下を克服し、TSMC追撃へ準備万端 -
第889回
PC
なぜ巨大チップは歪んで壊れるのか? SK HynixのHBM4「MR-MUF」とTSMCのCoWoS-Lを襲う熱膨張の罠 -
第888回
PC
NVIDIA Rubin Ultra開発中止の真相! 180層CoWoS-Lの歪曲トラブルと、急造ラックNVL576に透ける苦肉の策 - この連載の一覧へ