16個のスライスに分割した
巨大な32768bit幅のSIMD
各々のスライス構造を示したのが下の画像である。
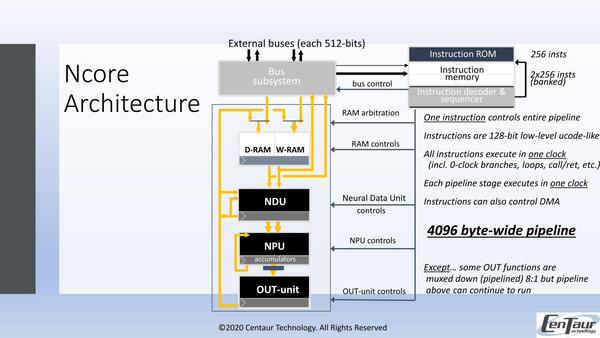
物理的には16個のスライスに分かれているものの、処理そのものは16個のスライスが同期して動く形になるので、本当に巨大な32768bit幅のSIMDなわけだ
Ncoreのワークフロー
(0) Bus Subsystem経由でD-RAM(Data RAM)とW-RAM(Weight RAM:ネットワークの重みを格納する領域)にデータが格納される(これは処理パイプラインの外)
(1) NDU(Neural Data Unit)が4096Bytes分のデータとWeightを読み込み、これの並べ替えや回転、Edge Swap、あるいは前サイクルで処理の終わった出力画像の取り込みといった処理を1サイクルで実行する。
(2) NPU(Neural Processing Unit)で処理する。処理はMAC(乗加算)と加減算、最大/最小、論理命令その他をサポート。9bit/16bit整数とBFloat16が取り扱える。9bit整数ならMACが1サイクル、BFloat16でも3サイクルで処理できる。ちなみにデータ型そのものは8/16bit整数とBFloat16で、8bit整数は内部で9bit化して処理される。ここでWeightのデータを基に、データをネットワーク構造にあわせて処理する。
(3) OUT-unitでは、NPUの結果の量子化やReLU(ランプ関数)/Tanh/シグモイド関数を利用した活性化、出力の正規化などが行なわれ、結果がD-RAMないしNDUに引き渡される。ほとんどの処理は1~3サイクルで完了するが、例えば8:1の重ね合わせなどは最悪値で10サイクルほど要する
ここで1回分のデータ(例えば映像処理なら1フレーム分の画像データ)が完了するまで(1)~(3)をパイプライン式に繰り返し、終わったら(0)に戻る、という形である。
一方制御命令であるが、128bit幅のもので、これを見ると限りなくVLIWに似ている。ただし詳細は未公開である。
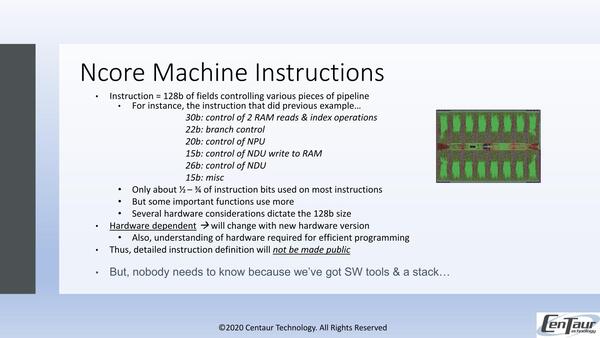
制御命令は128bit幅だが詳細は不明。きっと以前と同様、秘密保持契約を結ぶと開示されるのであろう
このあたりは昔のVIA C3などで提供されてきた独自拡張命令に近い感じに見える。ただ必要なツールやスタックはCentaurから提供されるので、直接アプリケーションプログラマーがこれを触る必要はない、としている。
さてNcore、構造そのものはシンプルながら、なにしろ32Kbit幅のデータパスであるから、それなりに実装は困難だったらしい。
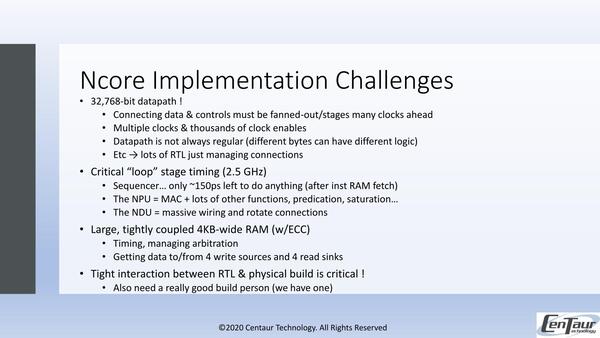
これを2.5GHzで動かすのも確かに大変。そこらのAIアクセラレーターよりはるかに難易度の高い構成になってるのは気のせいだろうか?
下の画像がNcoreのうちでロジック部のアップである。この部分だけで11mm2というのは、性能を考えるとかなり小さい方である。
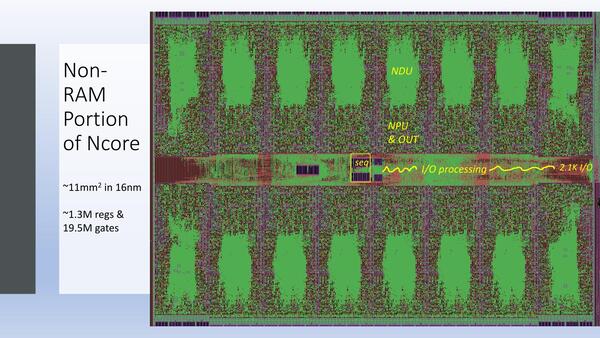
ロジック部のアップ。実際には、NCORE COMPUTEの倍近い面積を必要とするNCORE RAMも必要になるので、実質的なエリアサイズは30平方mm超と思われる
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第897回
PC
NVIDIA独自コア「Olympus」の真価 Vera CPUが見せたIPC全振りの重厚構造とメモリー帯域依存 -
第896回
PC
Arm自社設計「AGI CPU」の全貌、10-wideデコードと2ダイ構成で見せた優等生的な実力 -
第895回
PC
IBM ZがArmを取り込む衝撃! 次世代メインフレーム「z18(仮)」のネイティブDual-ISA戦略の狙い -
第894回
PC
AMD「Ryzen AI Embedded X100」のリアルタイムAI制御が、Jetsonの弱点であるCPU性能を突く -
第893回
PC
インテル製GPU「Crescent Island」の正体、容量480GBメモリーでエージェント型AIとKVキャッシュ問題に挑む -
第892回
PC
Hot Chipsで明かされた「Wildcat Lake」の全貌 Foverosを捨てMCPを選んだインテルの舞台裏 -
第891回
PC
謎多き次世代Xeon「Diamond Rapids」を解剖、3D Meshの進化と新命令セットAPXがもたらす変革 -
第890回
PC
Samsung「SF2P」の全貌! GAA最大の弱点であるPMOS性能低下を克服し、TSMC追撃へ準備万端 -
第889回
PC
なぜ巨大チップは歪んで壊れるのか? SK HynixのHBM4「MR-MUF」とTSMCのCoWoS-Lを襲う熱膨張の罠 -
第888回
PC
NVIDIA Rubin Ultra開発中止の真相! 180層CoWoS-Lの歪曲トラブルと、急造ラックNVL576に透ける苦肉の策 -
第887回
PC
AIなしではもはや限界 TSMCが明かすメモリー開発にAIが不可欠となった現実 - この連載の一覧へ