最新パーツ性能チェック 第485回
メモリー128GB版のSurface Laptop Ultraで検証
RTX Sparkは本当にローカルAIに強いのか?RTX 5090や5070 Ti、5060 Ti 16GB、4090 Laptop GPUと性能を比較
2026年11月16日 10時00分更新


VRAMからデータがあふれても傾向は大きく変化しない
Qwen 3 8B程度のAIモデルではRTX SparkのVRAMの多さが活かせないので、次はもっと大きなAIモデルを利用することで限界を攻めてみよう。ここでは「ComfyUI Desktop」を利用する。テキストから動画を生成する、いわゆる「Text to Video」の生成時間で比較することにした。
テストに使用するワークフローは「LTX-2.5-dev」および「MiniMax-H3」を使用したものを用意。LTX-2.5-devに関しては再生時間10秒と15秒のパターンを検証するが、尺違いの条件を設けた理由は、尺が長いほどVRAMを消費するためだ。今回のテストでは15秒版は4〜5GB余分に消費する。MiniMax-H3は負荷を重くする意図から15秒のみとしている。
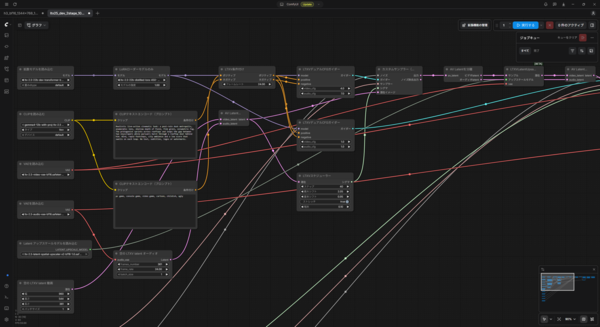
ComfyUIのワークフロー。ノードの接続はもっと良いものがあるだろうが、テスト用なのであまり追い込んではいない
まずは各ワークフローの概要を解説しておこう。先ほどのMLPerf Clientは今となっては軽量の8Bモデルを選択していたが、このテストではもっと重いAIモデルを選択している。昨今のComfyUIではInt8 ConvRotを使ってモデルを軽量化するのがトレンドだが、あえて「重いモデルを載せる」ためにbf16版のモデルを採用している。
上の表が示す通り、動画の生成本体だけで40GB以上という巨大なモデルを使用する。RTX 5090の32GBでは足りないが、ComfyUIにはVRAMが足りなくなった場合、メインメモリーに不要なデータを退避させることができる。つまり、VRAMの不足ぶんはメインメモリーがカバーしてくれる(そこから漏れたら、最終的にはストレージで補う)。
ただし、自作PC環境のメインメモリーの速度はDDR5-5600なので、RTX SparkのLPDDR5X-9400に比べると遅い。VRAM不足が確実な状態でわざわざ低速なDDR5-5600に退避させるのが得策なのか注目だ。そして、RTX 4090 LT環境はメインメモリーが32GBなので16GBのVRAMを合わせても到底足りない。その場合、ストレージも動員することになる。
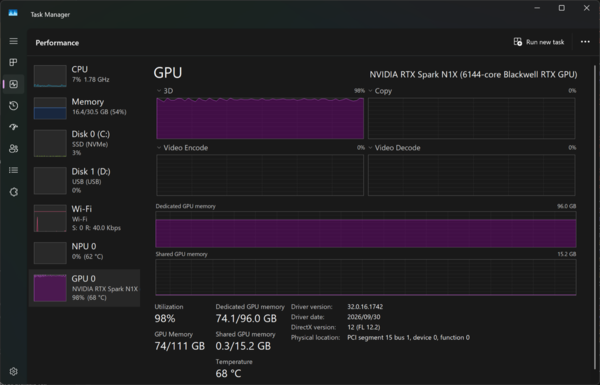
RTX Spark環境におけるComfyUI(LTX-2.5-dev)のテストラン中のGPUの状態。3D、すなわちGPUコアはほぼフル稼働、VRAMは96GB割当のうち74GBを占有している。メインメモリーは16GB程度である
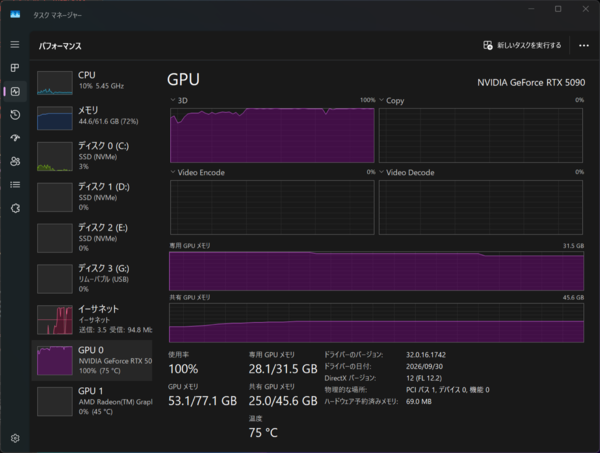
こちらはRTX 5090環境におけるテストラン中の状態。こちらではVRAMをほぼ使いきっており、さらにメインメモリーも64GB中44GBが使用されている。VRAMからあふれたぶんをメインメモリーに退避していることがわかる。ほぼ電力制限ギリギリまで使っているようで、RTX 5090のファンがゲームでは到底発しないような轟音を立てていた
では、テスト毎に処理時間がどう変わるかチェックしよう。まずはLTX-2.5-devの結果から。10秒版と15秒版を一気に比較する。
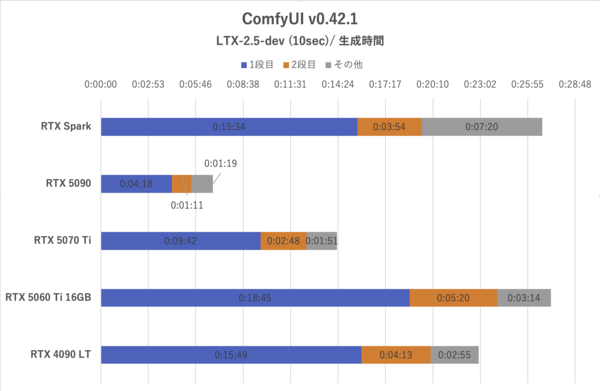
ComfyUI:LTX-2.5-dev (10秒)の処理時間
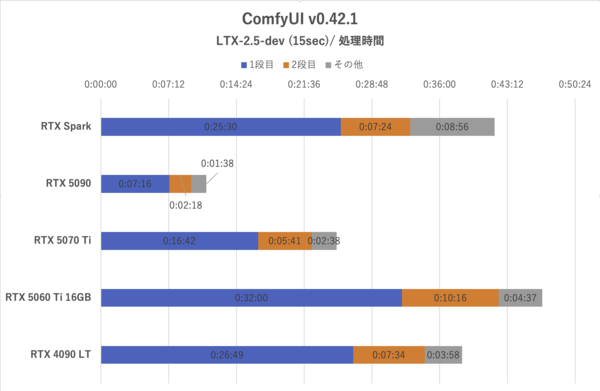
ComfyUI:LTX-2.5-dev (15秒)の処理時間
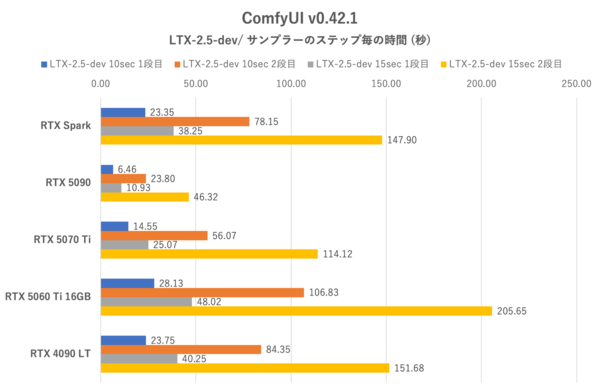
ComfyUI:LTX-2.5-devの1段目40ステップ、2段目3ステップそれぞれにおいて、ステップ毎にかかった時間の平均値
全体傾向はMLPerf Clientと大きく変化していない。RTX 5090はVRAMにすべてのモデルを置いておくことができず、メインメモリーに退避させることになったが、それでも処理速度はRTX Sparkよりも圧倒的に速い。
そして、RTX 5090よりもVRAMの少ないRTX 5070 Tiであっても、RTX Sparkのほうが格段に遅い。比較対象をRTX 5060 Ti 16GBまで落としてようやく勝てるようになる。ここでようやくCUDAコアやTensorコア数の違いが出てくるようだ。
さらに言うなら、VRAMからあふれたデータをストレージにも退避させているRTX 4090 LTよりも、RTX Sparkのほうが遅い。RTX 4090 LTに負けている最大の要因は1〜2段目の処理よりも、それ以外の処理時間(グラフ中の「その他」)が重いという点も興味深い。
この「その他」の処理時間は難題である。生成する動画の尺を長くしても、1~2段目の処理ほど劇的に処理時間が長くならないのだ。生成処理1〜2段目は動画の尺を5秒長くしただけで、ステップあたりの処理時間が1.6〜2倍になるのだが、「その他」の部分は1.2〜1.4倍増にとどまる。
RTX Sparkの「その他」の処理時間は、比較対象よりも明らかに長い。今回の検証では、その原因がなにかまでを判断できるデータを取得できず残念に思う。気を取り直して、続いてはMiniMax-H3だ。
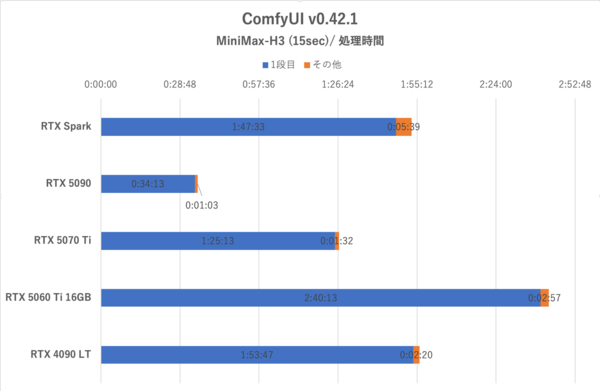
ComfyUI:MiniMax-H3の処理時間
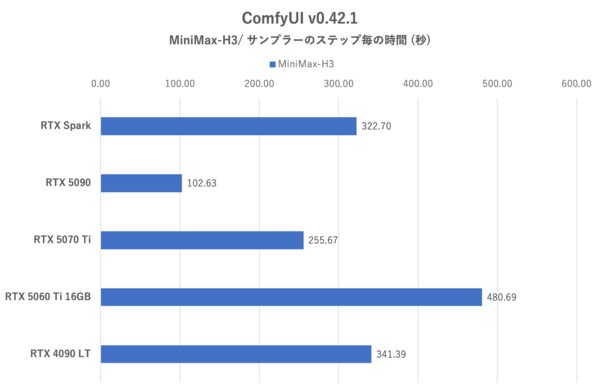
ComfyUI:MiniMax-H3の1段目20ステップにおいて、ステップ毎にかかった時間の平均値
MiniMax-H3はLTX-2.5-devのタスクより解像度が低く、ステップ数も減らしている。しかし、AIモデルが大きいため処理時間がさらに長くなる。実際、本検証は3回実施した平均からグラフを作成しているが、1回のテストに8時間程度かかるケースもあった。
ここでもRTX 5090が飛び抜けて速く、続いてRTX 5070 Tiという順位だ。VRAMが16GBと少なくても。メインメモリーとストレージに空き容量があれば、問題なく実行できるのはComfyUIのおかげだ。しかし、その少ないVRAMでも高速に処理するためにはCUDAコア数とメモリー帯域、そしてそのGPUが使える電力にかかっている。
ここでRTX 5060 Ti 16GBとRTX 5070 Tiの差に着目すると、どちらもVRAM 16GBなのでメインメモリーにデータが退避されるのは同じだが、処理時間はRTX 5070 Tiのほうが圧倒的に高速である。RTX 5060 Ti 16GBはCUDAコア数、メモリー帯域、PCI Expressの帯域、そしてGPUが使える電力も絞られているため遅いと判断できる。
RTX 4090 LTはVRAM 16GBに加え、メインメモリーも少ない(32GB)ためさらに不利だが、RTX 5060 Ti 16GBよりもわずかに処理時間が短い。RTX 5060 Ti 16GBになくてRTX 4090 LTにあるものと考えると、CUDAコアとTensorコアの多さとメモリー帯域となる。RTX 4090 LTのCUDAコア数はRTX 5060 Tiの2倍近い9728基、Tensorコアも304基(RTX 5060 Tiは144基)と多い。メモリー帯域に関しても、576GB/sec対448GB/secとRTX 4090 LTが優位だ。
また、今回テストに起用したRazer Blade 16のRTX 4090 LTのTGP(Total Graphics Power)は定格150Wのため、RTX 5060 Ti 16GBの170Wと大差ない。ゆえに、性能差は電力よりもCUDAコアやTensorコアの数と、メモリー帯域の太さのほうが大きく影響していると言える。
そして、今回の主役であるRTX Sparkは、ここではRTX 5060 Ti 16GBに圧勝し、RTX 4090 LT搭載PCに対してわずかに高速という結果となった。メインメモリーが32GBと非常に少ないため、ストレージまで動員するRTX 4090 LT搭載PCが自滅したといったところだろう。
まとめ:VRAM容量以外の要素が足を引っ張る
というわけで、AIを中心にLLMや動画生成といった処理における性能差を検証してきたが、RTX Sparkはユニファイドメモリーで128GBあっても、肝心のCUDAコアやTensorコアの数、メモリー帯域といった部分が足を引っ張り、AIを劇的に快適にするとは言い難い。
RTX SparkはノートPC形態で利用でき、かつTDP 35Wで動き、なおかつ重いAIモデルも動かせると考えれば一定の評価はできる。だが、本気でAIを回すのであれば、ディスクリートGeForceのほうが速いケースも珍しくないため、AI開発における「魔法のアイテム」になる、とは安易に言うことはできない。
AIモデルが軽量だったMLPerf Client(Qwen 3 8B)では、CUDAコアやTensorコアの数、メモリー帯域がネックでRTX 5060 Ti 16GBにも負けてしまったが、重いモデルを使用したComfyUI(MiniMax-H3)ではRTX 4090 LT環境に勝てた。ただ、RTX 4090 LT環境で限界までメモリーを増設(最大64GB)すれば、そのリードも逆転する可能性は十分考えられる。
また、今回ComfyUIのテストではbf16を使用する重いAIモデルを載せることにフォーカスしている。LTX-2.5-devではRTX SparkがRTX 4090 LTに処理時間で負けているものの、RTX 50シリーズ以降でネイティブ対応したFP4で勝負させればまた結果が変わった可能性がある。FP4による検証は機材貸し出し期間という時間的制約で実施できなかったので、次回チャンスがあればそこも攻めてみたい。
さらに、今回はQwen 3.6 35BやQwen 3.8 27Bといった、パラメーター数の多いAIモデルの検証も時間的制約からデータを取りきる前に終わってしまった。コンテクスト長を262Kまで確保した場合、RTX Sparkが輝く可能性もある。ここも次回の課題としたい。
そして、RTX Sparkの性能とTDPの関係も検証すべき大きなテーマの1つになった。これは遠からず登場するRTX Spark搭載デスクトップPCを「お借りすることができれば」解明できるだろう。ここは機材貸し出しという名のチャンスが巡ってくることを待ちたい。
次回はSurface Laptop Ultraのゲーミング性能を検証する。現時点で傾向はざっくりとわかったようなものだが、きちんとデータとして残しておくことが重要なのだ。
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第484回
自作PC
Surface Laptop Ultraの基本性能を検証、RTX Sparkの3D描画性能はRTX 5060と5050の間ぐらい -
第483回
自作PC
左手(AI)はそえるだけ。「NBA 2K27」でDLSS 5におけるニューラルレンダリングの画質とフレームレート下落率を検証 -
第482回
自作PC
CPU性能はRyzen 7 5700Xに比肩!Arc G3 Extreme搭載ポータブルゲーミングPCの性能は驚異的だった -
第481回
デジタル
旧世代Ryzenに3D V-Cacheでどこまで戦える?「Ryzen 7 7700X3D」「Ryzen 7 5800X3D 10th Anniversary Edition」レビュー -
第481回
自作PC
Radeon RX 9050はわずか92Wの低消費電力でRDNA 4世代の先進技術を搭載、省エネと性能を両立した最新性能レビュー -
第480回
自作PC
Radeon RX 7000シリーズが予定より早くFSR 4に対応、中堅GPUでもより鮮明でリアルな映像を実現! -
第479回
自作PC
Radeon RX 9070 GREレビュー! VRAM 12GBでRTX 5060 Ti 16GBに圧勝しRTX 5070に迫る -
第478回
自作PC
Ryzen 9 9950X3D2最速レビュー【後編】 デュアル3D V-Cacheのゲーム性能を詳しくチェック -
第477回
自作PC
Ryzen 9 9950X3D2最速レビュー デュアル3D V-Cacheで開発者・クリエイター向け最強CPUになった驚きの実力を解説 -
第476回
自作PC
ゲーム30本でCore Ultra 7 270K PlusとCore Ultra 5 250K Plusの性能テスト!9700Xや14700Kよりも優秀で、Intel BOTの恩恵も大きめ - この連載の一覧へ