最新パーツ性能チェック 第485回
メモリー128GB版のSurface Laptop Ultraで検証
RTX Sparkは本当にローカルAIに強いのか?RTX 5090や5070 Ti、5060 Ti 16GB、4090 Laptop GPUと性能を比較
2026年11月16日 10時00分更新


軽量モデルでは素のGPU性能で負ける?
では、本命のAIを利用した検証に入ろう。今回は「MLPerf Client」を使用する。AIモデルは「Qwen 3 8B」を選択した。
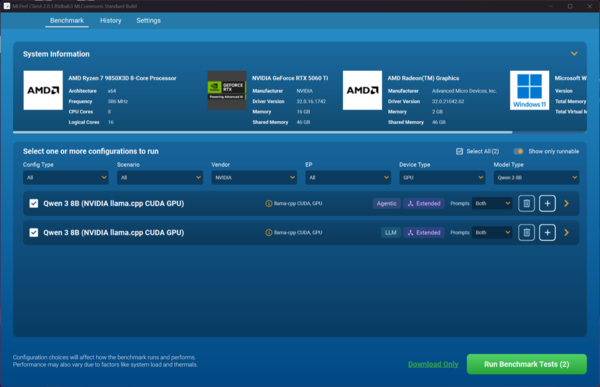
MLPerf Clientでは画像生成やRAGなどさまざまなテストを実行できるが、Qwen 3 8Bが利用できるLLMおよびAIエージェントテストを実施した
LLMテストは以下のような5つのタスクで構成されている。以降のグラフで示すOverallとは、以下の5つのテストの結果の平均をとったものだ。
●Content Generation:短い指示からテキストを生成
●Creative Writing:物語の創作
●Structured Text:JSONなどの構造化テキスト出力
●Code Analysis:プログラムの分析と検証
●Summarization, Intermediate:長いプロンプト(約3600トークン)から内容を抽出し要約
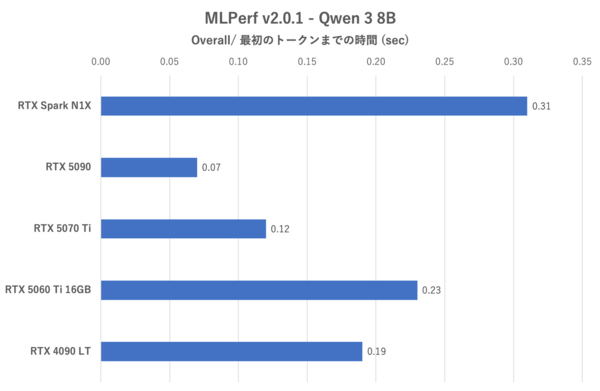
MLPerf Client:最初のトークンまでの時間。「Summarization, Substantial」テスト以外の全タスクの平均値(Overall)
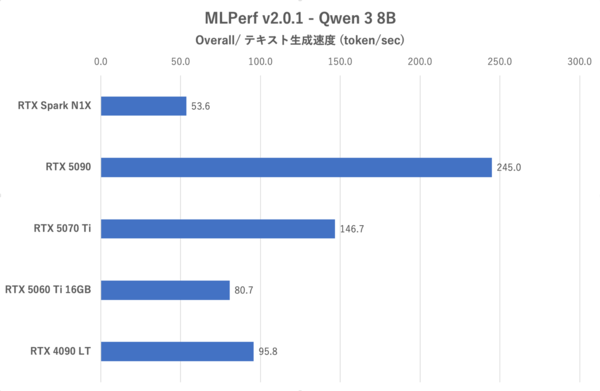
MLPerf Client:テキスト生成速度。「Summarization, Substantial」テスト以外の全タスクの平均値(Overall)
全体(Overall)の結果を見ると、RTX Sparkの微妙な点が浮かび上がる。最初のトークンまでの時間においてもテキスト生成速度においても、RTX 5060 Ti 16GBどころかRTX 4090 LTを下回っているのだ。広大なVRAMが利用できるSoCとしては評価できるが、ディスクリートのGeForceには今ひとつ及ばない。CUDAコアやTensorコア、メモリー帯域を絞り、TDP 35Wの電力制限をかけている点が足かせになっていると考えられる。
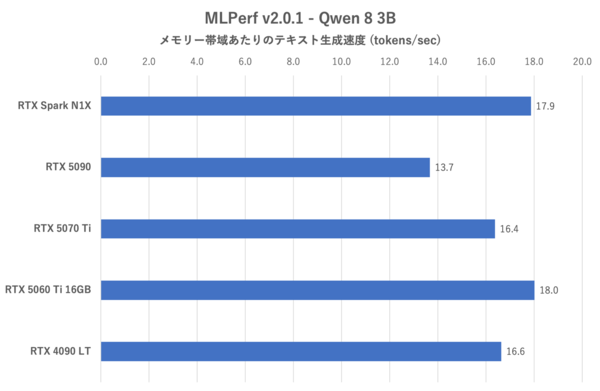
MLPerf Client:前掲のテキスト生成速度を各GPUのVRAM帯域で割ったもの
メモリー帯域が足かせになっている説を補強するために、テキスト生成速度をメモリー帯域で割った値を比較する(上グラフ)。これによれば、RTX Sparkは今回比較したGeForceに比べて極端に遅いわけではない。メモリー帯域なりの性能であることが示唆されている。この観点でいえば、RTX 5090はメモリー帯域を持て余し気味(帯域が太い割に速度が出ない)だ。多分これは、Qwen 3 8BというAIモデルがRTX 5090には小さすぎることも関係しているだろう。
Summarizationテストにおいては、「Summarization, Intermediate」(約3600トークン)よりもさらに長大なプロンプト(約7600トークン)を処理させる「Summarization, Substantial」テストも実施した。入力プロンプトが長くなるほどプリフィル(プロンプトの処理)性能がモノを言うようになるが、メモリー帯域を絞ったRTX Sparkではやや厳しいと考えられる領域である。
この追加テストの結果については、「Summarization, Intermediate」と「Summarization, Substantial」の結果を直接比較する形でチェックしてみよう。評価軸は最初のトークンまでの時間とテキスト生成速度の2つ。
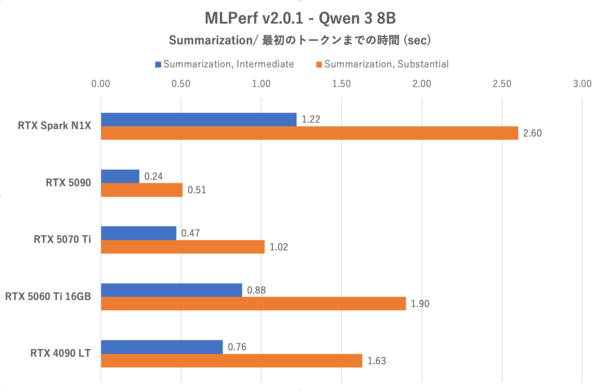
MLPerf Client:最初のトークンまでの時間。「Summarization, Intermediate」と「Summarization, Substantial」の比較
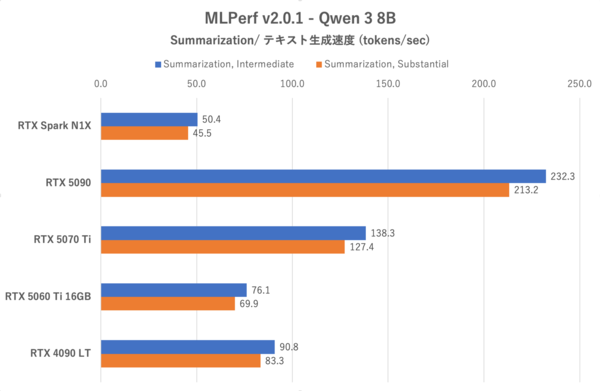
MLPerf Client:テキスト生成速度。「Summarization, Intermediate」と「Summarization, Substantial」の比較
入力トークン数が増えてもテキスト生成速度は10%落ち程度にとどまったが、予想通り最初のトークンまでの時間、つまりプリフィル処理に時間がかかるようになったことが示されている。メモリー帯域の細いRTX Sparkではこのペナルティーがより強く出るのではと予想していたが、どのGPUも「Summarization, Intermediate」のおよそ2.1倍となっており、この点については差が出ていない。
ただし、RTX SparkのパフォーマンスはQwen 3 8B程度の軽いモデルでもRTX 4090 LTに及ばない。もっといえば、RTX SparkよりCUDAコア数の少ないRTX 5060 Ti 16GBにも後れをとる。この点はメモリー帯域や使える電力が足かせになっていると考えられる。
続いてはAIエージェントタスクの処理時間を比較する。MLPerf Clientでは次の2つのタスクを実施している。エージェントが呼び出すツールは主にPythonが使われるが、ツールの部分はCPU性能が影響する。
●Data Analyst Agent:仕入れ・販売のデータ(約30万行)の構造把握→分析→解釈を経て最終レポートを出力
●SWE Agent:プログラムのソースを読み、レビューして修正→検証する。テストスクリプトの実行も含まれる
ちなみに、MLPerf ClientにおけるAIエージェントテストはあらかじめシナリオが決められており、それに沿った形で処理する時間を比較する(でなければベンチマークにならない)。ゆえに、AIのアウトプットに対する精度は評価していない点に注意したい。
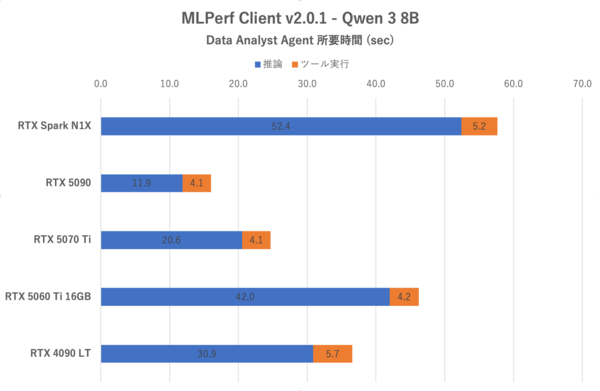
MLPerf Client:Data Analyst Agentの処理時間
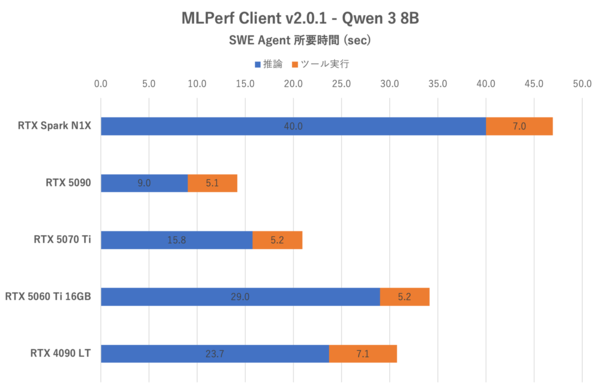
MLPerf Client:SWE Agentの処理時間
AIエージェントに関しても傾向は変わらない。Qwen 3 8Bという軽量なモデルを使っているため、RTX 4090 LTやRTX 5060 Ti 16GBでも余裕でRTX Sparkの性能を上回っている。とくに、SWE Agentテストの差は非常に大きい。
グラフのバーの内訳に注目すると、RTX Spark推論の部分がかなり遅く、前掲のLLMタスクの結果と傾向は同じだ。一方で、ツール実行に関しては主にCPUで実行される部分であるため、推論ほど大きな差は出ていない。ただし、SWE Agentのツール実行時間においては、RTX Sparkはコア数の少ないRyzen 7 9850X3Dよりもやや遅いという結果になっている。
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第484回
自作PC
Surface Laptop Ultraの基本性能を検証、RTX Sparkの3D描画性能はRTX 5060と5050の間ぐらい -
第483回
自作PC
左手(AI)はそえるだけ。「NBA 2K27」でDLSS 5におけるニューラルレンダリングの画質とフレームレート下落率を検証 -
第482回
自作PC
CPU性能はRyzen 7 5700Xに比肩!Arc G3 Extreme搭載ポータブルゲーミングPCの性能は驚異的だった -
第481回
デジタル
旧世代Ryzenに3D V-Cacheでどこまで戦える?「Ryzen 7 7700X3D」「Ryzen 7 5800X3D 10th Anniversary Edition」レビュー -
第481回
自作PC
Radeon RX 9050はわずか92Wの低消費電力でRDNA 4世代の先進技術を搭載、省エネと性能を両立した最新性能レビュー -
第480回
自作PC
Radeon RX 7000シリーズが予定より早くFSR 4に対応、中堅GPUでもより鮮明でリアルな映像を実現! -
第479回
自作PC
Radeon RX 9070 GREレビュー! VRAM 12GBでRTX 5060 Ti 16GBに圧勝しRTX 5070に迫る -
第478回
自作PC
Ryzen 9 9950X3D2最速レビュー【後編】 デュアル3D V-Cacheのゲーム性能を詳しくチェック -
第477回
自作PC
Ryzen 9 9950X3D2最速レビュー デュアル3D V-Cacheで開発者・クリエイター向け最強CPUになった驚きの実力を解説 -
第476回
自作PC
ゲーム30本でCore Ultra 7 270K PlusとCore Ultra 5 250K Plusの性能テスト!9700Xや14700Kよりも優秀で、Intel BOTの恩恵も大きめ - この連載の一覧へ