複数のTileをまたぐパイプライン処理となる
「SuperLane」
AIの推論に使う処理で言えば、まずConvolutionを行ない、次にActivationをして、最後に結果を格納する形になるが、そのためにまず最初にFP/INTでの演算を20Tileで同時に処理し、次のTileで必要ならActivation(SXM)をした後に、次のTile(MEM)に引き渡してメモリーへの書き出しを行なう。
もう少し個々のTileの詳細をまとめたのが下の画像である。各々のTileは16wayのINT/SIMDエンジンと、Tile間のOn-Chip NetworkのI/Fを持っている。
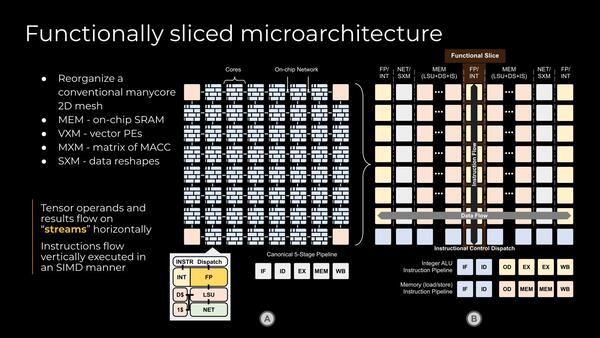
各々のTileは比較的シンプルな5段のIn-Orderパイプライン。もちろんスーパースカラーなども必要ないので、非常にシンプルである
この図で言えば、左側の8×8のTileで、縦方向の8つには原則として同じ命令が与えられ、データを自分の左のTileから取り込み、処理結果を右方向のTileに流すという形で動作することになる。
この結果として、命令処理は複数のTileをまたぐ形でのパイプライン処理になるというのが下の画像である。各々のTileに対してトータルで144の命令キューが用意されており、それぞれのTileに対しての必要な命令を割り当てる格好になっている。
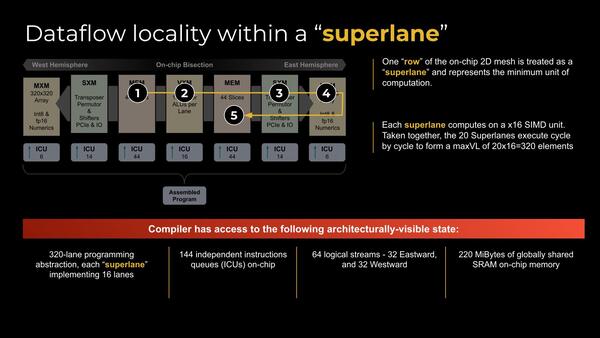
命令は複数のTileをまたぐパイプライン処理になる。同社はこれをSuperLaneと称する。ちなみにWest Hemisphere(西半球)とEast Hamisphere(東半球)は次の写真を参照
さて、西や東という用語が出てくる理由だが、TSPの内部構造は下の画像のような格好になっている。中央に合計220MBのSRAM(左右それぞれ44バンクで110MBづつなので、1バンクあたり2.5MB)がおかれ、その間に共通のVXM(ベクトル演算モジュール)が用意される。
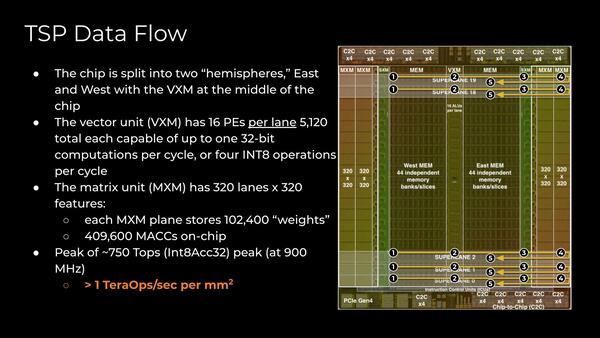
TSPの内部構造。ちなみにダイサイズはおおよそ725平方mmとされる。これだけSRAMを搭載すれば当然だろう。製造プロセスは14nm CMOS。ファウンダリーはGlobalFoundriesとのことで、14LPPあたりであろう
SRAMの外にはまずSXM(スカラー演算ユニット:Activationなどに向けた特殊関数を提供する)がおかれ、さらにその外には2つのMXM(Matrix of MACC:MAC演算ユニット)が配される。このMXMは全部で10万2400の「重み」(畳み込み演算をする際の係数)を格納できる仕組みになっている。
1つ前の画像(SuperLane)の1~5の番号をもう一度見直すとわかりやすい。まず西側のメモリーからデータを取り出し、中央のVXMでベクトル演算を行ない、次いでSXMで必要に応じてシフト演算などを実行、MXMでActivationを経て、最後にそれを東側のメモリーに格納するという流れである。
もっともこれ、逆に東側のメモリーから取り込んで最終的に西側に格納するというストリームもありそうではあるが。
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第898回
PC
AI特化とは一線を画すHPCの怪物! 富士通「Monaka」が目指す3D積層と256bit SVE2の真価 -
第897回
PC
NVIDIA独自コア「Olympus」の真価 Vera CPUが見せたIPC全振りの重厚構造とメモリー帯域依存 -
第896回
PC
Arm自社設計「AGI CPU」の全貌、10-wideデコードと2ダイ構成で見せた優等生的な実力 -
第895回
PC
IBM ZがArmを取り込む衝撃! 次世代メインフレーム「z18(仮)」のネイティブDual-ISA戦略の狙い -
第894回
PC
AMD「Ryzen AI Embedded X100」のリアルタイムAI制御が、Jetsonの弱点であるCPU性能を突く -
第893回
PC
インテル製GPU「Crescent Island」の正体、容量480GBメモリーでエージェント型AIとKVキャッシュ問題に挑む -
第892回
PC
Hot Chipsで明かされた「Wildcat Lake」の全貌 Foverosを捨てMCPを選んだインテルの舞台裏 -
第891回
PC
謎多き次世代Xeon「Diamond Rapids」を解剖、3D Meshの進化と新命令セットAPXがもたらす変革 -
第890回
PC
Samsung「SF2P」の全貌! GAA最大の弱点であるPMOS性能低下を克服し、TSMC追撃へ準備万端 -
第889回
PC
なぜ巨大チップは歪んで壊れるのか? SK HynixのHBM4「MR-MUF」とTSMCのCoWoS-Lを襲う熱膨張の罠 -
第888回
PC
NVIDIA Rubin Ultra開発中止の真相! 180層CoWoS-Lの歪曲トラブルと、急造ラックNVL576に透ける苦肉の策 - この連載の一覧へ