初代Google TPUの2倍の性能を誇る第2世代
以下、この2つのソースをもとに解説する。まずGoogle TPU v2の基本構成が下の画像だ。1つのチップに2つのダイが搭載され、おのおののダイに8GBのHBMが装着される構成になっている。
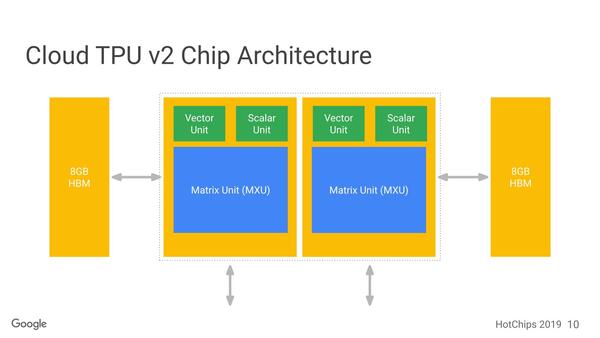
初代Google TPUの反省は外部メモリーの帯域が低すぎたことだそうで、それもあってHBMを使って大幅に高速化された
それぞれのコアの詳細は下の画像だ。MAC Unitは128×128と1/4のサイズになったが、その代わり一度に全ユニットの計算が可能になっている。
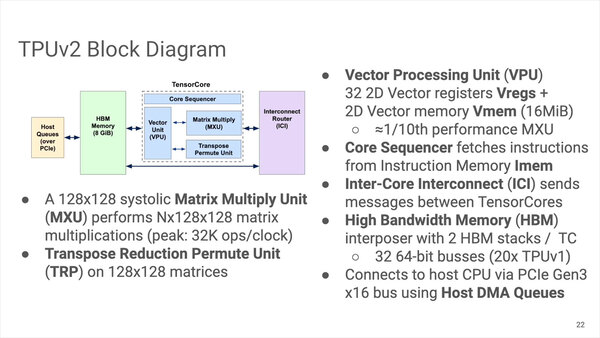
ダイあたりで言えば、PCIe Gen3 x32でホストと接続される構造となる。VPUはMXUの10分の1程度の性能とされる
また16MBのVmemも搭載されている。加えて言えば、データ型も初代のINT 8からTPU v2ではBfloat16/FP32に切り替わった。推論だけならINT 8のままでいいのだろうが、学習に向けてはやはりもう少し精度というか桁数が欲しい、というニーズに応えたものである。
ダイのフロアプランは下の画像がわかりやすい。MXUよりもVPU+Vmemの方がはるかに大きなエリアを占めているのがわかる。
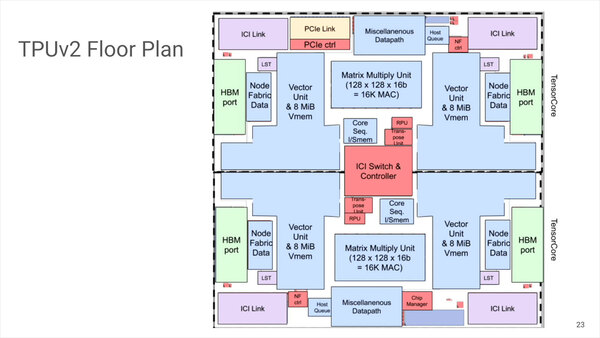
PCIe Linkそのものはダイに1ヵ所か所で、このあたりだけ対称性が崩れている。製造プロセスやダイサイズなどは未公表だが、プロセスは時期的なものから考えるとTSMCの20nmではないかとみられている。動作速度は700MHz
またこのGoogle TPU v2の設計の最中に、Bach normalizationという論文が発表されている。この仕組みを、Google TPU v2ではハードウェアとソフトウェアでサポートすることで、学習速度を最大14倍にできたとしている。
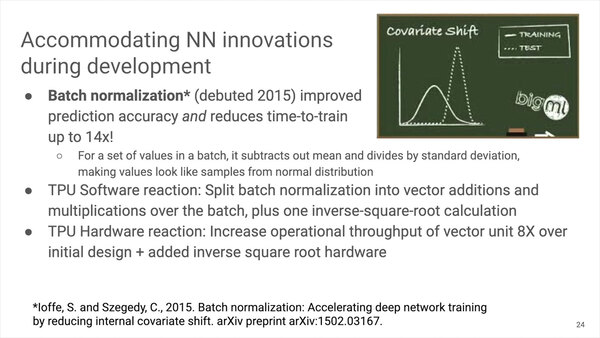
具体的にはベクトルユニットのスループットを初期デザインの8倍にしたほか、逆平方根の計算を行なうハードウェアを追加したとしている
ちなみにCloud TPU v2が64台のPodで11.5TFlopsとされているので、1台(つまり4チップ)あたり180TFlops、ダイ1個あたり45TFlopsという計算になる。
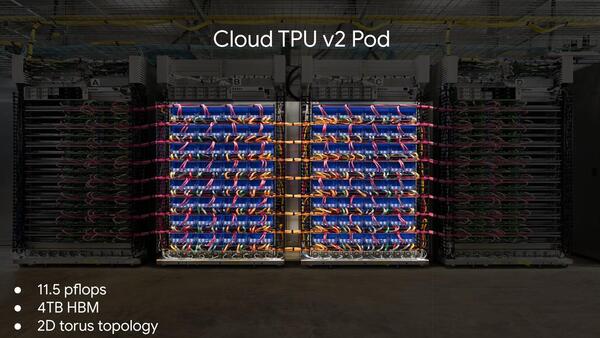
こちらはHot Chipsの論文より
Google TPU v2では先にも書いたがBfloat16/FP32で計算しているので、処理速度はチップ1つあたり45TOP/秒という計算になり、これはおおむね初代Google TPUの2倍の性能に相当する。
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第898回
PC
AI特化とは一線を画すHPCの怪物! 富士通「Monaka」が目指す3D積層と256bit SVE2の真価 -
第897回
PC
NVIDIA独自コア「Olympus」の真価 Vera CPUが見せたIPC全振りの重厚構造とメモリー帯域依存 -
第896回
PC
Arm自社設計「AGI CPU」の全貌、10-wideデコードと2ダイ構成で見せた優等生的な実力 -
第895回
PC
IBM ZがArmを取り込む衝撃! 次世代メインフレーム「z18(仮)」のネイティブDual-ISA戦略の狙い -
第894回
PC
AMD「Ryzen AI Embedded X100」のリアルタイムAI制御が、Jetsonの弱点であるCPU性能を突く -
第893回
PC
インテル製GPU「Crescent Island」の正体、容量480GBメモリーでエージェント型AIとKVキャッシュ問題に挑む -
第892回
PC
Hot Chipsで明かされた「Wildcat Lake」の全貌 Foverosを捨てMCPを選んだインテルの舞台裏 -
第891回
PC
謎多き次世代Xeon「Diamond Rapids」を解剖、3D Meshの進化と新命令セットAPXがもたらす変革 -
第890回
PC
Samsung「SF2P」の全貌! GAA最大の弱点であるPMOS性能低下を克服し、TSMC追撃へ準備万端 -
第889回
PC
なぜ巨大チップは歪んで壊れるのか? SK HynixのHBM4「MR-MUF」とTSMCのCoWoS-Lを襲う熱膨張の罠 -
第888回
PC
NVIDIA Rubin Ultra開発中止の真相! 180層CoWoS-Lの歪曲トラブルと、急造ラックNVL576に透ける苦肉の策 - この連載の一覧へ