

命令デコードでμOpに変換
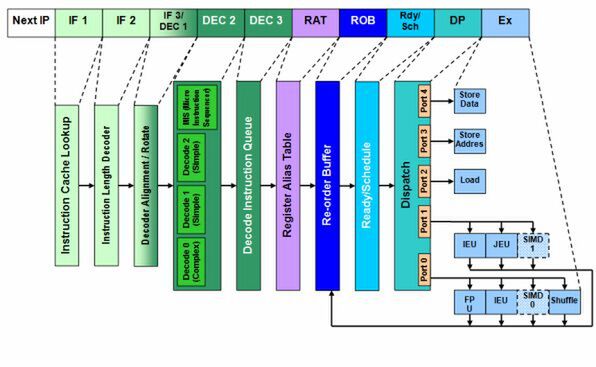
図1 Pentium Proの内部構造図
P6アーキテクチャーはIF2までに、最大で3つのx86命令を取り込む。取り込んだ命令を「μOp」に変換するのが、次のデコードである。μOpというのはようするに、「そのままの形でCPUが処理できる内部命令」と思えばよい。図1で「IF 3/DEC 1」となっている部分は、このステージの作業の半分がフェッチ、残りの半分はデコードに分類されるからである。
デコードの一番肝になる部分は、「DEC 2」のところである。ここには3種類4つのデコーダが用意されている。「Decode 0」は「Complex Decode」と呼ばれ、ひとつのx86命令を2つ“以上”のμOpに、「Decode 1/2」は「Simple Decode」と呼ばれ、ひとつのx86命令をひとつのμOpにそれぞれ変換する。例えば「メモリーにある2つのデータを足し算」という処理では、CPUは以下のような処理をすることになる。
- メモリーからデータ1をロードしてレジスタ1に格納
- メモリーからデータ2をロードしてレジスタ2に格納
- レジスタ1とレジスタ2の値を加算して、結果をレジスタ3に格納
元のx86命令では1命令で済むが、内部的には3命令相当になるわけだ。μOpというのは、この内部で行なわれる処理に1対1で対応する命令セットとなる。「CPU内部でRISC命令に変換」などと書かれることも多いが、これは元々のRISCの思想が内部命令に近いものだったからという話で、μOpが特にRISCを意識したわけではない。結果として「RISC命令に近いものになった」ということである。
インテルの資料によれば、レジスタ間の演算やデータ移動、あるいはメモリーからレジスタへのデータ移動は1μOpで済むが、メモリー/レジスタ間の演算やレジスタからメモリーへの移動は2μOp、レジスタ/メモリー間の演算になると、最大4μOpに変換される。ちなみに、図1のDEC 2にはもうひとつ、「Micro Instruction Sequencer」(MIS)と呼ばれるものがあるが、こちらはSimple DecodeやComplex Decodeでは対処できない複雑な命令を、マイクロコードベースで処理する部分だ。変換後のμOp数はいろいろだし、通常は1サイクルでは処理が終わらない。数十サイクルかかる場合もある。
DEC 2で変換されたμOpは、「DEC 3」の「Decoder Instruction Queue」にいったん格納される。これは続くRATのために、バッファにμOpを貯めておく必要があるためである。DEC 3では最大6つのμOpを格納できる。
アウトオブオーダーに欠かせない
レジスタ・リネーミング
DEC 3の後に入るのがRegister Alias Table(RAT)という処理だが、これは「レジスタ・リネーミング」という呼び名の方が通りがいいかもしれない。例えば以下のようなμOpが続いたとする。
- ① load R1, 1 (レジスタR1に1を代入)
- ② load R2, 2 (レジスタR1に2を代入)
- ③ add R1,R2 (レジスタR1とR2の値を加算して結果をR1に代入)
- ④ load R3, 3 (レジスタR3に3を代入)
- ⑤ load R2, 4 (レジスタR2に4を代入)
- ⑥ add R3,R2 (レジスタR3とR2の値を加算して結果をR3に代入)
この場合に問題になるのは、③の計算が終わるまで⑤の処理が始められないことだ。同じR2を使っているので、③が終わる前にR2を書換えてしまうと、③の結果がおかしくなってしまう。これを避けるための一番簡単な方法は、R2を使わないことである。
- ⑤’ load R4, 4 (レジスタR2に4を代入)
- ⑥’ add R3,R4 (レジスタR3とR4の値を加算して結果をR3に代入)
そこで(5)~(6)を上のように変えてしまえば、もはや⑤’は③の完了を待つ必要がない。R2は作業用に使っているだけなので、⑤のR2はR2でなくてもいいわけだ。
こうしてレジスタの干渉を解決すると、アウトオブオーダーで並行に処理を行なわせやすくなる。そのためアウトオブオーダーのCPUでは、利用できるレジスタを内部で大量に用意しておき、指定されたレジスタを適時切り替えることで、並行処理の効率をあげる仕組みが入っている。これがレジスタ・リネーミングあるいはRATと呼ばれる処理である。
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第894回
PC
AMD「Ryzen AI Embedded X100」のリアルタイムAI制御が、Jetsonの弱点であるCPU性能を突く -
第893回
PC
インテル製GPU「Crescent Island」の正体、容量480GBメモリーでエージェント型AIとKVキャッシュ問題に挑む -
第892回
PC
Hot Chipsで明かされた「Wildcat Lake」の全貌 Foverosを捨てMCPを選んだインテルの舞台裏 -
第891回
PC
謎多き次世代Xeon「Diamond Rapids」を解剖、3D Meshの進化と新命令セットAPXがもたらす変革 -
第890回
PC
Samsung「SF2P」の全貌! GAA最大の弱点であるPMOS性能低下を克服し、TSMC追撃へ準備万端 -
第889回
PC
なぜ巨大チップは歪んで壊れるのか? SK HynixのHBM4「MR-MUF」とTSMCのCoWoS-Lを襲う熱膨張の罠 -
第888回
PC
NVIDIA Rubin Ultra開発中止の真相! 180層CoWoS-Lの歪曲トラブルと、急造ラックNVL576に透ける苦肉の策 -
第887回
PC
AIなしではもはや限界 TSMCが明かすメモリー開発にAIが不可欠となった現実 -
第886回
PC
CFETの足を引っ張るPMOSを救え! imecが提案する新絶縁層と、あえて精度を緩める「Notch Alignment」の妙手 -
第885回
PC
TSMCも次世代「CFET」の全貌を披露! Forksheetスキップの背景と、世界最小6T SRAM実証で見えた2030年への布石 -
第884回
PC
Samsungが次世代CFETの試作に成功! IBMの10万ドル方式に対抗する、量産重視な「一括形成プロセス」のリアリティ - この連載の一覧へ