

5ポートの実行ユニットを装備
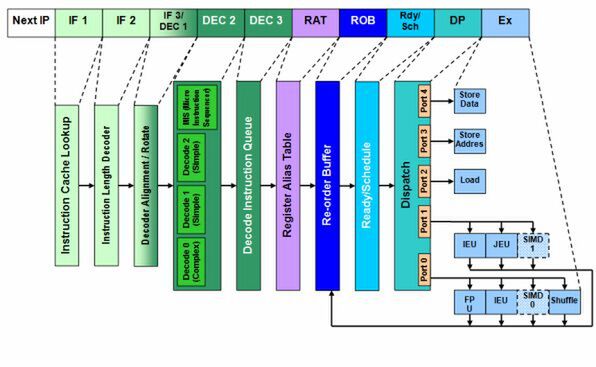
図1 Pentium Proの内部構造図
RATに続く処理が「Re-order Buffer」(ROB)である。これは名前のとおり、命令の並び替えと同時に、終了処理(Retirement)も行なう。ROBはようするに、「今どんな命令の処理を実行中か」の一覧を管理するステージである。ROBそのものはインオーダーであるが、これに続くReady/ScheduleからExecuteまではアウトオブオーダーで実行される。つまり「どの命令がいつ開始され、いつ終了するか」は、ROBにはわからない。
そこで「とにかく実行待機か実行中か、処理完了待ちかはわからないけど、投入はしたよ」という「実行中の命令一覧テーブル」(これをスコアボードと呼ぶ)を管理しているのがROB、ということになる。必然的にROBは、実行ユニットから「この命令の実行を終了したよ」という合図を受けて、その命令をスコアボードから落とす作業も担っている。
ROBから先がアウトオブオーダーでの処理ステージだ。ROBは「現在何μOpが投入されているか」(In-Flightと呼ぶ)を管理し、ゆとりがあるようならばμOpをどんどん追加していく。そうして追加されたμOpは、命令の依存関係などの理由によりすぐに実行できないケースもある。そうした場合に備えて、一時的に命令をプールしておくのが続くReady/Scheduleというステージで、これは一種のキューである。Ready/Scheduledでは最大20個のμOpを格納できる。
このキューから、順次命令を取り出して実行ユニットに振り分けるのが、続く「Dispatch」の処理である。P6の場合、Dispatchには「Port 0」から「Port 4」までの5ポートが用意されて、それらから複数の実行ユニットがぶら下がっている。一番多くの実行ユニットがぶら下がっているのが、Port 0と「Port 1」だ。この2つで整数演算処理やFPU、(Pentium II/III以降で追加された)SIMD演算や特殊命令などを、全部処理している。
1サイクルにひとつのポートから発行されるμOpは、ひとつだけだ。そのため「Load/Store」などのデータ移動「以外」の命令に関しては、Port 0と1の2ポートを使って、1サイクルあたり2命令というのがピーク性能ということになる。
一方Port 2~4は「ロードストアユニット」などと呼ばれることもあり、Port 2はメモリーから(キャッシュ経由で)データをロードして、それを内部レジスタに格納する。一方「Port 3」の「Store Address」は、データをメモリーに格納する際の、メモリーアドレスを計算するユニットである。この計算結果は、「Memory Order Buffer」(MOB、図1では省略)と呼ばれるユニットに渡される。最後のPort 4は「Store Data」で、実際にレジスタのデータをメモリーに格納する処理を行なう。こちらもいったんMOBにデータを格納してから、キャッシュ経由でメモリーに書き戻されることになる。
本来はこれ以外にも、分岐予測がどうなっているのかとか、MOBやRetirementがどうなってるのかなど、細かい話はまだまだある。だが、P6の基本的なアーキテクチャーはこんな構成になっている。x86からμOpsへの変換がある分だけ、デコード段がやや重厚であるが、それを除けばわりと「基本的なスーパースカラー・アウトオブオーダーなプロセッサー」という構成なのが、P6アーキテクチャーだったわけだ。
このP6アーキテクチャーが、続く「Pentium M」や「Core 2」ではどう変化していったのか、というあたりを次回で解説しよう。
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第893回
PC
インテル製GPU「Crescent Island」の正体、容量480GBメモリーでエージェント型AIとKVキャッシュ問題に挑む -
第892回
PC
Hot Chipsで明かされた「Wildcat Lake」の全貌 Foverosを捨てMCPを選んだインテルの舞台裏 -
第891回
PC
謎多き次世代Xeon「Diamond Rapids」を解剖、3D Meshの進化と新命令セットAPXがもたらす変革 -
第890回
PC
Samsung「SF2P」の全貌! GAA最大の弱点であるPMOS性能低下を克服し、TSMC追撃へ準備万端 -
第889回
PC
なぜ巨大チップは歪んで壊れるのか? SK HynixのHBM4「MR-MUF」とTSMCのCoWoS-Lを襲う熱膨張の罠 -
第888回
PC
NVIDIA Rubin Ultra開発中止の真相! 180層CoWoS-Lの歪曲トラブルと、急造ラックNVL576に透ける苦肉の策 -
第887回
PC
AIなしではもはや限界 TSMCが明かすメモリー開発にAIが不可欠となった現実 -
第886回
PC
CFETの足を引っ張るPMOSを救え! imecが提案する新絶縁層と、あえて精度を緩める「Notch Alignment」の妙手 -
第885回
PC
TSMCも次世代「CFET」の全貌を披露! Forksheetスキップの背景と、世界最小6T SRAM実証で見えた2030年への布石 -
第884回
PC
Samsungが次世代CFETの試作に成功! IBMの10万ドル方式に対抗する、量産重視な「一括形成プロセス」のリアリティ -
第883回
PC
TSMCのA16プロセスの詳細が判明! 性能向上の主因はトランジスタではなく裏面電源供給(SPR)にあり? - この連載の一覧へ