新清士の「メタバース・プレゼンス」 第183回
無料の画像生成AI「MiniMax H3-Image」はここがすごい Nano Bananaのようなモデルがローカルで動くのが当たり前に
2026年11月23日 07時00分更新


軽量化モデルでローカル生成も高速に
H3-Imageは、動画AIのH3から音声関連の層を取り除いた拡散トランスフォーマーです。331億のパラメータを持ち、テキストエンコーダーはH3のものをそのまま使う仕組みです。蒸留を通じて6ステップという少ない回数での生成を実現しており、高速化されています。プロンプトは最大4096トークンまで入力可能で、長く詳しく記述するほどよい結果が得られると発表されています。
気になるのはオープンウェイト版でしょう。
オープンウェイト版のモデル本体は、BF16で68.65GBある上に、テキストエンコーダーが別に66GBほどあるため、「RTX PRO 6000 Blackwell」などの超ハイエンドモデルでの動作を前提としています。もちろん、そのままでは一般向けビデオカードを搭載したPCでは動作しないため、Comfy-OrgからAIツール「ComfyUI」に対応した軽量化バージョン「pruned INT8-ConvRot」が登場しています。このモデルのサイズは21GBで、RTX 4090/5090で動作します。
さらに、コミュニティが作成した圧縮版としてQ5_K_M(13.9GB)、Q4_K_M(11.4GB)、Q3_K_S(8.8GB)も登場しており、VRAM容量が比較的小さいビデオカードを搭載したPCでも動作する環境が整っています。
筆者はINT8版を試していますが、H3-Imageの表現力は、写真やイラストなど、さまざまな条件で十分だと感じます。筆者のRTX A6000搭載PC(半導体は3090に相当)では、2Kでの生成時間は6秒、4Kでは12秒という結果でした。ただ、筆者には4Kが基本になっているように感じられ、同じプロンプトでは、2Kだと細部が溶けがちな印象を受けました。4Kを基本に考えるのがおすすめです。
ポーズリファレンスも、ControlNetを設定しなくても問題なく効きます。
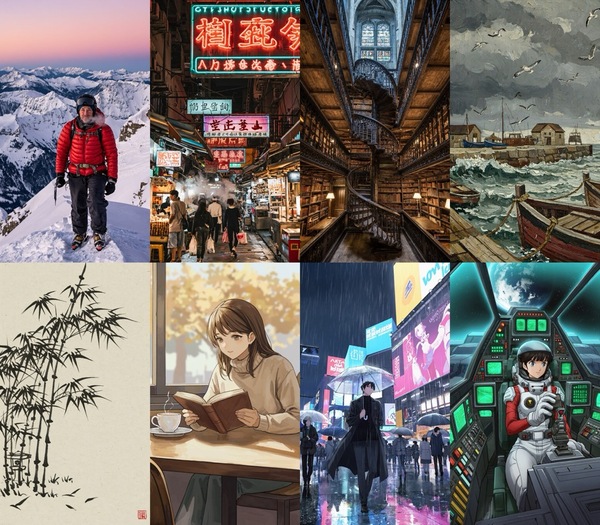
H3-Imageで生成したさまざまな画像
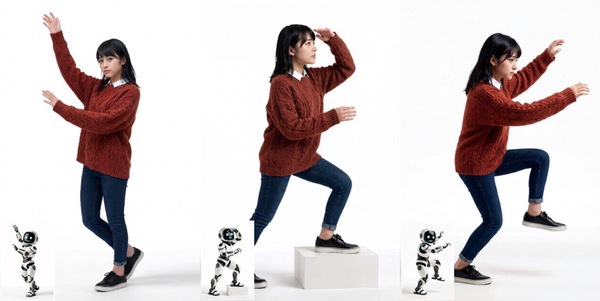
ポーズ参照例。ロボットの画像をSAM3Dで棒人間にして、それを参照画像としてポーズを取らせている
動画AIをベースとするモデルなので、一貫性を保ちながら、時間の経過に合わせて描き分けることも得意です。
例えば、明日来子さんがラーメンを食べている姿を生成した後(左上)、その30秒後に麺をすすろうとしているところ、1分後に麺を食べているところ、食べ終わったところ、といったプロンプトを組み合わせると、時間の経過を表す一連のシーンを作成できます。
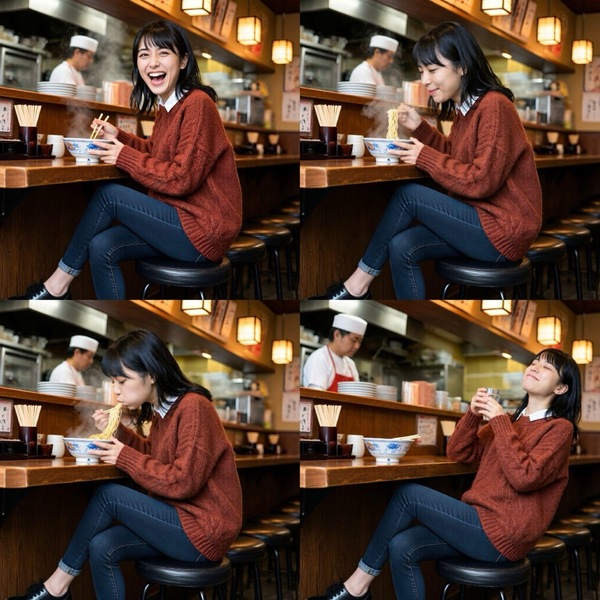
明日来子さんがラーメンを食べている連続シーン
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第182回
AI
10年間作れなかったアプリが、AIでわずか10日で完成して感動 好きなキャラが踊る3Dライブをついに実現 -
第181回
AI
無料の画像生成AI「P-H3-Image」がすごい 参照画像1枚で同じ人物を自在に再現 -
第180回
AI
“AI彼女”が別人になる前に──記憶と人格を自分のPCに移植する -
第179回
AI
無料の画像生成AI「Moss-Image」がすごい 日本語も漫画も生成、商用利用OKの実力を試した -
第178回
AI
GPT-4o級モデルが自宅のPCで動いた! ローカルAIの常識を変える「Strata」 -
第177回
AI
AIに「法隆寺の五重塔」を作らせてみた 修正を重ねてたどり着いた驚きの完成度 -
第176回
AI
無料ツールとAIでMV制作が激変 After Effectsまで自動操作できた -
第175回
AI
AIが人間のようにゲームをプレイ 話題の「Jev」を試してわかったこと -
第174回
AI
AIでMVを作るのは想像以上に大変だった 制作34時間、繰り返した“ダメ出し”でわかったこと -
第173回
AI
OpenAI「Astra」は何でもできる、だからこそ“プロの指示”が必要になる - この連載の一覧へ