

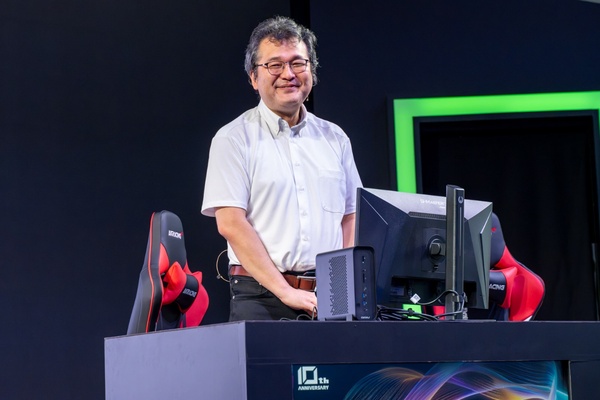
ASCII.jpの連載『新清士の「メタバース・プレゼンス」』でもおなじみの新清士氏(バリーン・スタジオ Creative Tech Lab./デジタルハリウッド大学大学院教授)が、「東京ゲームショウ2026(TGS2026)」のマウスコンピューターブースに登壇した。
テーマは「【DAIV×生成AI】ゲーム開発現場でのAI活用」。ステージには、マウスコンピューターの開発・購買本部 製品部でプロダクトマネージャーを務める林田奈美氏も同席し、クリエイター向けPC「DAIV CX」の実機を用いたローカルLLM(大規模言語モデル)の環境構築や、ゲーム開発の現場における実践的な活用法が語られた。
現在、ゲーム制作における生成AIの導入といえば、クラウド上のAPIやWebサービスを利用する形が主流だ。しかし新氏はこのステージで、あえて手元のマシン上でLLMを動かす「ローカル運用」の必然性と、それを成立させるハードウェアについて熱弁した。
なぜ今、ゲーム開発に「ローカルLLM」が必要なのか?
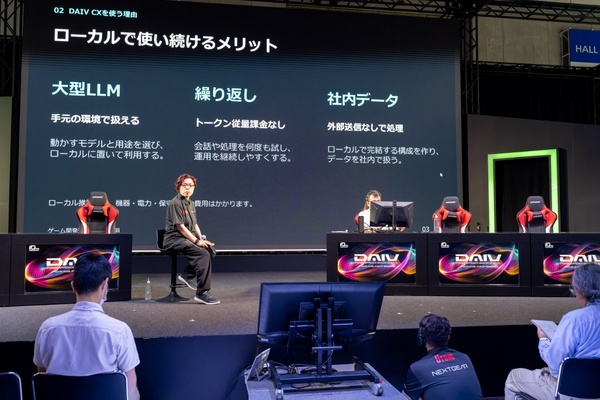
ステージ冒頭、新氏は現場がクラウド型AIを利用する際に直面している大きな課題として「情報漏洩リスク」と「利用コスト・制限」を挙げた。
未発表タイトルの企画書や世界観設定、キャラクターのバックストーリー、あるいはソースコードを外部サーバーに送信することには、セキュリティや法務上のハードルが常に付きまとう。また、開発サイクルの中で大量のテキスト生成やコード補完を反復する場合、従量課金のAPIコストやレートリミット(回数制限)もクリエイターの試行錯誤の手を止める要因だ。
これらを解決するのが「ローカルLLM」だ。PC内部でモデルを動かせばデータが外部に出る心配は一切なく、どれだけ大量のプロンプトを投げても追加コストはかからない。
もちろん、巨大なデータセンターで駆動するクラウド型LLMに比べれば、PC1台で動かすローカルLLMは動作が重く、生成速度やパラメータ規模には制約がある。しかし新氏は、「用途を限定して手元で動かす分には、十分に実用的なアウトプットが得られる時代になった。『Ollama』や『LM Studio』などのツールを使えば、誰でも簡単にオープンモデルを導入・動作させられる」と語り、クラウドとローカルを使い分けるハイブリッド運用の重要性を説いた。
ローカルLLM運用の最大の壁は「VRAM」
128GB中96GBを割り当てるAIならではの設定
新清士(しんきよし)氏が、リアルタイムでデモをしながらローカルLLMの活用について解説した
ローカル環境でLLMを動かす際、最大のボトルネックとなるのがVRAM容量だ。LLMはモデルを展開して推論をする際、膨大なVRAM容量を要求する。一般的なPC用グラフィックスカードのVRAMは、ハイエンド製品であっても16GB〜24GB程度が主流だ。しかし、ローカル環境で70B〜80Bクラスの大規模なLLMを実用的に動かしたり、長大なコンテキスト(文脈情報)を保持させたりするには、24GBでは到底足りない。
そこで今回のステージで実機デモとして持ち込まれたのが、マウスコンピューターの最新モデル「DAIV CX」(AMD Ryzen AI Max+ プロセッサー/AMD Radeon 8060S グラフィックス搭載機)だ。
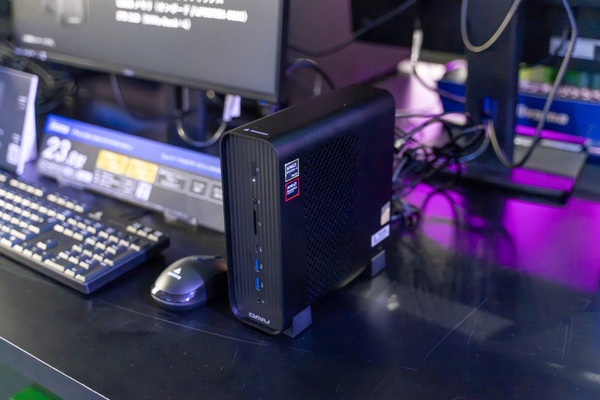
ブースに展示されている「DAIV CX」。デモでもこのマシンを使用していた。
最大の特徴は、搭載された128GBのメインメモリー(ユニファイドメモリー構造)のうち、最大96GBまでをVRAMとして割り当てられる点にある。VRAMとして利用可能な空きメモリーの広さは、扱えるコンテキスト長に直結する。80GBクラスのモデルを展開した場合でも、残りのメモリー領域で約26万コンテキスト(文庫本数冊分に相当)ものデータを保持可能であるという。
新氏は、「ローカルLLMツールが求めているのは、とにかく広大なVRAMです。通常なら数百万円クラスのワークステーションやサーバー用GPUを用意しなければ確保できないようなVRAM容量を、手元の一体型アーキテクチャで実現できます。ローカルLLM環境を本気で構築するなら、まさにこうしたマシンがベストな選択肢になります」と高く評価した。
実機デモ:ゲーム開発の現場を想定したローカル対話生成
ステージ上では、この96GBのVRAMを確保したDAIV CX実機を用いて、Windows上で軽快にローカルLLMを稼働させられるツール「LM Studio」などをベースに、3つの具体的な応用デモを実演した。
ローカルLLMと音声合成によるNPCリアルタイム対話
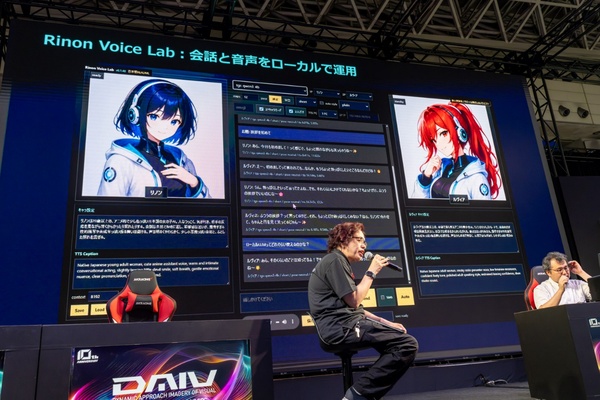
2人のキャラクターが与えられたお題に対してゆるく対話していた。
ステージで披露した1つ目のデモは、ローカルLLMと音声合成エンジン、さらには動画生成モデルを融合させた「自律対話型NPC(ノンプレイヤーキャラクター)」のリアルタイム実装である。
実機デモでは、対話性能に定評のあるGoogleのオープンモデル「Gemma」シリーズをLM Studio上で稼働させた。単にユーザーの入力に1対1で応答するだけでなく、バックグラウンドに音声合成エンジン(irodori-TTS等)を連携させ、それぞれ異なる性格やバックボーンを設定した2人のAIキャラクターを配置。プレイヤーの呼びかけをきっかけに、2人のキャラクター同士が直前の文脈や互いの発言を理解しながら、自律的かつリアルタイムに掛け合いを繰り広げるインタラクションを構築している。
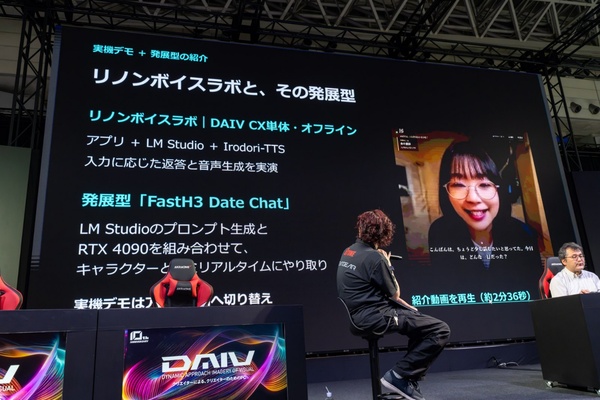
音声に合わせた口元と表情を実写に近い映像でリアルタイムに表現
さらにこの仕組みは、思考と対話生成を担うDAIV CXに、GeForce RTX 4090を搭載した高性能GPUマシンを連携させ、高速動画生成モデル(FastH3など)を用いた「リアルタイム実写動画・リップシンク連携」の実験的デモも公開された。LLMが発話内容と音声波形に合わせ、画面内の実写風キャラクターの口元や表情が動的にレンダリングされ、あたかも実在する人間とビデオ通話をしているかのような表現を可能にしていた。
現状、完全なミリ秒単位のリアルタイム同期にはさらなる技術進歩が必要であるものの、「アニメ調であれば口パクの多少のズレは許容されますが、実写風のCGや映像では表情と発話が完全に同期していなければ違和感が生じます。それがローカル連携でこれほど自然に動くのは驚異的だと思います」と林田氏が感心するほどのできだった。
ゲーム制作の現場を知る新氏は、「NPCの会話パターンや細かいフレーバーテキストの量産など、これまで人手では手が回らなかった細部の作り込みにこそ、気兼ねなく回せるローカルLLMが大きな威力を発揮する」と実感を込めて語っていた。
自作ゲームの自動プレイ・デバッグ&バランス調整
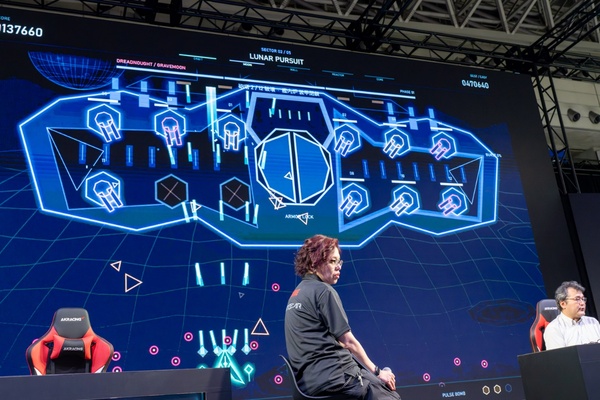
ゲームのデバッグをローカルLLMで実現。一晩中回しても、掛かるのは電気代だけ
2つ目のデモは、AIを活用したゲームデバッグおよびバランス調整の自動化。ここで取り上げたのは、筆者が制作した縦スクロール型シューティングゲーム『NeonSwarn』だ。敵の惑星に侵入し、巨大なボス戦艦と対峙する本格的なゲームだが、驚くべきことに筆者自身はプログラマーではなく、コードを一切自力では書かず「GPT-6 Astra」を活用して、わずか1時間足らずで構築したものである。
このゲーム本体の制作はローカルLLMでは厳しいが、その後のステージや難易度ごとのパラメータ調整、弾幕の抜け道チェック、予期せぬ挙動の洗い出しといったデバッグ作業には、何百回、何千回ものテストプレイを繰り返さねばならない。この過酷な反復作業こそ、DAIV CX上で稼働するローカルLLMの真価が発揮される領域だ。
ステージ上の実機デモでは、LM Studio上で稼働するLLMにゲーム画面の状況をリアルタイムに把握させ、自機の操作方針(「弾幕を回避するために端へ逃げる」「敵に接近して集中砲火を浴びせる」など)を数秒おきに自律判断させてプレイを継続させる仕組みを実演した。
一晩中何万回もテストプレイを回し続ければ、クラウド経由では一瞬にして天文学的なトークン費用が吹き飛んでしまう。これをDAIV CXのローカル環境にオフロードすれば、どれだけ膨大な試行錯誤を重ねても発生するコストは電気代のみ。しかも開発途中の未公開タイトルやソースコード、ステージ設計データが外部サーバーへ漏洩するリスクも排除できる。「設計はクラウド、反復デバッグはローカル」というハイブリッド構成こそが、開発リソースを引き上げる最適解なのである。
社内向け制作ハブ(画像・動画生成支援)
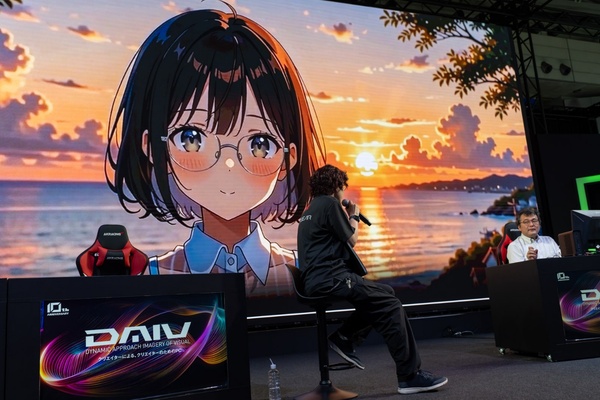
動画の生成も場面の指定を日本語でプロンプトを入力するだけ。場面転換もいける
3つ目は、バリーン・スタジオで運用を進めている制作基盤「百夜スタジオ」の構想を紹介した。DAIV CXを社内ハブとし、アーティストが入力したプロンプトをローカルLLMが解析・最適化して、画像生成(Krea 2など)や高品質な動画生成(FastH3など)の生成パイプラインへ引き渡され、直感的にアセットを生成・プレビュー・管理できる環境が整えられている。機密アセットを外部に出すことなく、数十人規模の開発チームが安全に活用できる制作環境を実現している。
実演されたワークフローでは、アーティストが参考となる画像を選択すると、DAIV CX上のローカルLLMがその画像を瞬時に分析。構図、色彩、ライティング、キャラクターの表情や質感といった要素を分解・言語化し、画像・動画生成AIに最適化された長文の英語プロンプトを自動生成する。アーティストは自然言語で微調整(「少しサイバーパンク風に」「表情をシリアスに」など)を指示するだけで、ローカルLLMがプロンプトのブレンドや再構成を代行し、狙いどおりのアセット生成へと導いてくれる。
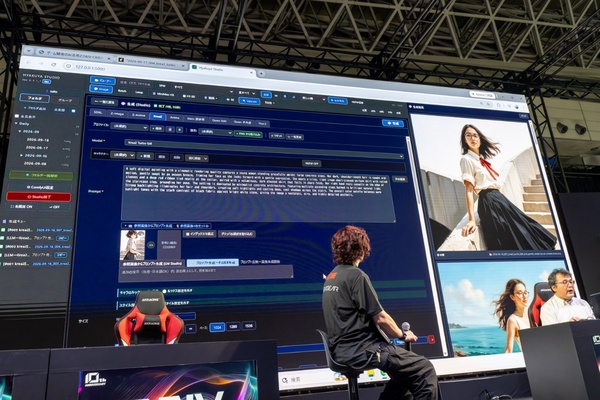
ベースとなるイラストに対して、ローカルLLMが分析。それに対して日本語で指示するだけでアレンジされた画像や動画が生成される
1台のDAIV CXをユーザー管理、プロンプト生成、LLM推論を受け持つ集中ハブとして配置し、重いレンダリング処理(動画・画像生成)を別系統のGPUマシンへ分散処理させるアーキテクチャを採ることで、中小規模の開発チーム全体が快適に協調作業を行える環境が低コストで構築可能となる。
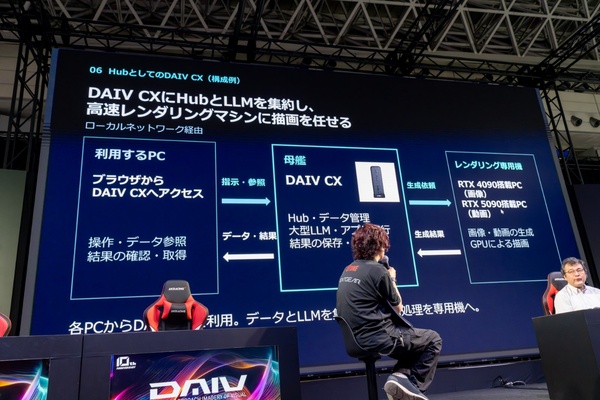
アーティストが誰でもブラウザ経由でアクセス。DIVEをハブとし、レンダリングは高性能マシンで行なうシステム
AIの登場で「PCのアーキテクチャ」が変わり始めた
マウスコンピューターの林田氏
マウスコンピューターの林田氏は、ハードウェアベンダーの視点から近年の劇的な変化について触れた。
「これまでのPC構成は、グラフィック処理のためにビデオカードを積み、アプリケーションのために大容量メモリーを積む、という役割分担が基本でした。しかし、大容量のユニファイドメモリーをCPU内蔵グラフィックスで扱い、大規模なLLMを動かすというDAIV CXのアプローチは、従来の常識とはまったく異なる新しいPCアーキテクチャの形です」と語った。
長年PCの製品企画に携わってきた林田氏自身、「PCはある程度完成された道具になったと思っていましたが、ここへ来て全く新しい進化の軸が現れたことにワクワクしています」と強い手応えを示していた。
「何に使えるかわからないから導入しない」のではなく、「答えが定まっていない今だからこそ、手元で自由に試行錯誤できる環境を持つこと」がクリエイターやスタジオの競争力を左右する。林田氏も指摘するように、AIの進化スピードと半導体需要を考慮すれば、ローカルAI環境への投資は早ければ早いほどアドバンテージになる。
新氏は、「生成AIを外部のブラックボックスとして使うだけでなく、手元のPCに“専属アシスタント”として常駐させる時代が来ている。機密を守り、コストを気にせずアイデアをぶつけられる環境として、大容量VRAMを扱えるDAIV CXのような新世代マシンは、これからのクリエイターにとって強力な武器になる」と語った。
機密性を完全に守りながら、コストを気にせず24時間いつでもアイデアをぶつけられるローカルLLM。その実用的な土台として、信頼性とパフォーマンスを兼ね備えたDAIV CXは、これからのゲーム制作やデジタルコンテンツ開発における頼もしい相棒となりそうだ。ブースでは、ローカルLLMのデモが見られるのでチェックしてほしい。
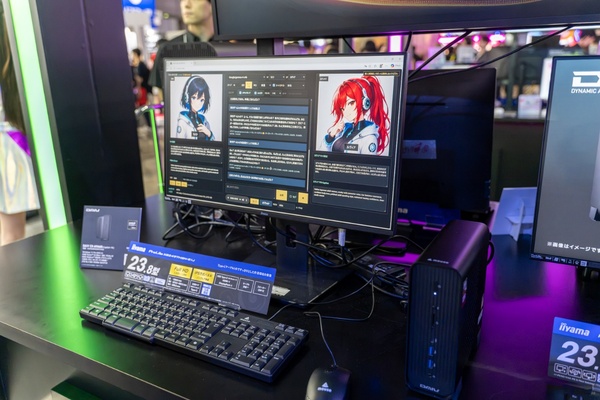
ブースに展示されている「DAIV CX」では、新氏が紹介したローカルLLMが動作している
本記事はアフィリエイトプログラムによる収益を得ている場合があります

-
トピックス
東京ゲームショウ2026、21日(月)は中止決定 20日(日)は予定どおり【TGS2026特集】 -
PC
ちぃたん☆が世界大会優勝のプロゲーマー・ときどに『スト6』で挑戦! 宇野昌磨はPCを抱えて氷上スピン【TGS2026特集】 -
PC
GALLERIAから登場の「ストリートファイター6」コラボモデルはオリジナルイラストをこだわってPCにデザインした注目製品【TGS2026特集】 -
PC
「ゲームも、クリエイティブも、AIも。」 日本のハイパフォーマンスPCの世界をリードする! GALLERIAがアピール【TGS2026特集】 -
トピックス
バンナムブースはガンダムで入場規制レベルの熱気! さすがの大盛況!【TGS2026特集】 -
トピックス
まさかのゲームで復活。『キャッ党忍伝てやんでえ』が2D横スクロール化【TGS2026特集】 -
トピックス
『空の軌跡 the 2nd』に登場する実物大の武器が大迫力! 本気で重い!【TGS2026特集】 -
トピックス
カプコンブースは裏手に回れ! Switch 2版『モンハンワイルズ』を遊びつつモンスターの“実物サイズ”に圧倒 -
トピックス
「ぶいすぽっ!」と『ストファイ6』コラボのレバーレスコントローラーが美しい……【TGS2026特集】 -
トピックス
モノクマ相手に「論破ッ!」『スーパーダンガンロンパ2×2』の世界で記念撮影できるぞ【TGS2026特集】