AI推論エンジンにDSPとプロセッサーを統合
さてそのQuadricが考える現在のAIプロセッサーの問題とは、純粋にAIの推論だけを考えればGraph Processorが処理に適しているわけだが、実際にはその前後にDSP(Digital Signal Processor)あるいは通常のプロセッサーが必要、という話である。
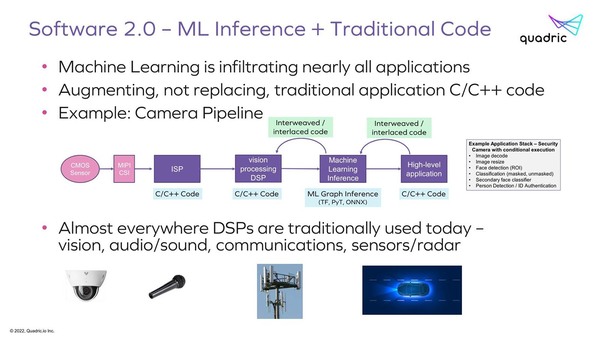
これは映像をAIで処理するような例だが、音声とか無線などでも構図は同じ、とする。まぁ実際同じである
そういうこともあって、純粋なAIのアクセラレーターはともかく、特にエッジ向けのAI推論向けプロセッサーは下の画像のような構成になっていることが多い。
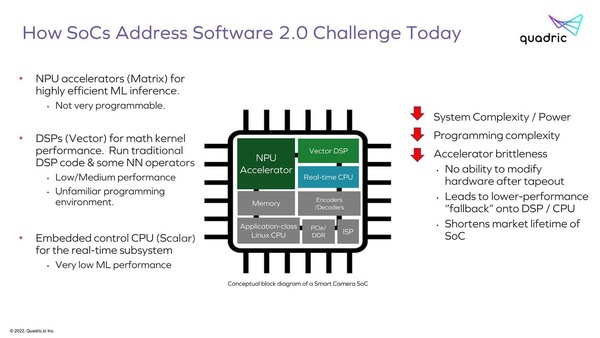
エッジ向けのAI推論向けプロセッサーの構成。ここでRealtime CPUとApplication-class Linux CPUの両方を持つかどうかはケースバイケース。通常Linuxなどが動くアプリケーションプロセッサーは別に用意するパターンの方が多いように思う
ただ当然こうした構成にすると、性能を確保しようとするとそれぞれのエリアサイズが肥大化するのでコスト上昇につながるわけで、コストを抑えるためには必然的に性能も抑える必要性がある。
「ではAI Inference EngineにDSPとRealtime Processorの機能を統合してしまえばいいのでは?」というのがGPNPU(General Purpose Neural Processor Unit)ことChimeraプロセッサーというわけだ。自分たちで“キメラ”と名付けるあたり、ある程度ゲテモノであることは理解してはいるのだろう。
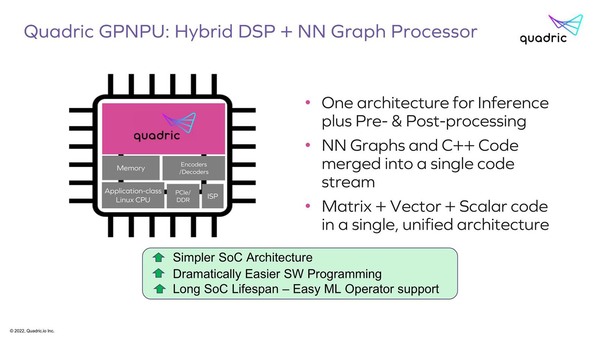
GPNPUの理論。「混ぜるな危険」一歩手前、という感じではある
そのChimeraの中身が下の画像だ。命令長が64bitというあたりは、おそらくはVLIWのような構成になっており、通常のMPU/DSP命令(上段)とArray Processor(下段)が同時に動作する、ということに見えなくもない。
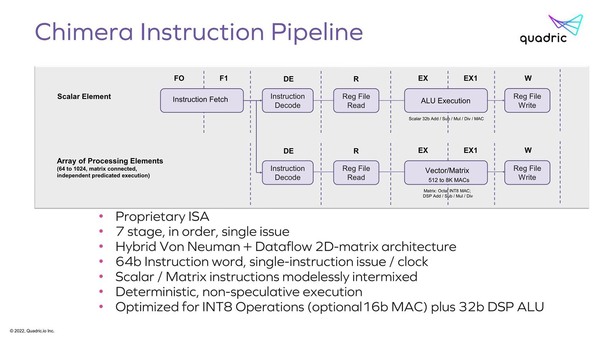
Chimeraの構造。ここまで分離してるなら、そもそも別のプロセッサーでいいのでは? というのが率直な感想だ
ただMatrixの方はデータフロー的に動くというあたりでもう理解ができなくなっている。データフローの場合、「普通は」すべてのProcessor Elementが独立して動くMIMD的な構成にするわけで(さもないとデータフローでなくなる)、あるいは実は64bitの命令といっても先頭にMPU/DSP命令か、Matrixかのbitが付いていて、Matrixの場合は即時実行するのではなく各MatrixのProcessor Elementに命令をロードするだけという可能性もあるのだが、パイプラインを見るとそれも違うように思える。
どう動くのかがさっぱり見えてこないあたりが困ったものだが、Chimeraの名に恥じない構成ではあると思う。下の画像がシステムの構成図であり、これだけ見ると良くある構成である。

上の画像にデータフローの文字がなければ、右のPEは単にSIMDのように動くベクトル・アクセラレーターと見なしてもよさそうではある
Scalar Elementからのライトバックだが、これもLocal Register Memoryから2次キャッシュへDMAエンジンが用意されており、これを利用して書き出す格好になる(このスライドでは省かれている)。
PE(Processing Elements)の方も同様に、Distributed LRM(Local Register Memory)にまずPEから書き出し、それがDMA経由で2次キャッシュにライトバックという順当な構成である。
ただそのChimeraを利用した場合の処理パスを見ると、例えばFace detectの出力はDistributed LRMから一度2次キャッシュに書き出され、NMSはもう一度2次キャッシュから今度はScalar Element側のLRMにデータを読み込んで処理をする、という少し複雑なパスを通ることになる。
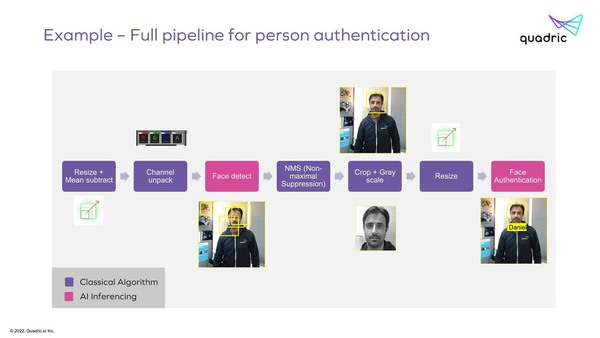
Chimeraを利用した場合の処理パス。ただこれも細かい話をすると、NMS以外の処理はハードウェアの専用ロジックにする方が普通だと思う
これ、素直にScalar ElementからDistributed LRMにアクセスできる(あるいはその逆)パスを用意できればもっとシンプルになりそうな気はするのだが、今度は内部構成が複雑になりすぎるのであえて諦めたのかもしれない。
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第897回
PC
NVIDIA独自コア「Olympus」の真価 Vera CPUが見せたIPC全振りの重厚構造とメモリー帯域依存 -
第896回
PC
Arm自社設計「AGI CPU」の全貌、10-wideデコードと2ダイ構成で見せた優等生的な実力 -
第895回
PC
IBM ZがArmを取り込む衝撃! 次世代メインフレーム「z18(仮)」のネイティブDual-ISA戦略の狙い -
第894回
PC
AMD「Ryzen AI Embedded X100」のリアルタイムAI制御が、Jetsonの弱点であるCPU性能を突く -
第893回
PC
インテル製GPU「Crescent Island」の正体、容量480GBメモリーでエージェント型AIとKVキャッシュ問題に挑む -
第892回
PC
Hot Chipsで明かされた「Wildcat Lake」の全貌 Foverosを捨てMCPを選んだインテルの舞台裏 -
第891回
PC
謎多き次世代Xeon「Diamond Rapids」を解剖、3D Meshの進化と新命令セットAPXがもたらす変革 -
第890回
PC
Samsung「SF2P」の全貌! GAA最大の弱点であるPMOS性能低下を克服し、TSMC追撃へ準備万端 -
第889回
PC
なぜ巨大チップは歪んで壊れるのか? SK HynixのHBM4「MR-MUF」とTSMCのCoWoS-Lを襲う熱膨張の罠 -
第888回
PC
NVIDIA Rubin Ultra開発中止の真相! 180層CoWoS-Lの歪曲トラブルと、急造ラックNVL576に透ける苦肉の策 -
第887回
PC
AIなしではもはや限界 TSMCが明かすメモリー開発にAIが不可欠となった現実 - この連載の一覧へ