PEをデータフローで動作させて高効率を実現
ちなみにそのPEがどうして効率的か? と言う説明はあった。下の画像は3×3の畳み込み演算の場合だが、まず隣接する4方向との間で演算の半分を行ない、次のサイクルで残り半分の演算ができる格好になる。
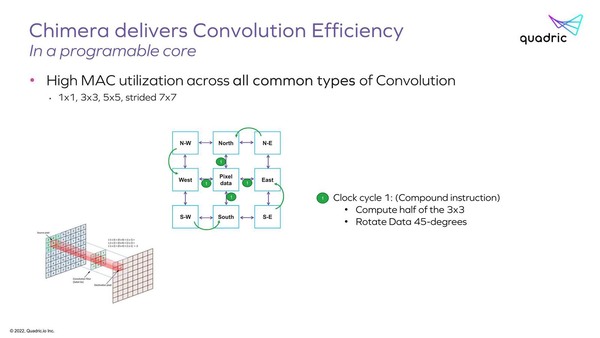
中央のPEと、その上下左右にあるPEの間で演算を行なう。一方斜め方向の4つのPEは、自分の保持するデータを隣りのPEに移動する
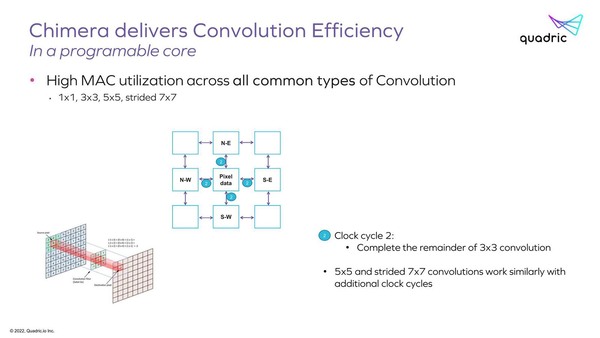
上の画像で行なった、元は斜め方向にあったデータの演算がこのサイクルで行なえる
結果、3x3の畳み込みが2サイクルで実施できるわけだ。同じ仕組みで、より大きなサイズの畳み込み演算も高効率で実現可能というのが同社の説明である。
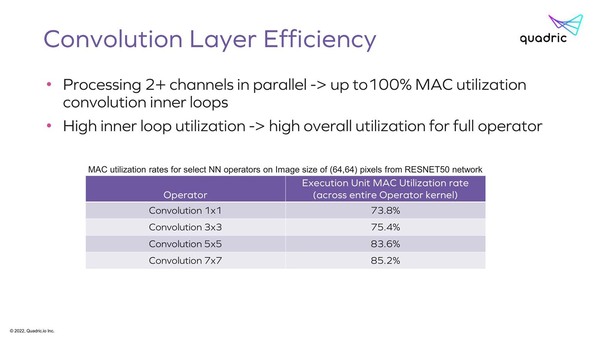
PEをデータフローで動作させるので、結果的に高効率が実現できるわけで、確かにこれを見る限りデータフローっぽい動作になっている
なお、メモリー回りで言えば、2次キャッシュを経由すると最大70倍の電力消費となるそうで、やはりDMAエンジンを経由してアクセスするのはそれなりにコスト増になるのは間違いない。
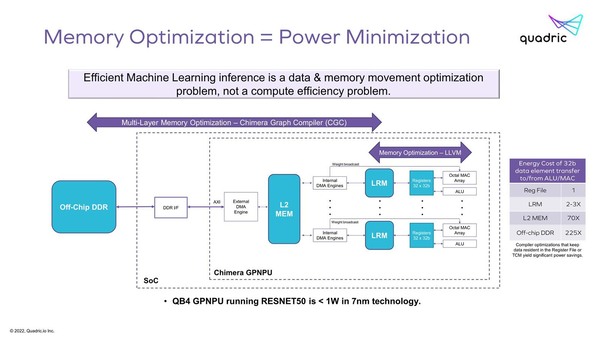
2次キャッシュを経由すると最大70倍の電力消費となる。右の数字はあくまでもデータアクセスの際の消費電力の比であって、速度の比ではないことに注意
でありながらもあえてこんな構成にしたのは、例えばすべてのLRMをファブリックでつなぐような構成にすると、そのほうが複雑さが増し、回路規模が増え消費電力が増えるという判断だったのかもしれない。
後述するQB4の構成では、RESNET-50動作時の消費電力を1W未満に抑えたというあたり、性能と消費電力、複雑さに関してのバーターとしてこの構成になった、と考えるのが妥当なのかもしれない。
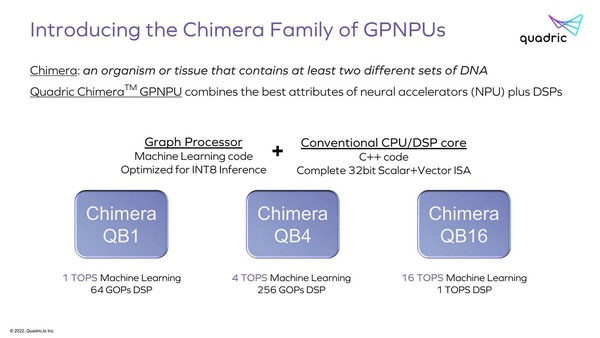
QB1が64PE、QB4が256PE、QB16が1024PEという構成になっているようだ。逆に言うとScalar Elementの方は構成が同じ模様
Chimera GPNPUはこのPEの数でQB1~QB16まで3つのラインナップが用意されている。すでにQB4構成に関しての試作チップは存在しており、ラスベガスで開催されるCES 2023に合わせて来年1月5日と1月6日にブースでデモを行なうとしている。
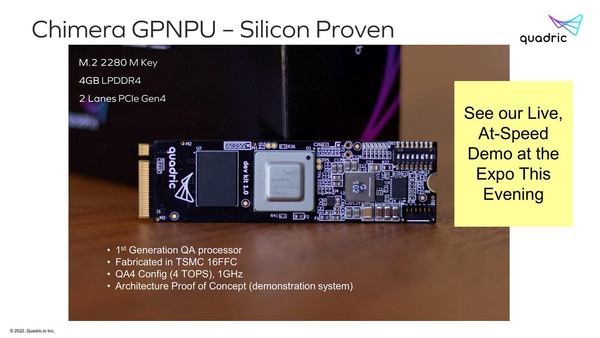
2つ上の画像では7nmで1W未満という説明だったが、この試作チップはTSMCの16FFCの製造とされており、7nmの方は推定値なのかもしれない
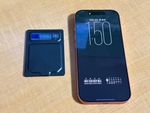
また同社は製品だけでなくIPライセンスの形での提供も考えているそうだ。この試作チップはM.2の2280サイズに収まっており、いわゆるエッジ向けAI推論プロセッサーと同じ感じになっている。
この製品版の方は2023年第1四半期中に準備が整うようで、仮にここから量産を始めると第2四半期あたりに最初の量産チップが出てくる格好だろうか。すでにSDKの提供はスタートしており、またLLVM C++コンパイラおよび命令セットシミュレーターも限定的にだが提供を開始しているようだ。
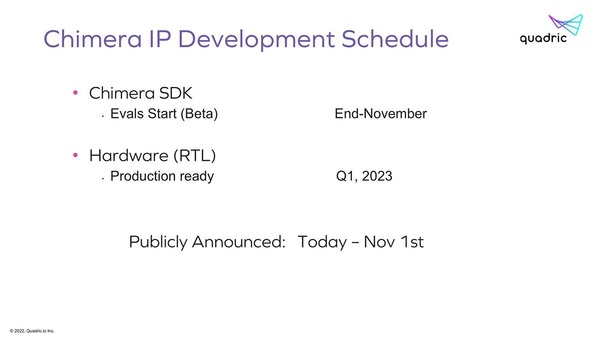
この量産チップのプロセスは未公表。7nmあたりに思えるが、このあたりは価格とのご相談の面もある
根本的なところで、ChimeraをChimeraたらしめている、Scalar ElementとMatrix Elementの謎のパイプライン構造の意味はわからないし、QA4構成で1GHz駆動では4TOPSというのは、性能として低くはないが高くもないという微妙なところである。
とはいえかなりおもしろいプロセッサーではあり、果たしてどこまでマーケットが取れるのか見守りたいところだ。
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第897回
PC
NVIDIA独自コア「Olympus」の真価 Vera CPUが見せたIPC全振りの重厚構造とメモリー帯域依存 -
第896回
PC
Arm自社設計「AGI CPU」の全貌、10-wideデコードと2ダイ構成で見せた優等生的な実力 -
第895回
PC
IBM ZがArmを取り込む衝撃! 次世代メインフレーム「z18(仮)」のネイティブDual-ISA戦略の狙い -
第894回
PC
AMD「Ryzen AI Embedded X100」のリアルタイムAI制御が、Jetsonの弱点であるCPU性能を突く -
第893回
PC
インテル製GPU「Crescent Island」の正体、容量480GBメモリーでエージェント型AIとKVキャッシュ問題に挑む -
第892回
PC
Hot Chipsで明かされた「Wildcat Lake」の全貌 Foverosを捨てMCPを選んだインテルの舞台裏 -
第891回
PC
謎多き次世代Xeon「Diamond Rapids」を解剖、3D Meshの進化と新命令セットAPXがもたらす変革 -
第890回
PC
Samsung「SF2P」の全貌! GAA最大の弱点であるPMOS性能低下を克服し、TSMC追撃へ準備万端 -
第889回
PC
なぜ巨大チップは歪んで壊れるのか? SK HynixのHBM4「MR-MUF」とTSMCのCoWoS-Lを襲う熱膨張の罠 -
第888回
PC
NVIDIA Rubin Ultra開発中止の真相! 180層CoWoS-Lの歪曲トラブルと、急造ラックNVL576に透ける苦肉の策 -
第887回
PC
AIなしではもはや限界 TSMCが明かすメモリー開発にAIが不可欠となった現実 - この連載の一覧へ