AMDやNVIDIAのGPUに近い内部構造
さてそのBR100の内部構造が下の画像だ。それぞれのダイには16個のSPC(Streaming Processing Cluster)が搭載され、それとは別にHBM2eのI/F×2とPCIe I/F、BLink I/F、そしてなぜかビデオエンコーダー/デコーダーが搭載されている。
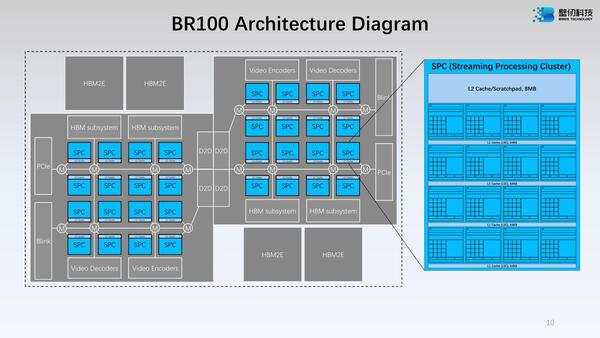
BR100の内部構造。L2の“Build-in reduction engine”に関しては最後のスライドで説明する。またSPCの内部のEUの数は4/8/16と変更できるらしい(動的に、という意味ではなく将来は下位グレードの製品を作り分けられる、という意味)
今回このエンコーダー/デコーダーの詳細は公開されていないが、製品ページによれば1ダイのBR104は32ch H.264/HEVCエンコーダーと256ch H.264/HEVCデコーダー(どちらもFHD@30fps)、2ダイのBR104はそれぞれ64ch/512chとなっている。それなりに強力には見えるが、4K@30fps相当で考えればBR104が8ch/64ch、BR100が16ch/128chという計算で、コンテンツ配信ネットワーク向けにはもう少し性能が欲しい感じもする。
話を本体に戻すと、個々のSPCの内部には16個のEUが含まれている。個々のEUには16個のV-Coreと1個のT-Coreが含まれている格好だ。V-Coreは通常のVectorというかSIMD演算ユニット、T-CoreはMatrix演算ユニットに相当すると考えるのが正しいところだろう。
ただ演算はSIMDというよりはSIMT的な動作のようで、複数のスレッドをWarpという単位で管理しているあたりは、AMDやNVIDIAのGPUに近いと言える。ちなみにT-Coreとは別にTDA(Tensor Data Accelerator)が搭載される。
あと、1つのSPC(=16EU)ごとに8MBの2次キャッシュが搭載されるとしている。ということは、ダイ全体で言えば128MBの2次キャッシュが搭載されている格好で、これはかなり巨大である。
個々のV-Coreの説明が下の画像だ。といっても概念的な部分であって、肝心の演算ユニットの詳細などは明らかにされていない。やや意外だったのは、V-CoreはINT 8をサポートしないことで、INT16/32とFP16/32のサポートのみである。また32SPCで最大128Kスレッドをサポートというのもすごい数字であって、つまり1個のSPCあたり4Kスレッドを扱えるという話である。
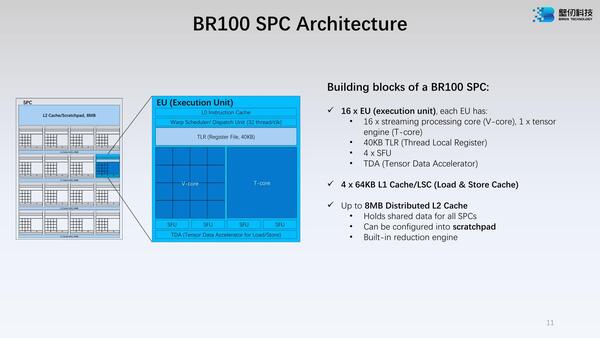
TLR(Thread Local Register)の40Kは、普通に考えると十分なのだが、1つのEUで4Kスレッドを扱うことを考えると、もう少し大きくても良いような気もする。多少大きくしたところでスレッドの入れ替えが煩雑に行なわれると結局TLRの入れ替えも煩雑にならざるを得ないから、割り切ったのかもしれない
1 Warpがどの程度のスレッドを扱えるのか不明だが、普通に考えればEUの数に合わせるのが妥当で1 Warp=16スレッドということになるのだが、実は後述するように32スレッドになっている。
ということは128個のWarpを1つのEUでハンドリングできることになるのだが、少しこれは多くないだろうか? という気もしなくはない。またV-Coreはスタティック及びダイナミックなスーパースカラーを実装、というのも不思議な部分だ。
スタティックの方はともかく、ダイナミックなスーパースカラーといっても、そもそもスーパースカラー的になにを動かすのか? が今1つわからない 。
可能性としてあるのは、下の画像を見るとLSU(Load/Store Unit)が存在していない。思うに個々のV-CoreにはINT/FPの演算ユニットとLSUがそれぞれ搭載しており、この演算ユニットとLSUが個別に動作可能なのでスーパースカラーと言っているような気がする。
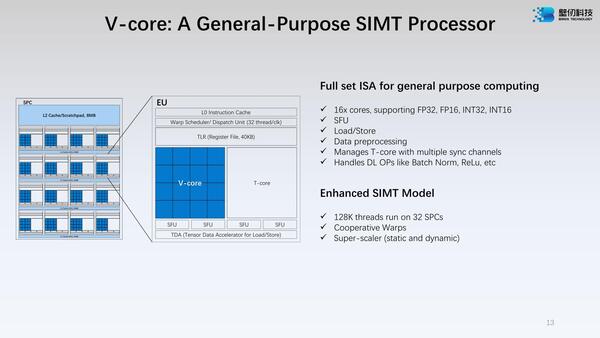
SFU(Special Function Unit)は活性化関数の類をまとめて処理するものに見える
ちなみにこのWarp、必要に応じて中でダイナミックに動作を切り替えられるとしている。下図右側の構成は珍しいというか、プログラミングの難易度が上がりそうな気がする。
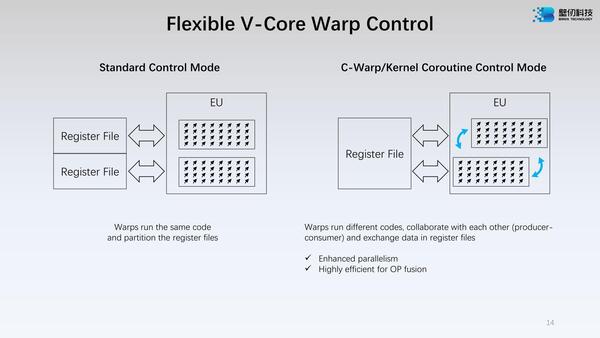
これを見る限り、1 Warpは32スレッドに見える。ということは、EU内の個々のV-coreは、それぞれ2スレッドを同時に実行できるような構図なのか、それとも複数サイクルで2スレッドを処理するのか、どちらなのだろう?
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第894回
PC
AMD「Ryzen AI Embedded X100」のリアルタイムAI制御が、Jetsonの弱点であるCPU性能を突く -
第893回
PC
インテル製GPU「Crescent Island」の正体、容量480GBメモリーでエージェント型AIとKVキャッシュ問題に挑む -
第892回
PC
Hot Chipsで明かされた「Wildcat Lake」の全貌 Foverosを捨てMCPを選んだインテルの舞台裏 -
第891回
PC
謎多き次世代Xeon「Diamond Rapids」を解剖、3D Meshの進化と新命令セットAPXがもたらす変革 -
第890回
PC
Samsung「SF2P」の全貌! GAA最大の弱点であるPMOS性能低下を克服し、TSMC追撃へ準備万端 -
第889回
PC
なぜ巨大チップは歪んで壊れるのか? SK HynixのHBM4「MR-MUF」とTSMCのCoWoS-Lを襲う熱膨張の罠 -
第888回
PC
NVIDIA Rubin Ultra開発中止の真相! 180層CoWoS-Lの歪曲トラブルと、急造ラックNVL576に透ける苦肉の策 -
第887回
PC
AIなしではもはや限界 TSMCが明かすメモリー開発にAIが不可欠となった現実 -
第886回
PC
CFETの足を引っ張るPMOSを救え! imecが提案する新絶縁層と、あえて精度を緩める「Notch Alignment」の妙手 -
第885回
PC
TSMCも次世代「CFET」の全貌を披露! Forksheetスキップの背景と、世界最小6T SRAM実証で見えた2030年への布石 -
第884回
PC
Samsungが次世代CFETの試作に成功! IBMの10万ドル方式に対抗する、量産重視な「一括形成プロセス」のリアリティ - この連載の一覧へ