

ロードマップでわかる!当世プロセッサー事情 第579回
Tiger Lakeの内蔵GPU「Xe LP」は前世代のほぼ2倍の性能/消費電力比を実現 インテル GPUロードマップ
2020年09月07日 12時00分更新


GPUは1チップ構成だが
GPGPU用途ではマルチチップ構成を想定
Media Sliceは動画のエンコード/デコードを担当するユニットだが、コーデックをダブル搭載できるとか、SFCを複数実装できるあたりが拡張機能となる。後で出てくるXe SG1は、このMedia Sliceが重要なポイントだという説明であった。
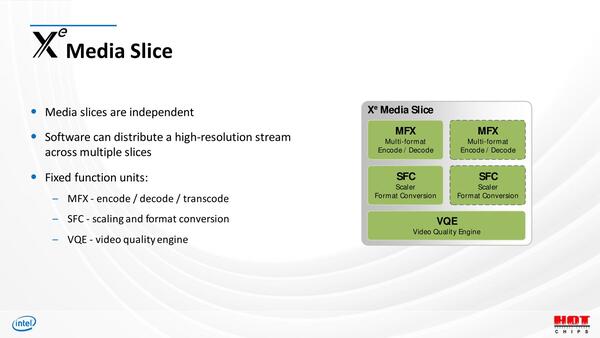
とはいえ無尽蔵に、例えばMFXやSFCを3つや4つに増やすことはできない模様。そういう場合はMedia Sliceそのものを増やす形で対応すると思われる
Memory Fabricは、これもさまざまなオプションが用意されている。通常はまず3次キャッシュが使われるが、HPC向けにはここにRambo Cacheが充てられることになるようだ。
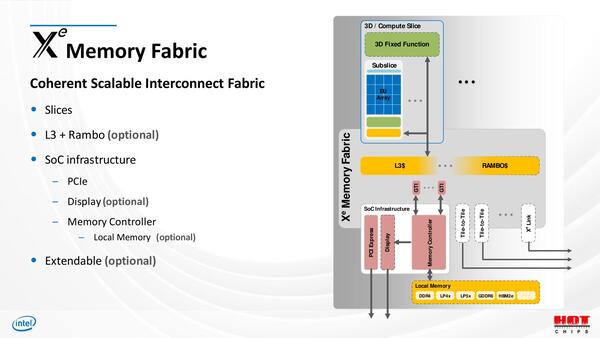
Memory Fabricの説明。SoCからPonte Vecchioまで、基本構造は同じとなると、当然こういうなんでもありの構成になる。ただ現実問題としてSoCとPonte Vecchioでは扱うデータ量が桁違いなので、内部のインターコネクトも当然帯域が大きく変わるわけで、実際には基本的な設計図が同じだけで、実装はだいぶ違ったものになっていると思われる
PCI Expressは当然として、ここにLocal MemoryやXe Link/Tile-to-Tile I/F、さらにDisplay Unitなどがオプションで追加される形になる。
ちなみにスケーリングであるが、ことGPU(つまりグラフィック向け)に関して言えば、昨今ではマルチチップ構成はあまり好まれない。これは連載515回でNAVIのRB(Render Backend)の説明でも触れたが、Deferred Renderingを多用する場合、多数のEUから同一のメモリーエリアに対してアクセスが頻発することになる。
NAVIの場合はこれを1次キャッシュでカバーしているわけだが、仮にマルチチップになるとRBがアクセスしようとしたメモリー(の内容を保存しているキャッシュ)が別のタイルにあるかもしれない。そうすると、アクセスが猛烈に遅くなる。
これもあってマルチチップの技法はAMD/NVIDIAともに採用しておらず、インテルもやはりXe LPやXe HPGでは1チップ構成で済ますようだ。
一方でGPGPU的に利用されるXe HP/Xe HPCの場合は並列度を上げても有効に使いやすく、またRBみたいなニーズも薄いことから、マルチチップ構成を積極的に追及する方向のようで、EMIBを利用した最大4Tileのパッケージや、マルチパッケージの接続が想定されている。

連載569回で説明した、Raja氏が手に持っているものが、このTile方式で接続されたものと思われる
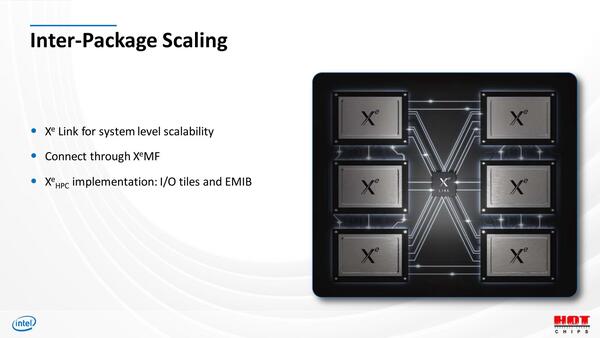
NVIDIAのNVLINKやAMDのInfinityFabricに相当するのがこちら。XeLinkという名前になる模様。ちなみにここでは6パッケージが接続されているが、これが最大かどうかは不明
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第894回
PC
AMD「Ryzen AI Embedded X100」のリアルタイムAI制御が、Jetsonの弱点であるCPU性能を突く -
第893回
PC
インテル製GPU「Crescent Island」の正体、容量480GBメモリーでエージェント型AIとKVキャッシュ問題に挑む -
第892回
PC
Hot Chipsで明かされた「Wildcat Lake」の全貌 Foverosを捨てMCPを選んだインテルの舞台裏 -
第891回
PC
謎多き次世代Xeon「Diamond Rapids」を解剖、3D Meshの進化と新命令セットAPXがもたらす変革 -
第890回
PC
Samsung「SF2P」の全貌! GAA最大の弱点であるPMOS性能低下を克服し、TSMC追撃へ準備万端 -
第889回
PC
なぜ巨大チップは歪んで壊れるのか? SK HynixのHBM4「MR-MUF」とTSMCのCoWoS-Lを襲う熱膨張の罠 -
第888回
PC
NVIDIA Rubin Ultra開発中止の真相! 180層CoWoS-Lの歪曲トラブルと、急造ラックNVL576に透ける苦肉の策 -
第887回
PC
AIなしではもはや限界 TSMCが明かすメモリー開発にAIが不可欠となった現実 -
第886回
PC
CFETの足を引っ張るPMOSを救え! imecが提案する新絶縁層と、あえて精度を緩める「Notch Alignment」の妙手 -
第885回
PC
TSMCも次世代「CFET」の全貌を披露! Forksheetスキップの背景と、世界最小6T SRAM実証で見えた2030年への布石 -
第884回
PC
Samsungが次世代CFETの試作に成功! IBMの10万ドル方式に対抗する、量産重視な「一括形成プロセス」のリアリティ - この連載の一覧へ