

ロードマップでわかる!当世プロセッサー事情 第894回
AMD「Ryzen AI Embedded X100」のリアルタイムAI制御が、Jetsonの弱点であるCPU性能を突く
2026年09月21日 12時00分更新


Hot Chips 2026の紹介の途中であるが、今回は中断させていただく。8月27日と28日にAMDは都内のホテルでECS(Embedded Computing Summit) 2026を開催して、フィジカルAI戦略の説明や、これに向けたソリューションの展示などを行なった。
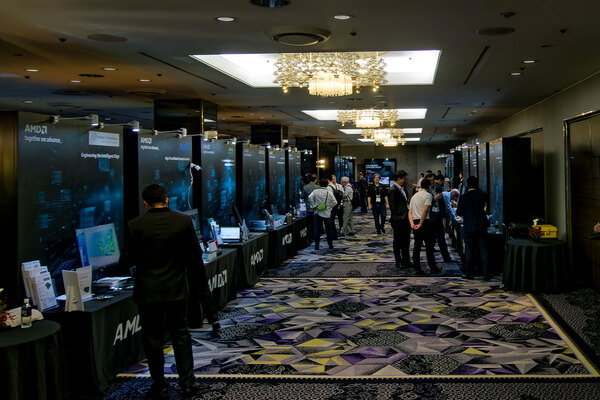
テクニカルセッション会場の外に設けられたデモブースの様子。左のデモブースの裏にも別のブースが並んでいた
ちなみに27日はVivadoというツールを使うワークショップのみが開催され、本番は28日だが、10時からスタートして17時10分終了で、しかも午後は4セッションが同時開催されるという結構ハードなもので、しかもいくつかのセッションでは秘密保持契約の締結が必要という本格的なものになっていた(アジェンダはこちら)。
要するにガチの開発者向けのイベントだったわけだが、それを全部レポートするのはさすがに無理がある。そこで基調講演の内容を踏まえて、現在のAMDのフィジカルAIに向けた取り組みを説明しよう。
なぜいまフィジカルAIなのか?
従来ソリューションの課題とオーバーヘッド削減
そもそもフィジカルAIってナニ? であるが、AIを利用して物理的な制御を行なわせよう、というものである。例として適切かどうかは難しいが、ウクライナ戦争におけるドローンの進化はまさしくフィジカルAIの典型例である。
ウクライナ軍は最初、無線を利用して遠隔地からオペレーターが操作する形でドローンを反撃に使っていた。ところが広帯域の電波妨害に遭遇し、電波の利用を止め、光ファイバーでつなぐ形に進化した。ただこれも光ファイバーを切断されたら終わりだし、光ファイバーで数百キロもの距離を飛ばすわけにもいかない。
そもそも100kmもの距離になると、その信号の伝達遅延だけで0.5msほどのディレイが発生する。光ファイバー内の光の速度はおおむね光速の3分の2に落ちるからだ。つまりドローンからの信号を受け取り、それをもとに操作信号を送るとなると、その信号の往復だけで1msを要する。
このディレイは距離が長くなるほど増えるので、100km範囲は(光ファイバーをどうするのかを別にすれば)まだ可能だが、1000km以上になるとこのディレイは操作を困難にする。そこでドローンの遠隔操作を諦め、代わりに自律式に制御させよう、という話になる。
昔は慣性航法装置、今ならGPSを使って目的地まで自動的に飛行をさせるが、ここにAIを組み合わせて敵の迎撃を回避したり、目的地までの間に探知されないような飛行経路を取る、あるいは目的地からターゲットを識別するといった処理をAIに任せることで、より賢明な攻撃が可能になる。
あくまでこれは一例であるが、センサーからの情報をもとにローカルで制御する機器は非常に多いし、そこにAIを統合するアイディアは昨今のAIの性能向上を考えれば非常に合理的である。こうしたこともあって、AMDは2035年のフィジカルAI向けチップ市場が2000億ドルに達すると見込んでいる。
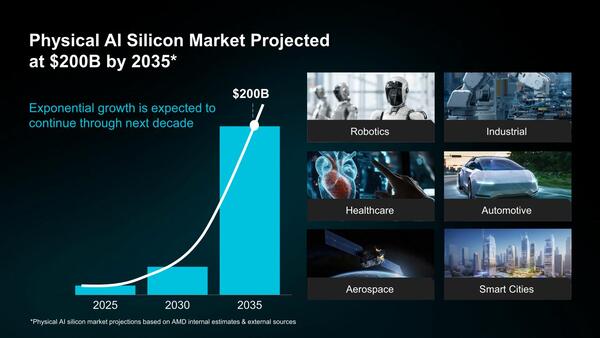
2035年には、フィジカルAI向けチップ市場が2000億ドルに達する。いわゆるTAM(Total Available Market)の推定額である
次にフィジカルAIを実現するために必要な要件はなにか? になる。そもそもフィジカルAIは先に述べたように、センサーなどの情報を解析して、次にどう動くべきかを判断し(ここでAIが使われる)、その判断をもとにモーターなりアクチュエーターなり、あるいはそれ以外のデバイスを駆動する流れになる。この制御ループをどれだけ迅速に回せるかがカギになる。
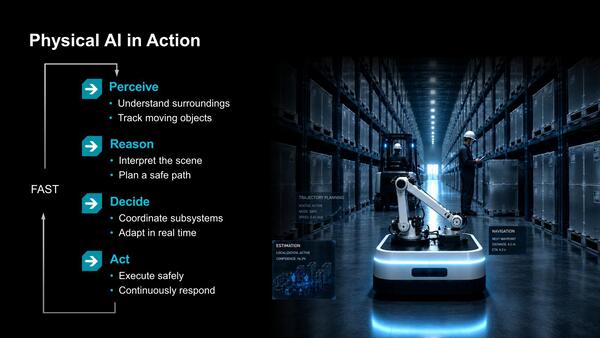
ここでは認識→推論→決定→行動と4段階に分割されているが、中身は同じだ
さて、ここからが本題である。従来のフィジカルAI向けのソリューションは、小型のものではMCU、大型のものならMPUに外付けする形でNPUなりGPUを構築するというケースが多かった。
外付けのプロセッサーでフィジカルAIを実装しようとすると、CPUとGPUなりNPUの間で煩雑にやり取りをする際のオーバーヘッドが非常に大きくなりがちであり、これが制御ループを高速化する際の妨げになっていた。
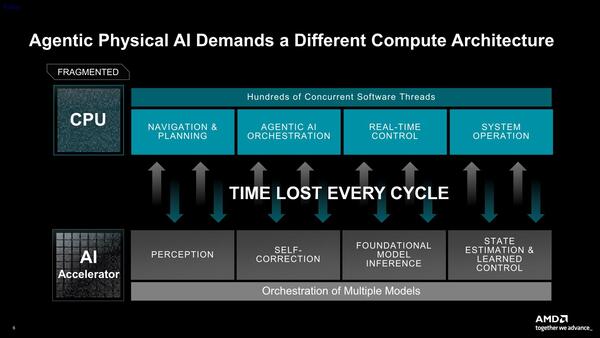
従来の構成ではPCI Express(や、MCU向けではSPIなどの低速なI/F経由の場合もある)経由で処理の実行や結果の受け取りをする格好だが、これの通信のオーバーヘッドがシャレにならない。このスライドの"TIME LOST EVERY CYCLE"がやり取りにあたる部分だ
そこでAMDはフィジカルAIの市場に、NPUとCPUが統合されたUnified Memoryのアーキテクチャーを導入することで、オーバーヘッドを削減できると主張している。
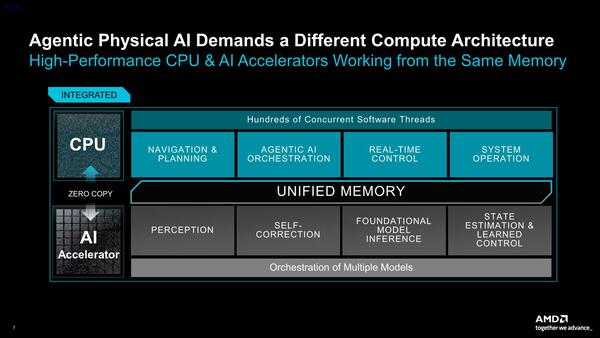
フィジカルAIに、NPUとCPUが統合されたUnified Memoryを導入すると、オーバーヘッドを削減できるという。GPUも同じくUnified Memoryを共有する形になっている
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第893回
PC
インテル製GPU「Crescent Island」の正体、容量480GBメモリーでエージェント型AIとKVキャッシュ問題に挑む -
第892回
PC
Hot Chipsで明かされた「Wildcat Lake」の全貌 Foverosを捨てMCPを選んだインテルの舞台裏 -
第891回
PC
謎多き次世代Xeon「Diamond Rapids」を解剖、3D Meshの進化と新命令セットAPXがもたらす変革 -
第890回
PC
Samsung「SF2P」の全貌! GAA最大の弱点であるPMOS性能低下を克服し、TSMC追撃へ準備万端 -
第889回
PC
なぜ巨大チップは歪んで壊れるのか? SK HynixのHBM4「MR-MUF」とTSMCのCoWoS-Lを襲う熱膨張の罠 -
第888回
PC
NVIDIA Rubin Ultra開発中止の真相! 180層CoWoS-Lの歪曲トラブルと、急造ラックNVL576に透ける苦肉の策 -
第887回
PC
AIなしではもはや限界 TSMCが明かすメモリー開発にAIが不可欠となった現実 -
第886回
PC
CFETの足を引っ張るPMOSを救え! imecが提案する新絶縁層と、あえて精度を緩める「Notch Alignment」の妙手 -
第885回
PC
TSMCも次世代「CFET」の全貌を披露! Forksheetスキップの背景と、世界最小6T SRAM実証で見えた2030年への布石 -
第884回
PC
Samsungが次世代CFETの試作に成功! IBMの10万ドル方式に対抗する、量産重視な「一括形成プロセス」のリアリティ - この連載の一覧へ