

Alder LakeはWillow Coveベースの
高速動作対応改良版
ではTSMCのN6を使うのはどれか? 筆者も確信があるわけではないが、 次期Xeonスケーラブル・ファミリーのSapphire Rapidsではないかと考える。逆説的になるが、Alder Lakeはおそらくインテルの10nm++を使い、しかも10nm++に最適化したコアになっているだろう。
なにを言っているかと言えば、かつて14nmプロセスが登場した時、これに素直に対応したBroadwellでは動作周波数がさっぱり上がらなかった。これがちゃんと上がったのはSkylakeが出てからであるが、これはプロセスを改良したのではなく、パイプライン段数を増やすなどして14nmでも動作周波数を引き上げられるようにコアの側で配慮した製品である。
この結果としてBroadwellに比べてグンと消費電力が増えている。同じことがAlder Lakeでも起きているように思える。つまりAlder LakeはGolden Coveベースではなく、Willow Coveベースの高速動作対応改良版ではないかと筆者は考えている。
傍証はいくつかある。6月末の時点でark.intel.comでAlder lakeを検索すると、下の画像が出てくる。この時点でAlder Lakeが1700padになることが明らかにされたわけだ。

ark.intel.comでAlder lakeを検索した画面。すべてのコンテンツがアクセス不能であった。ちなみに一時期は検索してもなにも出てこなかったのだが、今(7月30日)アクセスすると、またこの画面が表示されるようになっている(いつまで続くかわからないが)
現在のLGA 1200から500padも増やす理由はなにか? もちろんコネクティビティー周りの充実などもあるのだろうが、一番考えやすいのはさらに消費電力が増えることだ。
以下の話は確証がないのだが、Alder LakeではTDPが150Wに達するらしい(125W版もあるらしいが)。TDP(=PL1)が150Wということは、PL2は300Wあたりに設定されていても不思議ではない。1Vなら300Aである。それはVccとGNDのPadを増やさないといけないだろう。
逆になぜここまで消費電力が増えるかと言えば、上に書いた通り現在の10nm+/10nm++で上まで動作周波数が伸びるようにコアの構造を作り替えた結果として、消費電力が増えたのだろう。そして、コンシューマー向けの場合はこれが許される。
Sapphire RapidsがTSMCのN6を採用するなら
コアはWillow Coveになる
一方Sapphire Rapidsであるが、こちらはXeon向けである。コアとしてはこちらもWillow Coveになるはずだ。Golden Coveはそもそもインテルの7nmを前提にした設計なので、TSMCのN6ではやや厳しいからだ。
ただAlder Lakeと異なり、こちらは高速動作対応に拡張していないと思う。なぜかといえば、Xeonは真剣に性能/消費電力比を改善することが求められているからだ。
インテルの稼ぎ頭がDCG(Data Center Group)であることはご存じの通りで、この第2四半期でも素晴らしい成績を残しているが、その足元で次第にXeonのシェアが減りつつある。
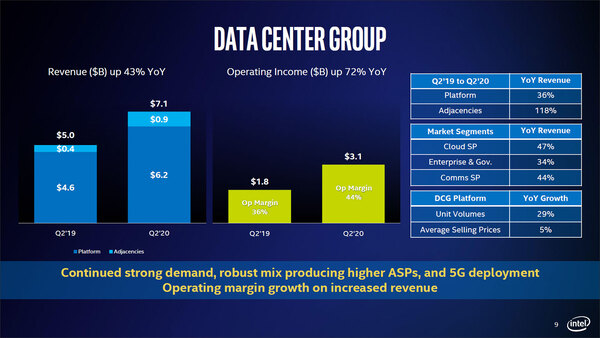
データセンターグループの業績。売上だけでなく営業利益も大幅増なのは、やはりCOVID-19の影響でテレワークの環境を慌てて整える必要があったことが大きいと思われる
言うまでもなくEPYCプロセッサーがXeonのシェアを喰っているからであるが、単に性能だけでなく省電力性が大きな武器になっており、ここをなんとかしないとXeon→EPYCへのシフトがさらに進むことになりかねない。
もう理由を1つ挙げておくと、Sapphire RapidsはAuroraへの搭載も予定されているが、Auroraは単に1EFlopsを実現するだけでなく、消費電力にも厳しいはずだ。以前、1Exaflopsのマシンを20MWの消費電力で構築するDOE Exascale Initiativeの話を連載435回で解説した。
20MWはやはり厳しいので30MWくらいに緩和されたが、Auroraもこれを下敷きにしているはずで、公表はされていないもののシステム全体の消費電力が契約で規定されていると思われる。
現状で言えば、TOP500のトップである富岳の消費電力が14.67TFlops/Wなので、このまま1Exaflopsにスケールさせると消費電力は68MWほどになる。
Green500の方のトップは日本のPreferred NetworksのMN-3であるが、こちらは1621.1TFlops/76.8KWなので、このままスケールできれば4.7MWほどで1Exaflopsが実現できる計算になるが、そこまでスケールできないのが問題であって、Auroraでは別の方法を考えねばならない。
一番肝心のGPUは前述のようにTSMCのN5を使うとして、CPUもやはり相応に消費電力を落とさないと難しいだろうというのは容易に想像がつく。こうした用途では、無理にパイプラインを増やさなくても素直に上まで動作周波数が伸びる(=そこそこの性能を狙うと消費電力がグンと下がる)N6は、こうした要件にうまくマッチすると思われる。
実のところ18万枚というN6のウェハーはAMDより少ないわけで、インテルがクライアント向けに出しているCPUをカバーするにはあまりに少ない。これはXeonと、あとは一部Core-X向けの製造に使われる程度で終わってしまうだろう。
とりあえず今回の決断は、インテルの7nmが実用になるまでのつなぎとして、TSMCのN6(およびおそらくN5)を使うという話であって、長期的には自社の7nmプロセスを使って製造することそのものはまだあきらめていない。これをあきらめたら、Fab 42への投資が丸々無駄になってしまう。
そうでなくても現状インテルは10nmのライン(D1B/D1C/D1D/D1X/Fab28/Fab42)がかなり遊んでいる状況になっており、これまでのシャレにならない投資が全然回収できていない。
もちろん今は14nmプロセスがフル回転してくれているお陰でそうした部分は見えてこないが、その14nmが敬遠される事態になった時にいきなり苦境に陥ることになる。それを防ぐためにも、なんとしても7nmを早期に立ち上げたいところだろうが、はたしてどうなるか注視していく必要がある。
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第898回
PC
AI特化とは一線を画すHPCの怪物! 富士通「Monaka」が目指す3D積層と256bit SVE2の真価 -
第897回
PC
NVIDIA独自コア「Olympus」の真価 Vera CPUが見せたIPC全振りの重厚構造とメモリー帯域依存 -
第896回
PC
Arm自社設計「AGI CPU」の全貌、10-wideデコードと2ダイ構成で見せた優等生的な実力 -
第895回
PC
IBM ZがArmを取り込む衝撃! 次世代メインフレーム「z18(仮)」のネイティブDual-ISA戦略の狙い -
第894回
PC
AMD「Ryzen AI Embedded X100」のリアルタイムAI制御が、Jetsonの弱点であるCPU性能を突く -
第893回
PC
インテル製GPU「Crescent Island」の正体、容量480GBメモリーでエージェント型AIとKVキャッシュ問題に挑む -
第892回
PC
Hot Chipsで明かされた「Wildcat Lake」の全貌 Foverosを捨てMCPを選んだインテルの舞台裏 -
第891回
PC
謎多き次世代Xeon「Diamond Rapids」を解剖、3D Meshの進化と新命令セットAPXがもたらす変革 -
第890回
PC
Samsung「SF2P」の全貌! GAA最大の弱点であるPMOS性能低下を克服し、TSMC追撃へ準備万端 -
第889回
PC
なぜ巨大チップは歪んで壊れるのか? SK HynixのHBM4「MR-MUF」とTSMCのCoWoS-Lを襲う熱膨張の罠 -
第888回
PC
NVIDIA Rubin Ultra開発中止の真相! 180層CoWoS-Lの歪曲トラブルと、急造ラックNVL576に透ける苦肉の策 - この連載の一覧へ