最新パーツ性能チェック 第486回
ASUSの小型PC「ProArt GR1X」レビュー【前編】
TDP 140WのデスクトップPC版RTX Sparkの性能をTDP 45W〜80WのノートPC版と比較、真価は電力制限で変わる!?
2026年11月18日 23時00分更新


軽いモデルだとGPUの地力でRTX 5060 Tiに負ける
ここからはAI系の検証に入る。前回と同様に「MLPerf Client 2.0」を使用する。今回はLLMやAIエージェント用に「Quen 3 8B」、さらに画像生成では「Flux 4 Klein 4B」を使用した。Flux 4 Kleinに関してはFP8とNVFP4形式で検証している。
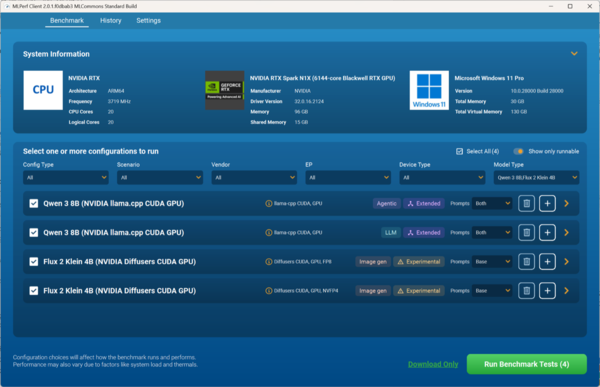
MLPerf ClientのUI。今回は画像生成用にFlux 4 Kleinも追加している
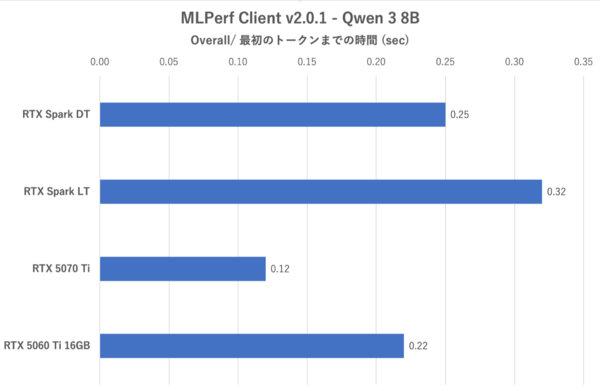
MLPerf Client:Qwen 3 8Bを使用したLLMにおける、最初のトークンまでの時間
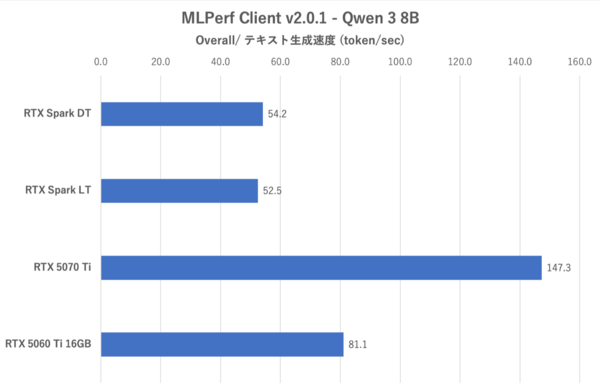
MLPerf Client:Qwen 3 8Bを使用したLLMにおける、テキスト生成スピード
まずQwen 3 8Bを使用したLLMの性能だが、テキスト生成速度においてRTX SparkはRTX 5060 Ti 16GBに大きく後れを取っている。RTX Spark DTと同LTの差は非常に僅差で、TDP上昇の恩恵も感じられない。一方で、最初のトークンまでの時間はRTX 5060 Ti 16GBの0.22秒に対し、RTX Spark DTが0.25秒と良いところまで詰めてきている。
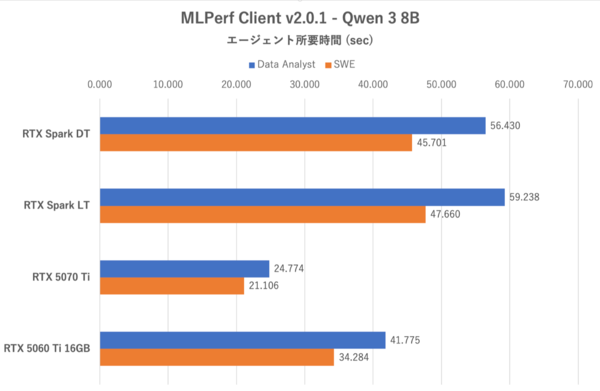
MLPerf Client:Qwen 3 8BにおけるAIエージェントの処理時間
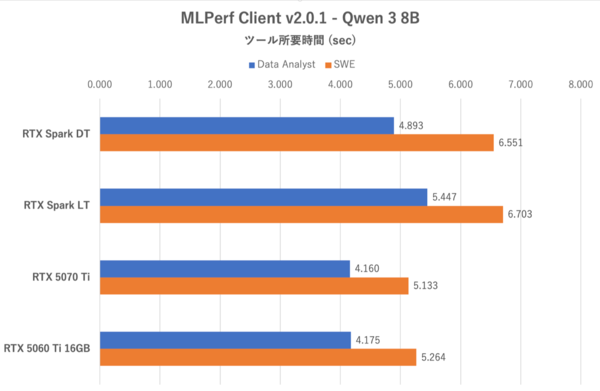
MLPerf Client:Qwen 3 8Bにおけるツールの処理時間
続いてQwen 3 8Bを利用したAIエージェントにおける比較だが、こちらもRTX Spark DTは同LTに対し、処理時間が微増。RTX 5060 Ti 16GBには遠く及ばなかった。Qwen 3 8B程度の超軽量AIモデルでは、GDDR7が使えてL2キャッシュの量に勝るRTX 5060 Ti 16GBのほうが有利なのだろう(RTX 5060 Tiは32MB。RTX Sparkは24MB)。このあたりの傾向は前回の検証と変わっていない。
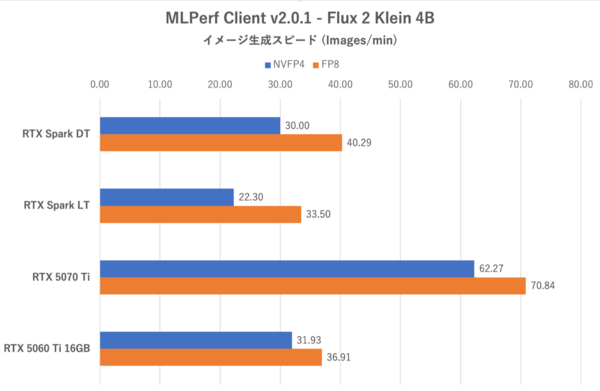
MLPerf Client:Flux 4 Klein 4Bにおけるイメージ生成スピード
Flux 4 Klein 4Bを使用した画像生成スピードでは、RTX Spark DTがRTX 5060 Ti 16GBに対し、FP8では同等、NVFP4では僅差で勝利した。一方で、RTX Spark LTに対しては、NVFP4で20%の速度向上が確認できるなど、TDPが引き上げられたぶんの性能向上を果たしたが、あいかわらずRTX 5070 Tiには圧倒的な差をつけられていた。
今回の検証はここで時間切れ。次回も引き続きAI性能をテストする予定だが、RTX Sparkのメリットである巨大なVRAMのメリットを探るべく、もっとメモリー負荷の高いAIで検証することにしたい。
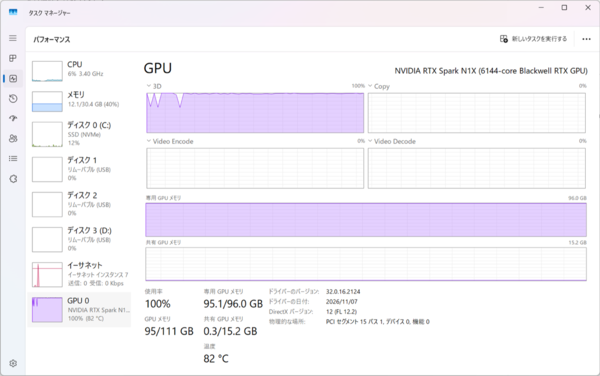
次回の検証ではVRAM 96GBをほぼ使い切るテストを追加。この状態でRTX 5060 Tiに完全勝利を収めることができるのだろうか?
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第485回
自作PC
RTX Sparkは本当にローカルAIに強いのか?RTX 5090や5070 Ti、5060 Ti 16GB、4090 Laptop GPUと性能を比較 -
第484回
自作PC
Surface Laptop Ultraの基本性能を検証、RTX Sparkの3D描画性能はRTX 5060と5050の間ぐらい -
第483回
自作PC
左手(AI)はそえるだけ。「NBA 2K27」でDLSS 5におけるニューラルレンダリングの画質とフレームレート下落率を検証 -
第482回
自作PC
CPU性能はRyzen 7 5700Xに比肩!Arc G3 Extreme搭載ポータブルゲーミングPCの性能は驚異的だった -
第481回
デジタル
旧世代Ryzenに3D V-Cacheでどこまで戦える?「Ryzen 7 7700X3D」「Ryzen 7 5800X3D 10th Anniversary Edition」レビュー -
第481回
自作PC
Radeon RX 9050はわずか92Wの低消費電力でRDNA 4世代の先進技術を搭載、省エネと性能を両立した最新性能レビュー -
第480回
自作PC
Radeon RX 7000シリーズが予定より早くFSR 4に対応、中堅GPUでもより鮮明でリアルな映像を実現! -
第479回
自作PC
Radeon RX 9070 GREレビュー! VRAM 12GBでRTX 5060 Ti 16GBに圧勝しRTX 5070に迫る -
第478回
自作PC
Ryzen 9 9950X3D2最速レビュー【後編】 デュアル3D V-Cacheのゲーム性能を詳しくチェック -
第477回
自作PC
Ryzen 9 9950X3D2最速レビュー デュアル3D V-Cacheで開発者・クリエイター向け最強CPUになった驚きの実力を解説 - この連載の一覧へ