ロードマップでわかる!当世プロセッサー事情 第873回
「銅配線はまだ重要か? 答えはYesだ」 NVIDIA CEOジェンスンが語った2028年ロードマップとNVLink 8の衝撃
2026年04月27日 12時00分更新


GTC 2026アップデートの3回目となる今回は、2028年のロードマップについて説明しよう。実は基調講演の中で2028年、つまりFeynman世代についてはあまり詳細な説明はなかった。ロードマップとして示されたのが下の画像だ。
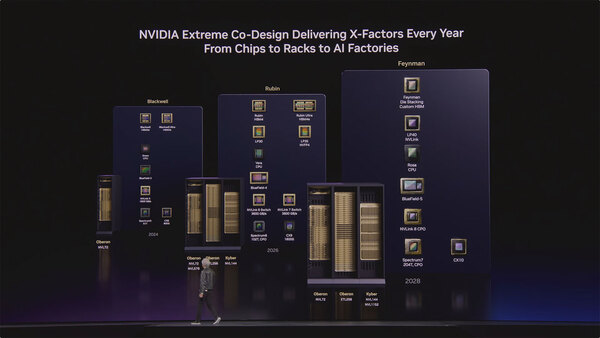
NVIDIAのロードマップ。さりげなく2026年にNVL576がOberonベースで実現することになっているのが特記事項である
2028年の部分を拡大してみると、以下のことが明らかになった。
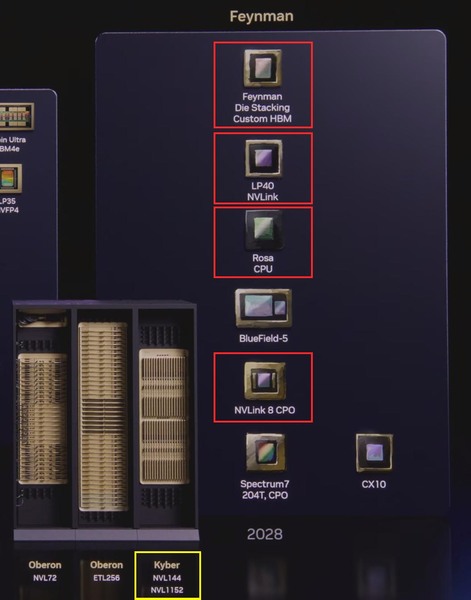
2028年のロードマップ。BlueField-5の存在やSpectrum7がしれっと204Tbpsと書いてある。これはこれで問題なのだが。さらにConnextX-10の存在も予告されている
- FeynmanはDie StackingとCustom HBMを採用
- LP40がNVLinkを搭載
- CPUがVeraからRosaに更新
- NVLink 8にはCPOが用意される
それに加え、
- KyberベースでNVL1152が投入される
以下これを順に説明していく。
Feynmanの鍵を握る「Die Stacking」と「COPA」構想
まずFeynman。基調講演の中では名称が呼ばれただけで、基調講演の後のQ&Aでも特に言及がなされていない。したがってDie StackingとCustom HBMを使うこと「だけ」が公開情報になる。
このDie Stackingであるが、これに関してNVIDIAが2021年に発表した"GPU Domain Specialization via Composable On-Package Architecture"という論文がある。
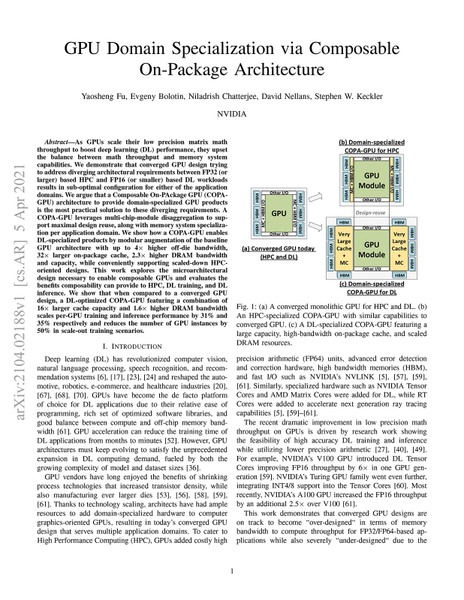
NVIDIAが2021年に発表した論文。ある意味出オチというか、右上の図がすべてを物語っている
COPA(Composable On-Package Architecture)というのは、従来のGPUの構成をモジュールレベルで分解し、必要に応じて組み合わせを変えることで、用途別(Domain Specific)な製品を構築しよう、というものである。
動機は、HPC向けとAI向けではGPUに対する性能要求が異なるところからスタートする。プロセス微細化にともない演算器を大量に集積できるようになり、特にDeep Learning向けのスループットはどんどん向上している。一方でダイサイズはReticle Limitにより制限され、またメモリー搭載量やメモリー帯域はプロセス微細化の貢献が薄い。結果、今後は演算性能に対してメモリー帯域が決定的に不足するという予測になった。
悪いことに、このメモリー帯域の不足はアプリケーションによって影響が異なる。NVIDIAの分析によれば、Deep Learningの訓練/推論はDRAM帯域がボトルネックになっており、実行時間の28~30%がDRAM帯域の制限に由来すると予測される一方、HPCアプリケーションでは仮に帯域を無限にしても性能は5%ほどしか向上しないという結果が出たという。
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第902回
PC
なぜGPUとTPUを混載するのか? あえてCPUを外しFP8も捨てたWaymo独自プロセッサーの徹底した割り切り -
第901回
PC
Teslaの「カメラ単体」を否定する理由 Waymoが明かした自動運転の壁と自社製プロセッサー -
第900回
PC
元Samsung副社長が率いるBOSの勝算 Tenstorrent製NPUとオープン規格で挑む車載AI「Eagle-N」 -
第899回
PC
NVLink追撃の現実解「UALoE」 AMD Instinct MI400が挑む次世代ラック実装とBlackwell対抗 -
第898回
PC
AI特化とは一線を画すHPCの怪物! 富士通「Monaka」が目指す3D積層と256bit SVE2の真価 -
第897回
PC
NVIDIA独自コア「Olympus」の真価 Vera CPUが見せたIPC全振りの重厚構造とメモリー帯域依存 -
第896回
PC
Arm自社設計「AGI CPU」の全貌、10-wideデコードと2ダイ構成で見せた優等生的な実力 -
第895回
PC
IBM ZがArmを取り込む衝撃! 次世代メインフレーム「z18(仮)」のネイティブDual-ISA戦略の狙い -
第894回
PC
AMD「Ryzen AI Embedded X100」のリアルタイムAI制御が、Jetsonの弱点であるCPU性能を突く -
第893回
PC
インテル製GPU「Crescent Island」の正体、容量480GBメモリーでエージェント型AIとKVキャッシュ問題に挑む -
第892回
PC
Hot Chipsで明かされた「Wildcat Lake」の全貌 Foverosを捨てMCPを選んだインテルの舞台裏 - この連載の一覧へ