ロードマップでわかる!当世プロセッサー事情 第860回
NVIDIAのVeraとRubinはPCIe Gen6対応、176スレッドの新アーキテクチャー搭載! 最高クラスの性能でAI開発を革新
2026年01月26日 12時00分更新


CES2026の解説記事3回目はNVIDIAである。NVIDIAに関して、基調講演と、コンシューマー向けのDLSS 4.5やG-SYNC Pulserなどの話はすでに別の記事で説明しているので、ここではVera Rubinの話をしよう。
といっても、実はあまり新しい情報はなく、Veraについてもう少し詳細な話があったのと、VeraとRubinの実物が示されたこと程度である。
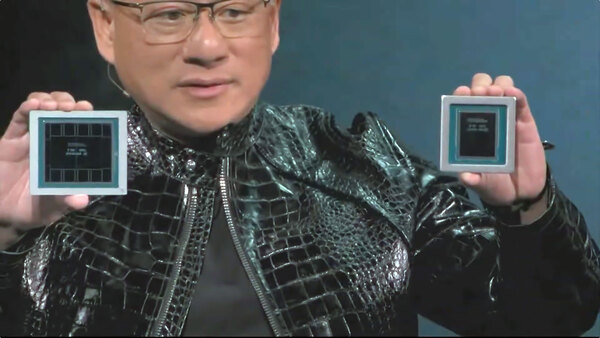
左がRubin、右がVera。NVIDIA Liveのキャプチャーなので、ややピントが合っていないのはご容赦を。ちなみに結構暗めだったので色調補正をかけている
下の画像に出てくるCompute Bladeを実装したNVL72の実物の展示もあったのだが、ラックそのものはBlackwell世代と同じOberon rackが利用されていることもあって、なにか見てわかるものがあるわけではなかった。
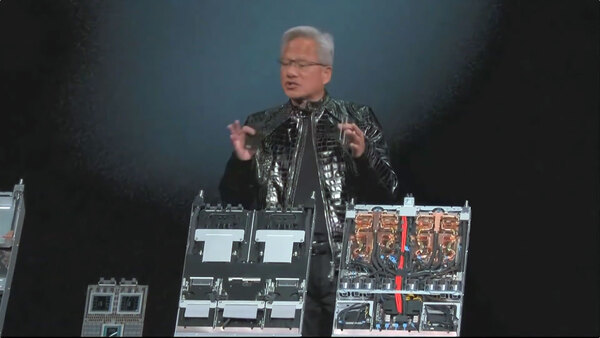
一番左がVera+Rubin×2のSuperChip、中央がそのSuperChip×2を格納するBladeのシャーシ、右がSuperChipを実装し、冷却配管や配線を施した完成状態のCompute Bladeである
ただ、CESでの発表に合わせてNVIDIAはTechnical BlogでVera Rubin世代の構成要素に関して情報を公開してくれたおかげで、Vera Rubinの詳細がもう少しわかるようになった。ということで、これらを説明したい。
次世代AIデータセンター向けCPU「Vera」
まずVera CPUである。以前のGrace CPUが、Neoverse V2ベースの72コア構成だったのに対し、Vera CPUは独自のOlympusコアになり、コア数も88に増強された。主な仕様の違いをまとめたのが下表となる。
| GraceとVeraの違い | ||||||
|---|---|---|---|---|---|---|
| Grace | Vera | |||||
| コア種類 | Arm Neoverse V2 | NVIDIA Olympus | ||||
| コア数 | 72 | 88 | ||||
| スレッド数 | 72 | 176 | ||||
| SVE | 128bit SVE2×4 | 128bit SVE2 FP8×6 | ||||
| L2キャッシュ | 1MB/コア | 2MB/コア | ||||
| L3キャッシュ | 114MB | 162MB | ||||
| メモリ種別 | LPDDR5X | LPDDR5X | ||||
| メモリ帯域 | 最大512GB/s | 最大1.2TB/s | ||||
| メモリ容量 | 最大480GB | 最大1.5TB | ||||
| NVLINK-C2C帯域 | 900GB/s | 1.8TB/s | ||||
| PCIe/CXL | Gen5 | Gen6/CXL 3.1 | ||||
| CCA | 未サポート | サポート | ||||
アーキテクチャーが、Neoverse V2はArm v9.0-Aベースである。対するOlympus、明示はされていないがArm v9.2-Aではないかと思う。理由は簡単で、今さら大金と手間をかけてArm v9.0-Aのカスタムコアを作るべき理由が皆無だからだ。もっともv9.0-Aとv9.2-Aの違いはそれほど多くなく、下表にある程度ではあるのだが、セキュリティ強化をわりと前面に押し出している感のある(これは後述)Veraではv9.2-Aを当然サポートしているように思える。
| アーキテクチャーの違い | ||||||
|---|---|---|---|---|---|---|
| v9.1-A | MatMul命令/BF16サポート/仮想化強化/ポインター認証強化/高精度タイマー搭載 | |||||
| v9.2-A | PCIe Hot plugのサポート/Atomic 64Bytes load/store/WFI(Wait for Instruction)・WFE(Wait For Eventのサポート/Branch-Record recordingのサポート | |||||
さらに加えると、表の最後にあるCCA、これはArmのConfidential Computing Architectureの略である。CCAは、Arm v9でサポートという話になっているが、具体的にどのバージョンかがこれまで明示されていなかった。おそらく実装にはArm v9.2-Aが必須で、それもあってArm v9.2-Aでの実装になったのではないか、と筆者は考えている。
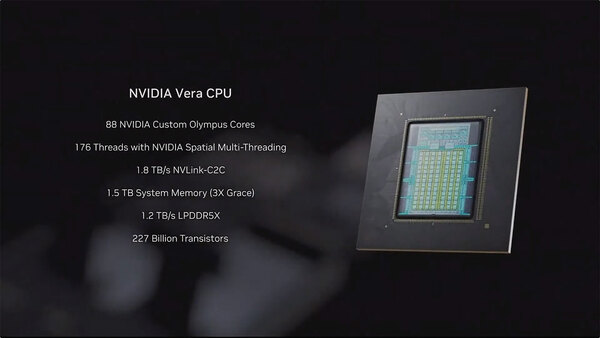
Veraの主要な特徴。Olympusコアの詳細は今のところ未公開
ところで上の画像にNVIDIA Spatial Multi-Threadingなる文言が躍っているのだが、これがまたちょっと独特なものである。通常Multi-Threadingは、時間分割のパターンが多い。Thread Aがメモリーアクセスを待っている間、Thread Bが先行して処理するといった形だ。
これに対してSpatial Multi-Threadingは物理的にハードウェアリソースを分離して同時に実行させる仕組みで、原理的にはインテルのHyperThreadingやAMDがZenコアに実装しているSMTに近い。なのだが、説明を読むと"runs two hardware threads per core by physically partitioning resources"と書いてある点が異なる。
HyperThreadingにしてもZenのSMTにしても、1次キャッシュやレジスターファイルなどはある意味共有可能だ。実際に共有するかどうかは各スレッドで動くプログラム次第になっているが、Spatial Multi-Threadingでは"physically partitioning"(物理的に分離して)と書かれており、プログラムから見れば88コアのSMT付きCPUというよりも176コアのSMTなしCPUの扱いに近い。これもセキュリティ対策である。
NVIDIAによればマルチテナントなAIファクトリーには欠かせない要件としている。要するにあるスレッドからは、同じコアで動いていている別のスレッドが完全に見えなくなっているわけだ。これはArmのCCAそのものであり、CCAの実装形態であるRealmの要求を完全に満たしている。
逆に言えば、Spatial Multi-Threadingは性能向上のための手段ではない。おそらくSpatial Multi-Threadingを無効化した方が性能は向上するだろう。CPUでの重い演算処理はほぼ想定されておらず、2つのRubinに処理を割り振る(のと通信やデータ転送を行なう)ことに特化したCPU、という感じになっている。
インテル的に言えば、P-コア Xeon的だったのがGraceであるが、VeraはE-コア Xeon的に様変わりした感じだ。そのわりにSVE2エンジンが×6に強化されているのはやや解せない感はあるが。あるいはCCAは無効化可能で、その場合はMulti-Threadingも無効化して性能優先動作のモード設定が可能なのかもしれない。
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第897回
PC
NVIDIA独自コア「Olympus」の真価 Vera CPUが見せたIPC全振りの重厚構造とメモリー帯域依存 -
第896回
PC
Arm自社設計「AGI CPU」の全貌、10-wideデコードと2ダイ構成で見せた優等生的な実力 -
第895回
PC
IBM ZがArmを取り込む衝撃! 次世代メインフレーム「z18(仮)」のネイティブDual-ISA戦略の狙い -
第894回
PC
AMD「Ryzen AI Embedded X100」のリアルタイムAI制御が、Jetsonの弱点であるCPU性能を突く -
第893回
PC
インテル製GPU「Crescent Island」の正体、容量480GBメモリーでエージェント型AIとKVキャッシュ問題に挑む -
第892回
PC
Hot Chipsで明かされた「Wildcat Lake」の全貌 Foverosを捨てMCPを選んだインテルの舞台裏 -
第891回
PC
謎多き次世代Xeon「Diamond Rapids」を解剖、3D Meshの進化と新命令セットAPXがもたらす変革 -
第890回
PC
Samsung「SF2P」の全貌! GAA最大の弱点であるPMOS性能低下を克服し、TSMC追撃へ準備万端 -
第889回
PC
なぜ巨大チップは歪んで壊れるのか? SK HynixのHBM4「MR-MUF」とTSMCのCoWoS-Lを襲う熱膨張の罠 -
第888回
PC
NVIDIA Rubin Ultra開発中止の真相! 180層CoWoS-Lの歪曲トラブルと、急造ラックNVL576に透ける苦肉の策 -
第887回
PC
AIなしではもはや限界 TSMCが明かすメモリー開発にAIが不可欠となった現実 - この連載の一覧へ