ロードマップでわかる!当世プロセッサー事情 第892回
Hot Chipsで明かされた「Wildcat Lake」の全貌 Foverosを捨てMCPを選んだインテルの舞台裏
2026年09月07日 12時00分更新


配線面積と帯域制限の課題、そしてダイの救済策に見る歩留まり
ここからはUCIe周りの詳細だ。下の画像にも出てくるが、今回UCIe Standard、すなわち通常のパッケージ基板経由で信号を通すUCIeを利用したことで、UCIeのBall PitchはFoverosの場合の3倍(Foveros:36μm、UCIe:110μm)になっている。
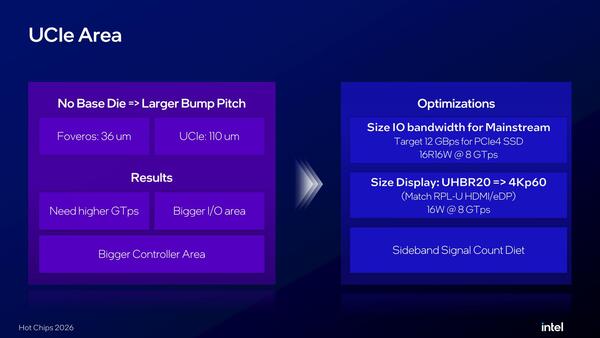
Sideband Signal Count Dietとあるように、そもそもUCIe以外の信号線は極力排したようだ
つまりラフに言えば同じ信号を通すのに、UCIeではFoverosの場合の9倍の面積が必要である。これもあって、Wildcat Lakeに占めるUCIeのI/F部の面積は、Panther Lakeの場合の7割増しになっている。
7割増で済んだ理由として大きいことは、GPUがCPU&GPU Tileに統合されてしまったのでそちらの配線がいらないことであるが、そもそもターゲットはPCIe 4.0のNVMe SSDの帯域(~12GB/秒)をフルに生かせるようにすることで、8Gbps×16bitという構成にしている。これだけあればUSB経由でのDisplay出力にも対応可能であり、このあたりで必要十分と判断したようだ。
ただこれは逆に言えば、PコアとEコアの間の帯域も16GB/秒どまりということになる。要するにWildcat LakeでEコアをフルに動かそうとした場合、この帯域がボトルネックになってメモリーアクセスも16GB/秒どまりになってしまうし、スレッドを煩雑にPコアとEコアの間で切り替えるような処理も向いていない。
省電力動作時にはこれで十分だろうが、フルに動かすことを考えた場合、Eコアまでフル稼働させるのはむしろ全体のパフォーマンスを引き上げる足かせに成りかねないことには注意が必要だ。これまでインテルはCPUのメモリーアクセスにこうした制約を与えることはあまりなかったが、Wildcat Lakeに関してはこの辺を割り切ったのかもしれない。
もしフル稼働させるなら、EコアのL2キャッシュ内で収まるような小さなプログラムを動かすのに留めておくのがよさそうである。
またUCIeは汎用プロトコルであるがゆえに、省電力動作も少なくとも標準では用意されない。そこでLink Statusを複数用意して、レイテンシーと消費電力の複数の組み合わせを提供したり、QoSを利用してディスプレー出力を優先するといった工夫がなされたとしている。
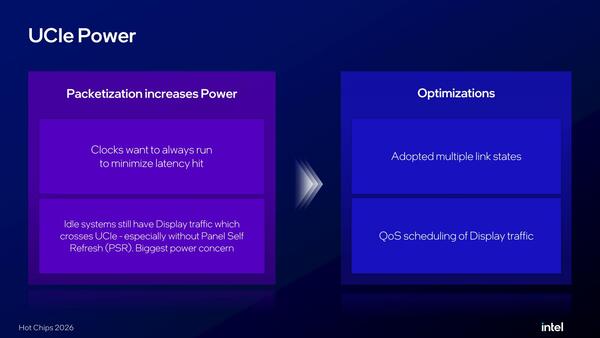
UCIeは物理層の仕様なので、どういうデータを流すのかはユーザーに任せられており、QoSは別に拡張ではない。Link Statusに関しては、あるいは転送クロックそのものも複数用意されるのかもしれない。PCIeのDynamic Lane Width(稼働状況に応じて利用するレーン数を変化させる仕組み)は実装が大変になるからインプリメントされていないはずだ
下の画像がラインナップ一覧となるがこれはすでに公開されている。
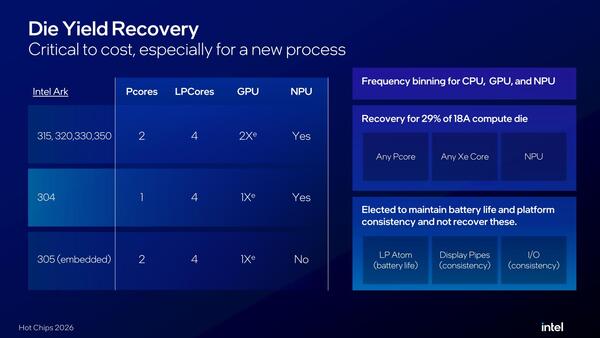
現在はCore 7 360がハイエンドにラインナップされているのだが、なぜか一覧にない
ただ非常に興味深いのだが、ベースとなるのはCore Series 3のCore 7 350/330/320/315で、この4(5)製品は2 PコアでGPUのXe Coreの数も2つである。問題はPコア×1+Xeコア×1のCore 3 304とPコア×2+Xeコア×1のCore 3 305の2製品で、この2つがあることで29%ものダイが救えたとしていることだ。
Wildcat Lakeのパッケージサイズは35×25×1.23mmとなっている。下の画像は今年4月にWildcat Lakeが発表された時のスライドからパッケージを切り出したものである。
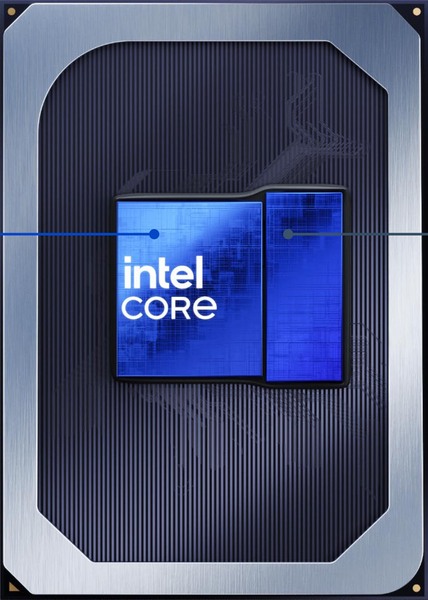
Wildcat Lakeのパッケージ。元のスライドはジサトライッペイ氏の記事である
実写画像ではなくCGではあるのだが、一応これが実際のダイを正しく反映していると仮定すると以下の計算になる。
| タイルのサイズ | ||||||
|---|---|---|---|---|---|---|
| CPU&GPU Tile | 8.50mm×10.14mm=86.19mm2 | |||||
| Platform Controller Tile | 4.39mm×10.99mm=48.25mm2 | |||||
それほど大きなサイズではないのだが、それでもCPU/GPUが1個足りないダイをSKUに追加することで29%も廃棄するダイが減ったあたり、やはりそれなりにIntel 18Aは厳しいことをうかがわせる。
いろいろと最適化の苦労が見られる結果であることはよく理解できたが、逆に言えばFoverosも既存のタイルも全部捨てて、新しくMCPで作らないと低コスト品にならないというあたりが、インテルのチップレット戦略の弱点を示していると思わざるを得ない。
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第897回
PC
NVIDIA独自コア「Olympus」の真価 Vera CPUが見せたIPC全振りの重厚構造とメモリー帯域依存 -
第896回
PC
Arm自社設計「AGI CPU」の全貌、10-wideデコードと2ダイ構成で見せた優等生的な実力 -
第895回
PC
IBM ZがArmを取り込む衝撃! 次世代メインフレーム「z18(仮)」のネイティブDual-ISA戦略の狙い -
第894回
PC
AMD「Ryzen AI Embedded X100」のリアルタイムAI制御が、Jetsonの弱点であるCPU性能を突く -
第893回
PC
インテル製GPU「Crescent Island」の正体、容量480GBメモリーでエージェント型AIとKVキャッシュ問題に挑む -
第891回
PC
謎多き次世代Xeon「Diamond Rapids」を解剖、3D Meshの進化と新命令セットAPXがもたらす変革 -
第890回
PC
Samsung「SF2P」の全貌! GAA最大の弱点であるPMOS性能低下を克服し、TSMC追撃へ準備万端 -
第889回
PC
なぜ巨大チップは歪んで壊れるのか? SK HynixのHBM4「MR-MUF」とTSMCのCoWoS-Lを襲う熱膨張の罠 -
第888回
PC
NVIDIA Rubin Ultra開発中止の真相! 180層CoWoS-Lの歪曲トラブルと、急造ラックNVL576に透ける苦肉の策 -
第887回
PC
AIなしではもはや限界 TSMCが明かすメモリー開発にAIが不可欠となった現実 - この連載の一覧へ