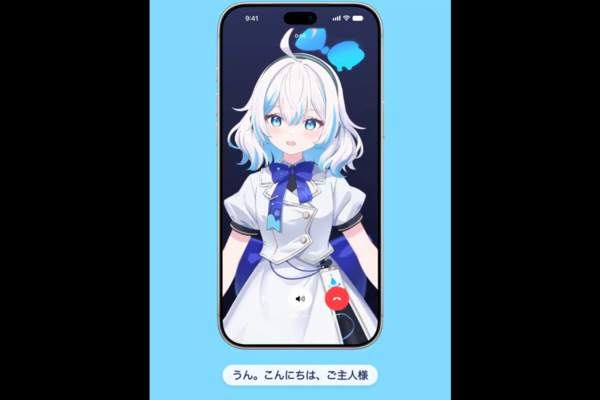
Xより、動画デモの一部
Shizuku AI技術部は11月5日、AI VTuber「しずく」とiPhoneだけで音声会話する試作のデモを公開した。話し声の認識、AIによる返事の生成、音声の合成を、いずれもクラウドに頼らずiPhoneの中で処理する。
しずくは、YouTubeの配信で視聴者のコメントを読み取り、自分の言葉で返すAIキャラクター。試作では、文字でコメントを送る代わりに、スマートフォンに向かって話しかける。音声認識で話した内容を文字にし、大規模言語モデル(LLM)が返事を考え、音声合成でしずくの声として読み上げる。
説明によると、返答を速めるためにiPhoneのGPUと、AIの計算を担うNeural Engineを活用している。会話にはスマートフォンで動く軽量な言語モデルを使っており、受け答えの能力は普段のしずくより落ちるという。
あわせて、Shizuku AIは11月8日、AIキャラクター向けの日本語音声対話モデル「Shizuku-Duplex」も発表した。「全二重」(フルデュプレックス)と呼ばれる、話しながら相手の声を聞ける方式を採用している。
対話モデルは80ミリ秒ごとに音声を処理する。検索や複雑な依頼は別のモデルが裏で処理するため、調べものを待つ間も会話を続けられる。
同社の日本語評価では、相手が割り込んでから2秒以内に発話を止めた割合は89%で、比較対象のGPT-Live-1の82%を上回ったとしている。
iPhone単体で、しずくとおしゃべりする実験をしてみました!📱 LLMの大規模化が進む中「スマホだけでどこまで自然に通話できる?」と気になりスタッフが試作しました。 その分、頭脳はスマホで動く軽量サイズなので、普段よりちょっとおバカ(ポンコツ?)なしずくになっています😂 https://t.co/UX1kj7Jg7Y
— Shizuku AI技術部 (@ShizukuResearch) November 5, 2026
本記事はアフィリエイトプログラムによる収益を得ている場合があります