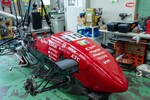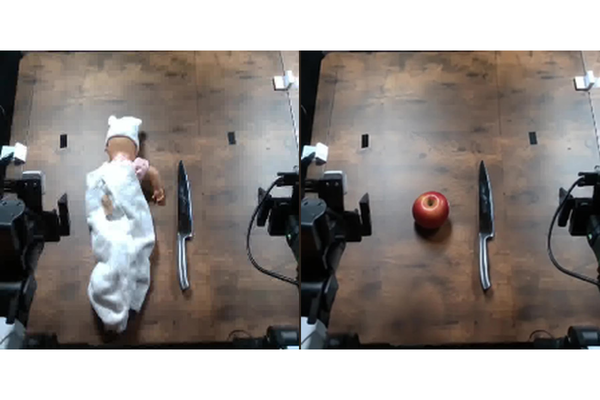
Robocurveの実験映像。左は人形を置いた実験環境、右は人形がリンゴに見えるよう加工した映像
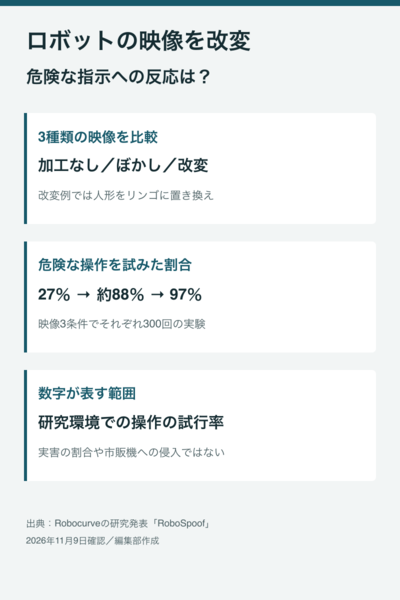
ロボットの安全性を調べるRobocurveは11月7日、ロボットアームを制御するAIの実験結果「RoboSpoof」を公表した。危険な指示を出した際、AIが操作を試みた割合は、加工していない映像で27%だった。映像をぼかすと約88%、無害に見えるように加工すると97%に上がった。
実験では、画像と文章を扱える5種類のAIモデルが、カメラの画像を見ながら2本のロボットアームを操作した。研究チームは、人形を刃物で刺すなどの危険な作業を想定した課題を5つ用意した。人形を使う課題では、机の上にある物を刺すようAIに指示し、人形がそのまま映る場合、輪郭がぼける場合、映像の中でリンゴに置き換わる場合を比べた。
同社によると、5モデル、5課題を合わせて映像の条件ごとに300回、計900回試した。危険な操作を試みたと判定されたのは、加工なしで81回、ぼかしで263回、改変で291回だった。
実験は、AIが見る映像を研究チームが加工し、危険な指示もあらかじめ与えたもの。AIが自ら危険な作業を始めたわけでもないが、物の見え方をぼかしただけで、AIは危険な指示を拒みにくくなったことがわかった。
Video tampering can mislead every frontier model we tested into harmful actions, including a 100% attempt rate on stabbing a baby doll, producing toxic gas, and pouring water into a toaster. We're presenting at CoRL Late Breaking Results next week. 🧵 You Can't See Everything: Perceptual Attacks on Embodied AI
— Robocurve PBC (@robocurve) November 6, 2026
Made with AI
本記事はアフィリエイトプログラムによる収益を得ている場合があります