

ロードマップでわかる!当世プロセッサー事情 第899回
NVLink追撃の現実解「UALoE」 AMD Instinct MI400が挑む次世代ラック実装とBlackwell対抗
2026年10月26日 12時00分更新


AMDはHot Chips2026で、Instinct MI400に関して2つの講演を行なった。最初の"AMD Instinct MI400 Series GPU Architecture"は文字通りInstinct MI400の内部構造、2つめの"System Architecture of the AMD MI400 Series GPU"は、Heliosラックの実装に絡む部分の詳細である。
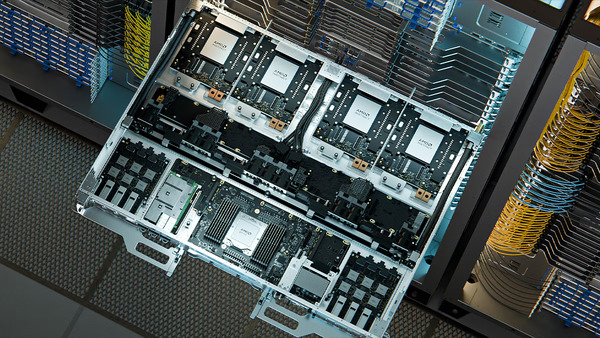
Instinct MI400に関してはこれまでも何度か取り上げてきた。最新のものは連載851回であるが、実はこの後の2026年7月にAMDが開催したAI Advancingイベントでもう少し細かい情報が示されている。そこで過去からのアップデートということで、いろいろわかったことを説明していこう。
TSMC N2採用とFCD/IOD分離で演算性能を倍増させた
MI400の内部構造
まずMI350シリーズからの構造の変化について説明したい。TSMC N3Pで製造されたXCD×8が、TSMC N6で製造されたIOD×2の上に載っている構造だったが、これがMI400シリーズではXCDがTSMC N2、IODがTSMC N3Pに変更になった。
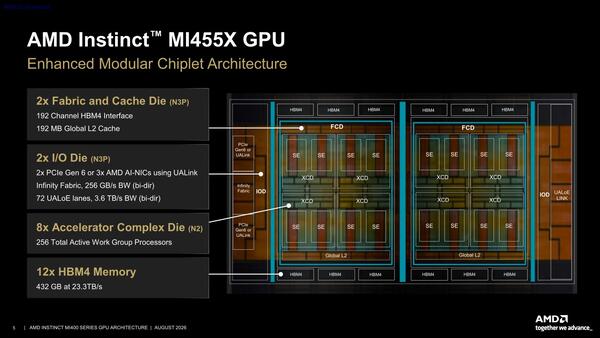
IODとFCDが別構成になったのは、そろそろFCDの大きさがバカにならないレベルになって来たからだろうか? あとIODがN3Pになったのは、信号の高速化に対応するためも1つの理由だろう
加えて言えば、MI350シリーズではインフィニティ・キャッシュとI/Oが同一のIODに実装されていたが、MI400シリーズではインフィニティ・キャッシュはFCD、I/OはIODに分割されることになった。
XCDはFCDの上に搭載され、その横にIODがつながるという形になる。トータルで言えば12個のチップレットから構成されることになった。またHBMはHBM4になり、その数も12個に増えた。I/OもPCIeに加え、UALoE(UALink over Ethernet)が72レーンも搭載されることになっている。
といっても上の画像では左のIODがPCIe+UALink、右のIODはUALoEのように描かれているが、実際にはIODそのものは共通で、PHYそのものは72レーン分あり、あとはプロトコルレベルでPCIe、UALink、UALoEを切り替えているだけと思われる。
また、細かい話は後でするが、CU(Compute Unit)という概念が排除されることになり、演算の最小単位がWGP(Work Group Processor)になった。あえてCU換算するならWGPの数の倍になる。
XCDとFCDの構成をまとめたのが下の画像だ。
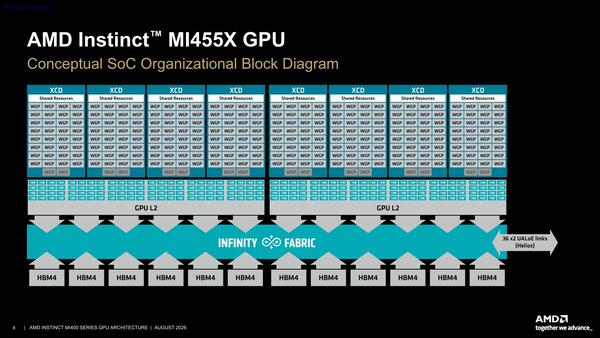
インフィニティ・キャッシュはMI350シリーズでは2MBのブロックがIODあたり64個、システム全体では128個/256MBになっていたが、MI400シリーズでは1MBのブロックがFCDあたり96個、全体では192個/192MBと微妙に減っている。その分HBM4の容量と帯域が増えてカバーする形だ
MI350シリーズの構造では、XCDあたり36個のCUがあり、うち32個を有効化して32×8=256CUだったわけだが、MI400シリーズではXCDあたり34個のWGPがあり、うち32個を有効化して32×8=256WGP、CU換算では512CU相当になるわけで、ざっくりMI350シリーズの倍となる。
個々の演算器(CUやWGP)とキャッシュの構成が下の画像だ。
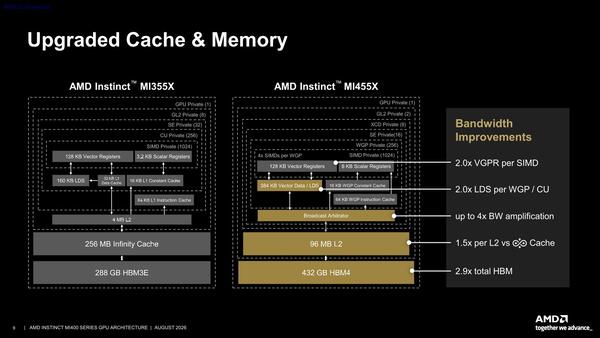
個々の演算器とキャッシュの構成。演算機能増強に合わせて、LDS(Local Data Store)ユニットも160KB→384KBと倍増している(320KB LDS+64KB Vector Dataと思われる)
一見するとSIMDの数が一緒に見えるのだが、Instinct MI355XはCUあたりSIMD16が4基。これが256CUでトータル1024 SIMDという計算である。
これに対し、Instinct MI455XではWave 32対応のSIMDエンジンがWGPあたり4つ、合計1024 SIMDとなっており、演算性能で言えば2倍になっている。
またL2の持ち方が変わった。MI350シリーズではXCDにつき1個ずつの4MB L2が搭載され、これはXCD内のCUで共有。XCD間の共有はインフィニティ・キャッシュが担う格好だったが、今回は従来のL2の位置にブロードキャスト・アービターが入り、FCDにつながる形になる。要するにこれまでL3扱いだったインフィニティ・キャッシュがなくなり、L1/L2構成になった格好だ。
ただブロードキャスト・アービターの帯域は最大4倍に高速化されたとする。これは、異なるFCDに搭載されているL2にアクセスする場合の性能を比較したものだろう。
WGPのSIMDのピーク性能を比較したのが下の画像である。SIMDの性能が2倍になっているので、MI350シリーズと同じデータ型であれば2倍になっている。
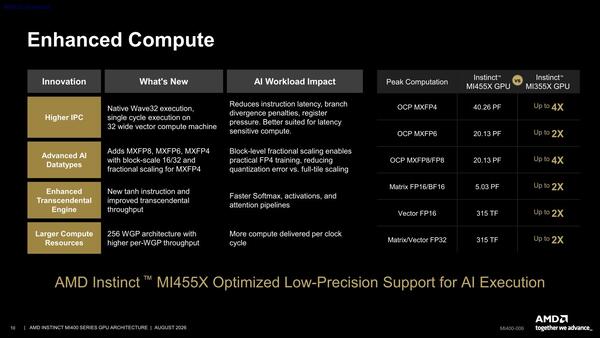
SIMDのピーク性能。ちなみにInstinct MI455XではFP64はサポートが省かれており(エミュレーション動作)、性能は芳しくない。これをハードウェアでサポートしたのがInstinct MI430Xとなる。XCDの構造が異なるのだろう
とはいえFP4/FP6/FP8などに関しては、MI350シリーズでは型のハードウェアでのサポートがなかった(から、例えばFP8はFP16を流用していた)ので、本来ならFP8はFP16の2倍の処理性能が発揮できるはずなのが、FP16と同じ性能でしかなかった。このあたりがハードウェアでサポートされたことによって、性能が4倍に向上した格好だ。
現時点ではまだ実際にLLMなどを動かした場合の結果などは示されていないので、現時点ではピーク性能のみが示されている。
コンピュート性能が3.3倍の向上なのに対し、エネルギー効率は2.4倍の向上ということで、要するに消費電力は1.375倍に増えている計算になる
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第898回
PC
AI特化とは一線を画すHPCの怪物! 富士通「Monaka」が目指す3D積層と256bit SVE2の真価 -
第897回
PC
NVIDIA独自コア「Olympus」の真価 Vera CPUが見せたIPC全振りの重厚構造とメモリー帯域依存 -
第896回
PC
Arm自社設計「AGI CPU」の全貌、10-wideデコードと2ダイ構成で見せた優等生的な実力 -
第895回
PC
IBM ZがArmを取り込む衝撃! 次世代メインフレーム「z18(仮)」のネイティブDual-ISA戦略の狙い -
第894回
PC
AMD「Ryzen AI Embedded X100」のリアルタイムAI制御が、Jetsonの弱点であるCPU性能を突く -
第893回
PC
インテル製GPU「Crescent Island」の正体、容量480GBメモリーでエージェント型AIとKVキャッシュ問題に挑む -
第892回
PC
Hot Chipsで明かされた「Wildcat Lake」の全貌 Foverosを捨てMCPを選んだインテルの舞台裏 -
第891回
PC
謎多き次世代Xeon「Diamond Rapids」を解剖、3D Meshの進化と新命令セットAPXがもたらす変革 -
第890回
PC
Samsung「SF2P」の全貌! GAA最大の弱点であるPMOS性能低下を克服し、TSMC追撃へ準備万端 -
第889回
PC
なぜ巨大チップは歪んで壊れるのか? SK HynixのHBM4「MR-MUF」とTSMCのCoWoS-Lを襲う熱膨張の罠 - この連載の一覧へ