

ロードマップでわかる!当世プロセッサー事情 第899回
NVLink追撃の現実解「UALoE」 AMD Instinct MI400が挑む次世代ラック実装とBlackwell対抗
2026年10月26日 12時00分更新


スケールアップ・ネットワークを加速する「UALoE」の正体とHeliosラックでの実装
ここまではあまり目新しい話ではないのだが、今回の大きな特徴が記事冒頭の画像でも出てきたUALoEである。連載851回ではインフィニティ・ファブリックを使ってのスケールアップ接続かもと説明したのだが、これは完全に間違いであった。そこで、UALoE周りの話を説明しておきたい。
AMDらは2024年、Ultra Accelerator Link(UALink) Consortiumを設立した。このUALinkは、スケールアップ・ネットワーク向けのオープンな標準規格であり、実際2025年にRevision 1.0の仕様が公開され、現在はRevision 2.0もリリースされている。
このUALink、物理層はイーサネットないしPCI Expressを前提にしており、その上に軽量な独自通信プロトコルを実装する形で実現している。このプロトコルの話を始めるとそれだけで膨大な量になってしまうので今回は割愛するが、目的はNVLinkと同様に複数のGPU間で高速なメモリー転送を行なうためのものである。
したがって、NVLink同様長距離の接続は考えていない。昨今ではデータセンターの大きさが一辺数kmのケースもあって、実はデータセンターの接続用イーサネットもケーブル長が1km超えが珍しくないのだが、スケールアップ・ネットワークに関しては原則が1本のラック内、拡張してもラック数本の範囲に留められている。
またイーサネットでは複数のスイッチを経由して接続されることがあるが、スケールアップ・ネットワークでは原則スイッチは1つだけである(最近NVIDIAはこれを破って2段構成のスイッチを導入予定であり、こうなると最大で間に3つ入る計算になるが)。
またスケールアップ・ネットワークの目的は先に少し触れたが「メモリー転送」である。これはあるGPUのローカルメモリーの内容を、他のGPUがリモートからアクセスする(リード/ライトの両方がありえる)というもので、帯域も重要ながらレイテンシーが非常に重要視される。
逆に、通信相手は決定論的に決められることが多い。少なくとも普通のイーサネットのように、パケット単位で相手が違うことはない。
こういった普通のイーサネット(AI業界では最近これをスケールアウト・ネットワークと呼ぶ)とは異なる要求があり、これに向けて最適化したものがUALinkであり、200GイーサネットをベースにしたUALink 200Gの場合はリンク1本あたり200Gbpsで、RTT(Round-Trip Time:送り出したメッセージが相手に受け取られ、即時に返された返答メッセージが自分に戻るまでの時間)が1μsとされている。
さてこのUALinkをさらにイーサネットの上に載せたのがUALink over Ethernet、略してUALoEである。実はこのUALoEはUALink Consortiumではなく、OCP(Open Compute Project)のほうで策定されている規格である。これはAMDなどが中心になって策定作業をしており、今回MI450シリーズに早くも実装されることになった。
もともとUALinkは物理層にイーサネットを使っているので、なぜイーサネットの上にUALinkを載せるんだ? という疑問があるかもしれないが、UALinkの場合物理層は「ほぼ」イーサネットと同じ(微妙に変更点はあるが多くはない)なのだが、その上がまったく異なる。
したがって、UALink用のSwitchに関しては新規に開発する必要があるが、これには時間がかかるため、Heliosの実装に間に合わない。そこでイーサネットの上にUALinkのプロトコルを通すという妥協案を開発した。これならスイッチはイーサネット用のものがそのまま使えるからだ。
ただしイーサネットのプロトコルをそのまま使うため、レイテンシーはUALinkそのものよりも大きくなる(おおむね2μsとされる)という大きな欠点があるのだが、今回は性能よりも実装時間の短縮を狙ったのだろう。将来のHeliosやその後継製品では、UALoEではなくUALinkに一本化される可能性がある。
ということで下の画像がInstinct MI455Xを搭載するシャーシの構造である。
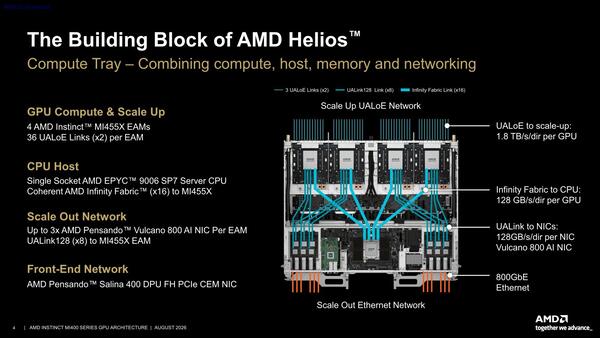
Instinct MI455Xを搭載するシャーシの構造。"3 UALoE Links"というのは、全部真面目に配線を描いていると線が潰れて重なるので、3 Linkをまとめて1本で表現したの意味である
1つのInstinct MI455Xからは、以下のインターコネクトが出ている。
- CPU(EPYC 9006 SP7)と接続するインフィニティ・ファブリック x16(PCIe Gen6と共通)、128GB/秒
- スケールアウト用にUALink128(物理層がPCIe Gen6 x8のUALink)×3
- スケールアップ用にUALoE×36
UALoEは物理的には72レーンだが、2レーンで1本のリンクを構成する関係で、×36という格好だ。一方これと接続されるスイッチのが下の画像である。1枚のシャーシに2つ搭載されている格好だ。
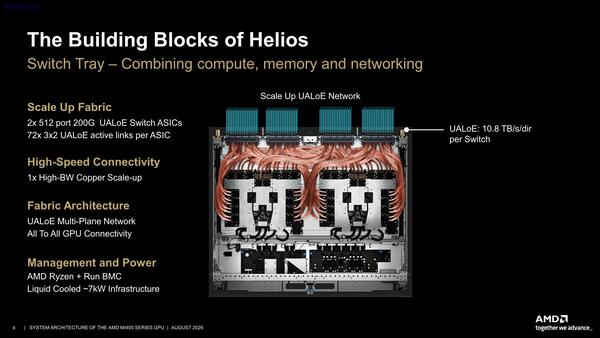
スイッチそのものはBroadcomのTomahawk 6と思われる
接続図は下の画像の通りで、UALoEの1本のリンクは1.2Tbpsになる計算だ(200G×2×3)。
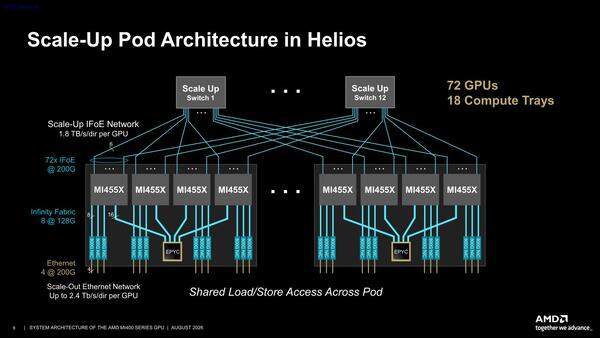
NVLinkはスイッチトレイが9本だったが、Heliosでは6本になっている。このあたりは動かすLLMの構成次第ではあるのだが、一般論としてスイッチトレイは多いほうが柔軟性が高まる
これはBlackwell(100GB/秒×18)とトータルでは同等、Rubin(100GB/秒×36)の半分でしかないが、第一世代であることを考えるとこんなものだろうという気はする。
Heliosラックでの実装が下の画像だ。左が正面から見たもの、右が背面から見た部分だ。
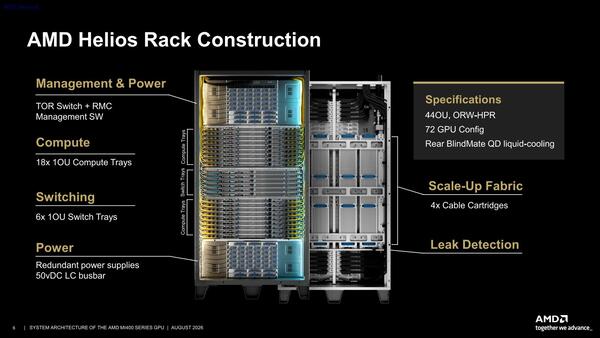
ケーブルベースのOberonラックの場合、そのケーブルがシャレになってなかったことを考えると、本当にこんな風にスッキリ収まるのであればPCBベースの配線で接続する形になっているのだろう
UALoEのケーブルは、"4x Cable Cartridges"に収められている。内部的にはおそらくケーブルではなく、(NVIDIAのRubin Ultraほど極端ではないにせよ)PCBベースではないかと思うが、この辺はまだ明らかにされていない。
ということでInstinct MI455Xに関してある程度不明だった部分が解決したので、説明してきた。他にもVulcano AI NICやZen 6 EPYCの話などもあったのだが、今回それは主題ではないので割愛させていただく(いずれ機会があったらまた説明したい)。
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第898回
PC
AI特化とは一線を画すHPCの怪物! 富士通「Monaka」が目指す3D積層と256bit SVE2の真価 -
第897回
PC
NVIDIA独自コア「Olympus」の真価 Vera CPUが見せたIPC全振りの重厚構造とメモリー帯域依存 -
第896回
PC
Arm自社設計「AGI CPU」の全貌、10-wideデコードと2ダイ構成で見せた優等生的な実力 -
第895回
PC
IBM ZがArmを取り込む衝撃! 次世代メインフレーム「z18(仮)」のネイティブDual-ISA戦略の狙い -
第894回
PC
AMD「Ryzen AI Embedded X100」のリアルタイムAI制御が、Jetsonの弱点であるCPU性能を突く -
第893回
PC
インテル製GPU「Crescent Island」の正体、容量480GBメモリーでエージェント型AIとKVキャッシュ問題に挑む -
第892回
PC
Hot Chipsで明かされた「Wildcat Lake」の全貌 Foverosを捨てMCPを選んだインテルの舞台裏 -
第891回
PC
謎多き次世代Xeon「Diamond Rapids」を解剖、3D Meshの進化と新命令セットAPXがもたらす変革 -
第890回
PC
Samsung「SF2P」の全貌! GAA最大の弱点であるPMOS性能低下を克服し、TSMC追撃へ準備万端 -
第889回
PC
なぜ巨大チップは歪んで壊れるのか? SK HynixのHBM4「MR-MUF」とTSMCのCoWoS-Lを襲う熱膨張の罠 - この連載の一覧へ