ロードマップでわかる!当世プロセッサー事情 第898回
AI特化とは一線を画すHPCの怪物! 富士通「Monaka」が目指す3D積層と256bit SVE2の真価
2026年10月19日 12時00分更新


低電圧駆動と独自キャッシュ・レジスター機構に見る富士通の設計手腕
次が発熱および電力供給について。一番発熱が多くなるのは当然コアダイであり、ここが一番消費電力を喰う(SRAMダイは当然発熱が一番低い。IOダイはPHY周りが発熱が多くなると思われる)ので、その一番発熱の多いコアダイが一番上に来るのは理に適っている。
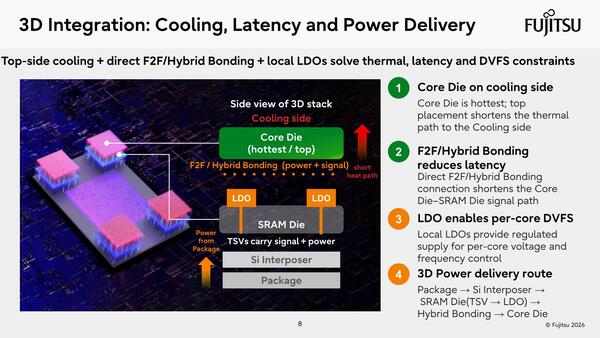
SoICを利用した3D積層により、LDO(後述)をコアごとに用意可能になった。当然これはコアごとに細かく電圧調整が可能という意味である
それともう一つ特徴的なのは、SRAMダイの中にコアダイ用のLDO(Low Drop Out)レギュレーターを実装していることだろう。
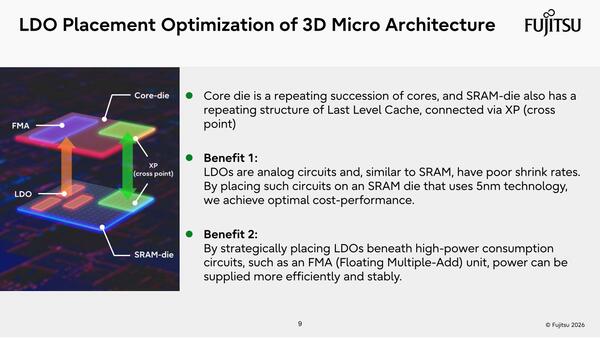
LDO配置の最適化。実際にはコアダイには36コアが格納されているので、LDOはつまりその36コアのSVE2ユニットの真下に分散配置される形と思われる。一方L3へのアクセスはまとめてXPというエリアで集中的に接続される形に見える
LDOならシリコンダイの中に楽に実装できるし、実際Ryzenのように実装されている例もあるからこれが珍しいわけではないのだが、これとSoICを組み合わせるのは中々のアイデアである。
しかもMonakaの場合、フル稼働時に一番消費電力が多くなると予測されるのはSVE2ユニットである。そこで、SRAMダイのちょうどSVE2ユニットの真下にLDOを搭載することで、効率よく電力供給することを狙っている。この実装はなかなか独特である。
プロセス周りに関してはもう1つ、動作電圧を定格より3割ほど落とすことで、消費電力を5割近く減らす取り組みも行われている。
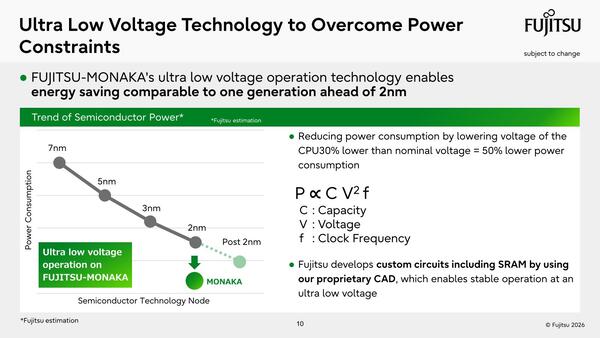
この代償は動作周波数の低下である。後で出てくるが、高効率SKUでは2.1GHz動作に過ぎない。逆に2.9GHzで動作する高性能SKUはもう少し動作電圧を上げている可能性が高い
これにより、性能効率は大幅に向上することが予測できる。旧Esperanto TechnologyのET-SoC-1を連想するものがある。そういえば古い話になるが、そのEsperanto Technology創業者のDavid Ditzel氏がTransmeta時代にLongRun 2というやはりBody Biasを利用して動作電圧のバラつきを抑えるとともに駆動電圧を下げる省電力技術を富士通などにライセンス供与していたことを思い出す。
さて次はコアの話である。L2まで含めたコアのサイズは1.47mm2とあるので、これを36コア集めたダイのサイズは52.92mm2ほどになる。このサイズでは、冗長コアを用意する必要はそれほどなさそうな気もする。
ただA64FXの時代は1個のダイに48のコンピュートコア+OSの処理やI/Oを担当するアシスタントコアを4の合計52コアで構成されていたことを考えると、実際には40コアくらいの構成で、うち36がコンピュート向けという可能性もあるのだが、そうだとしても58.8mm2ほど。
実際にはコアとは別にSRAMダイと接続するXPの領域や、あとコア同士のインターコネクトなどもあるだろうが、それでも80mm2まで行くかどうか。実際には70mm2程度の可能性もある。
そしてここまで説明してきたArmベースのCPUとの最大の違いは、SVE2が256bit幅なことだろう。実際にはこれが2つ搭載されており、それに合わせてロード/ストアユニットも512bit/サイクルでの転送が可能になっている。
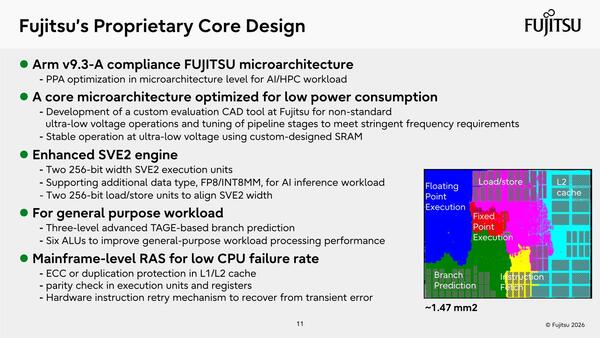
RAS機能などはSPARC時代から培ってきたものをそのまま応用しているものと思われる。あと分岐予測が3レベルのTAGEベースというのもなかなかすさまじい
パイプライン構造は下の画像の通り。画像にある略語は下表を参照してもらいたい。
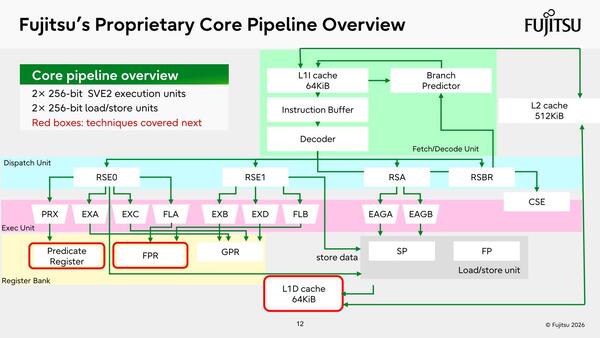
パイプライン構造。あまり普通見かけないのがPRX(Predicate execution Unit)である。PRXについては後述する
| 略語の意味 | ||||||
|---|---|---|---|---|---|---|
| RSA | Reservation station for address generation | |||||
| RSE | Reservation station for execution | |||||
| RSBR | Reservation station for branch | |||||
| GPR | General-purpose register | |||||
| FPR | Floating-point register | |||||
| CSE | Commit stack entry | |||||
| EAG | Effective address generator | |||||
| EX | Integer execution unit | |||||
| FL | Floating-point execution unit | |||||
| PRX | Predicate execution unit | |||||
| SP | Store port | |||||
| FP | Fetch port | |||||
| RSE | Reservation | |||||
Fetch/Decodeの性能やRSE/RSAのエントリー数などは未公開であるが、そもそもALUがEXA~EXDの4つ+FLA+FLBの6つなので、AGI CPUやVeraよりは少ない(Fetch/Decodeは多くても8命令/サイクル程度)と推察される。
ただそれでも256bit SVE2の威力は大きいわけで、後で性能の数値は出てくるがFP64のGEMMの性能は6013GFlopsという猛烈なものになっている。一応Monakaは汎用のArm64プロセッサーであり、汎用のプログラムもそれなりに動作するが、そこでのピーク性能はAGI CPUやVeraにはおよばないだろう。
その一方で、数値演算を行なった場合の性能はAGI CPUやVeraを凌ぐものになると考えられる。このあたりは明らかに設計方針の違いというべきか。
ところで上の画像で赤い枠が3つほどあるが、これがMonakaの特徴的なユニットである。まずFPR(Floating-point register)。ここではFPR cacheと説明されているが、要するに初回にFPRにメモリーからデータを取り込む際に、それに続くデータもまとめて取り込んでそれをFPR cacheに格納しておくことで、次のデータアクセスのためにメモリーを参照する必要がなくなる、という一種のプリフェッチ機構である。
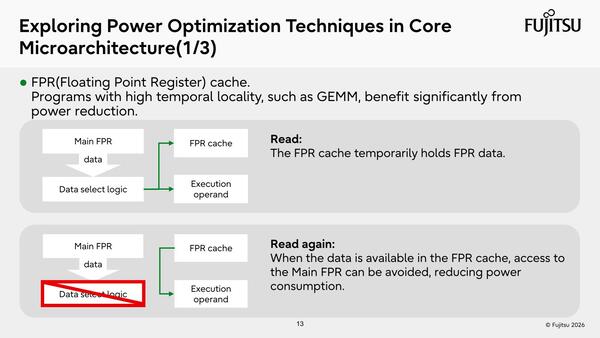
FPR cacheがFPRとは別に用意されているのか、それとも空いているFPRにプリフェッチ的にデータを格納しておくだけなのかは不明。実装のコストを考えると、空いているFPをキャッシュ的に使う実装だろう
次がPredicate Register。これは、同じ命令が延々と繰り返されるようなパターンでの処理を高速化するための仕組みで、これを利用することで無駄にReservation StationやALUを動かさず、PRXとPredicate Registerの間だけで処理が済んでしまうというもののようだ。
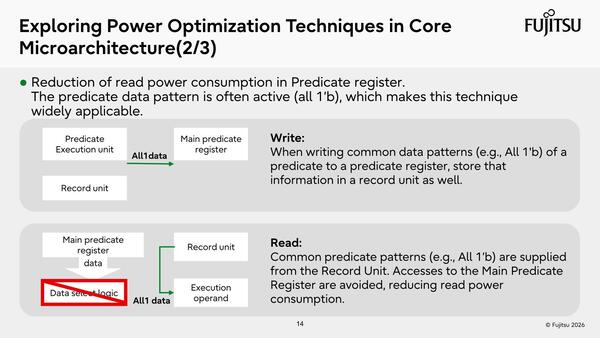
この説明を読む限り、PRXはPredicate Registerにパターンを記録するだけでなく、これそのものがALUとして動作するように見える。ただしその対象は同じパターンの繰り返しに限るという感じである。理屈はわかるが、そのパターンをどう動的に判断するのかの説明がもう少し聞きたいところだ
最後がL1 Dキャッシュ周りの工夫である。実はキャッシュラインサイズそのものは512bit幅だが、FPRなどはすべて256bit幅である。ただただこの状況でNEON命令を実行するとデータ幅は64/128bitになるので、256bit幅のFPRのうち128/192bit分は使われない。
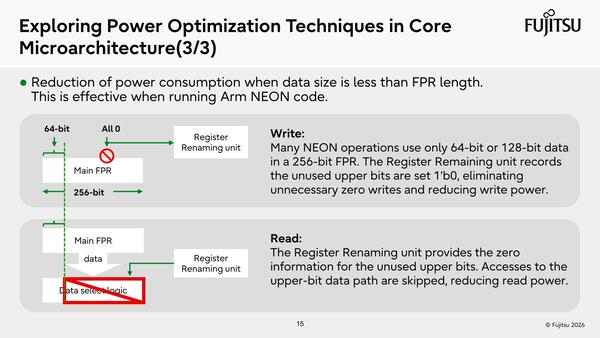
L1 Dキャッシュ周りの工夫。メモリー→キャッシュへはPredictionの形で512bit幅でデータが格納されるが、そこからFPRに取り込むのは64bitないし128bitに限られる
使われない部分にアクセスするのは無駄すぎる。そこで必要なデータ幅のみをアクセス、残りは0クリアし、不必要なリードアクセスもしないことで省電力化を図る、といった機構が組み込まれているようだ。
それと高効率化の機構として、Gather Accessのメカニズムも搭載されている。要するにキャッシュのラインサイズを跨ぐようなアクセス、あるいは1つのラインの中で不連続なアクセスを高速化するためのメカニズムである。
このCombined Gatherは自動で行なわれるが、A64FXの場合はコンパイルオプション(例えば -Khpctag:Sector CacheやCombined Gatherを効率的に利用するためのタグ情報の自動付与)を利用することで効率よく実行させるための手法が提供されており、おそらくMonakaも同じような形になるものと思われる。
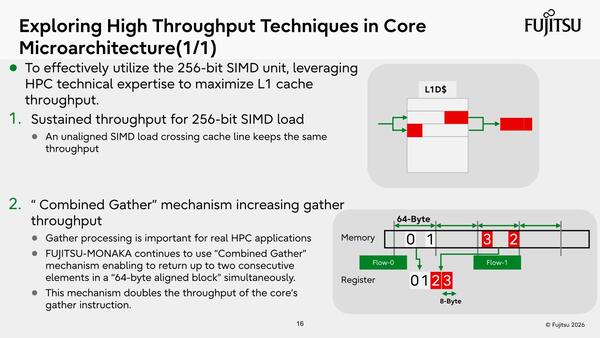
これはA64FXでもCombined Gatherという形でL1キャッシュに実装されていた。MonakaでもやはりL1にこれが実装されているようだ
ちなみにMonakaでは1/4/8 NUMA nodeの構成が提供されるとする。8NUMAということはメモリーは1chのみ占有になるので、帯域的にどうだろうという気もするのだが、全体で1 NUMA node/各コンピュートダイごとに1 NUMA node/各コンピュートダイごとに2 NUMA nodeという区分けになるのだろう。
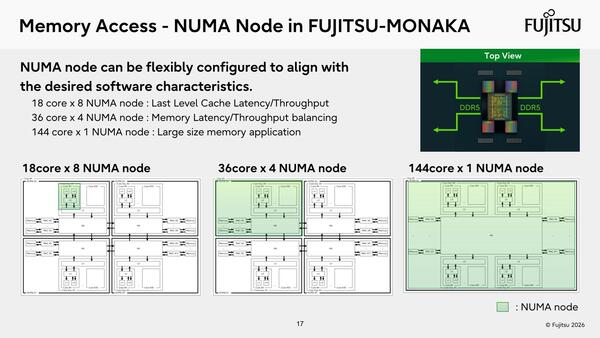
2 NUMA nodeが提供されないのが不思議ではある
NUMAの話のついでにメモリー階層を示したのが下の画像だ。A64FXとの最大の違いはHBMを廃してDDR5を12ch接続できるようにしたことで、これによりA64FXでは大きな問題だった「メモリー容量が足りない」問題はある程度解決される見込みが付いた。
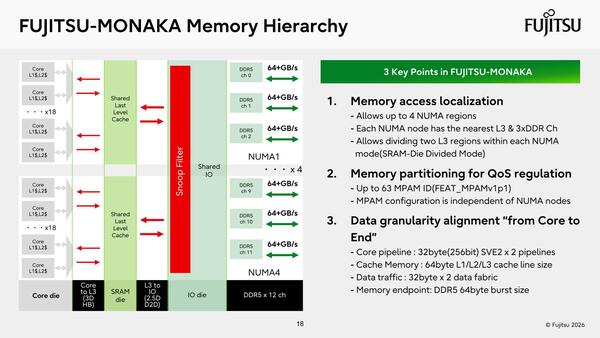
メモリー階層。NUMA 8の場合にはSLCも論理的に2つに分割できるようだ
その一方で、DDR5-8000×12chの帯域は768GB/秒でしかなく、これを144コアで分けると5.3GB/秒強でしかない。A64FXではHBM2×4で1024GB/秒の帯域があり、これを48コアで分割すると21.33GB/秒ほど。つまりMonakaのメモリー帯域はA64FXの4分の1でしかない。
これを補うのがSRAMダイに搭載されたSLC(Shared Last level Cache)であり、4つのSRAMダイで合計1.28GB(ダイあたり320KB)のSLCが搭載される。SLCも64Bytesのラインサイズとなっているので、L3へのCPUからのアクセスも最大64Bytes/サイクルで可能になる。
容量に限りがあるので(1.28GB÷144コア≒8.9MB)完全にHBMの代替にはならないにせよ、A64FXよりもずっと広い帯域をSLCから得られる。あとはうまくプリフェッチを駆使することで、メモリー帯域の問題にある程度の対応が可能な格好だ。
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第897回
PC
NVIDIA独自コア「Olympus」の真価 Vera CPUが見せたIPC全振りの重厚構造とメモリー帯域依存 -
第896回
PC
Arm自社設計「AGI CPU」の全貌、10-wideデコードと2ダイ構成で見せた優等生的な実力 -
第895回
PC
IBM ZがArmを取り込む衝撃! 次世代メインフレーム「z18(仮)」のネイティブDual-ISA戦略の狙い -
第894回
PC
AMD「Ryzen AI Embedded X100」のリアルタイムAI制御が、Jetsonの弱点であるCPU性能を突く -
第893回
PC
インテル製GPU「Crescent Island」の正体、容量480GBメモリーでエージェント型AIとKVキャッシュ問題に挑む -
第892回
PC
Hot Chipsで明かされた「Wildcat Lake」の全貌 Foverosを捨てMCPを選んだインテルの舞台裏 -
第891回
PC
謎多き次世代Xeon「Diamond Rapids」を解剖、3D Meshの進化と新命令セットAPXがもたらす変革 -
第890回
PC
Samsung「SF2P」の全貌! GAA最大の弱点であるPMOS性能低下を克服し、TSMC追撃へ準備万端 -
第889回
PC
なぜ巨大チップは歪んで壊れるのか? SK HynixのHBM4「MR-MUF」とTSMCのCoWoS-Lを襲う熱膨張の罠 -
第888回
PC
NVIDIA Rubin Ultra開発中止の真相! 180層CoWoS-Lの歪曲トラブルと、急造ラックNVL576に透ける苦肉の策 - この連載の一覧へ