2026年9月15日、GMOインターネットグループは「第4回 GMO大会議 秋 フィジカルAI 2026」を開催した。政府や企業、研究機関からフィジカルAIの専門家が集まり、日本がこの分野で競争力を高めるために何が必要なのか、さまざまな角度から議論が交わされた。
今回は、本イベントのパネルディスカッション「フィジカルAIを動かす学習データの作り方 ― 現場で集めるか、合成でつくるか」をレポートする。生成AIの大規模言語モデルはインターネット上の膨大なテキストを学習できるが、現実世界でロボットを動かすフィジカルAIでは、必要なデータを同じようには集められない。ロボットを実際に動かしてデータを取るのか、シミュレーションなどで合成するのか。そして、企業が持つ貴重な現場データをどこまで共有できるのか。産官の専門家がフィジカルAI時代のデータ戦略について語った。
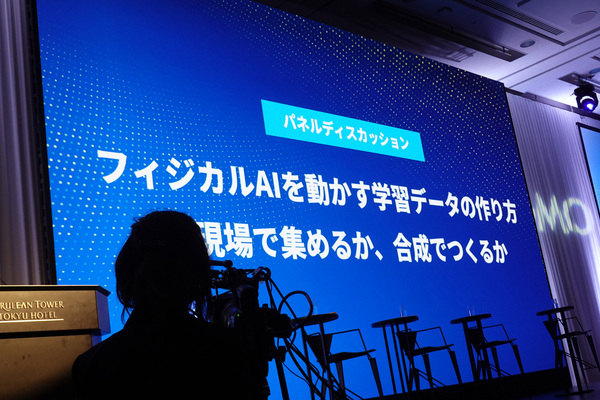
経産省、PFN、AIRoA、テレイグジスタンスが学習データの作り方を議論した
フィジカルAIの学習データはどこから集める?
パネルディスカッションに登壇したのは、経済産業省 大臣官房審議官 奥家敏和氏、Preferred Networks 共同創業者 代表取締役社長 岡野原大輔氏、一般社団法人AIロボット協会(AIRoA)CTO 松嶋達也氏、テレイグジスタンス 共同創業者兼CTO 佐野元紀氏。モデレーターは、GMOインターネットグループ サイバー防衛事業推進本部「6」本部長で元陸上自衛隊陸将の廣惠次郎氏が務めた。
廣惠氏:LLMを作るためのデータはインターネット上にたくさんあります。しかし、今日のテーマはフィジカルAIです。AIが体を持ったとき、その体を動かすためのデータは世の中にそれほどありません。これから大量に必要になるデータを誰が、どうやって作るのかという問題があります。
さらに、これまでは現場で一生懸命データを集めてきましたが、最近はコンピューター上で合成データも作れるようになりました。だからといって現場のデータが不要になるわけではありません。まず、現在はどんなデータを集めているのでしょうか。
佐野氏:私たちが今、一番重要だと考えているのは、実際のロボットを操作したデータです。ロボットの腕の関節をどの角度にして、何を見ながら、人間がどう動かしたのか。そうしたロボットそのものをダイレクトに動かしたデータをまず集めています。
一方で、実機を使ったデータ収集はコストが高いので、より抽象度の高いデータを取る方法もあります。人間の手の動きをデバイスで取得したり、人間の動きをモーションキャプチャーしたりする方法です。いろいろな階層のデータがありますが、実際のロボットを動かしたデータが最も価値が高いと考えています。
廣惠氏:AIRoAでは、さまざまな種類のデータを集めています。現在はどのような状況なのでしょうか。
松嶋氏:遠隔操作でロボットを動かしたデータもありますし、手に持ったデバイスで手先の位置や姿勢を集めるハンドヘルド型のデータ、シミュレーションで作るデータなどもあります。私たちはそれらを組み合わせて集めています。
特定のロボットに特定のタスクをさせたいなら、そのロボットを実際に動かしたデータが学習には一番強いです。ただし、実ロボットを遠隔操作してデータを取るのはコストが高い。ハンドヘルドならいろいろな環境で簡単に集められますが、実際のロボットとの距離は少し遠くなります。どの種類のデータを、どんな比率で、どのくらい集めればいいのかを探っている段階です。
廣惠氏:規模感としては、どのくらいのデータが必要なのでしょうか。
松嶋氏:まだ世界中で推定している段階ですが、汎用的な事前学習に使うなら、実ロボットのデータは数十万時間規模が一つの目安になるのではないかと考えています。さらに、その10倍程度のハンドヘルドデータや、もっと大規模な人間視点のデータを組み合わせる、といった考え方です。どの数字が正解なのかは、まだ誰もわかっていません。
廣惠氏:国から見ると、こうしたデータがどこにあるのかは把握できているのでしょうか。
奥家氏:公開されていて使えるものはHugging Faceなどにもありますし、ロボットを動かして集めたデータや人間視点のデータについては、使えるものをAIRoAにできるだけ集約する取り組みも進んでいます。ただ、それだけではありません。製造現場など企業の中には、まだAIで活用されていない大量の非構造化データがあります。
今は、そうしたデータをAIが学習できる形に変え、フィジカルAIにもつなげていこうとしています。ロボットだけを見るのではなく、企業の中に眠っているデータまで含めて、学習結果を現場までつないでいく仕組みを作ろうとしているところです。
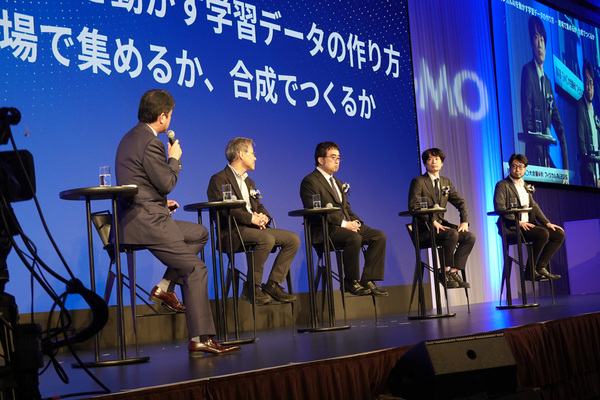
左から、廣惠次郎氏(GMO)、奥家敏和氏(経産省)、岡野原大輔氏(PFN)、松嶋達也氏(AIRoA)、佐野元紀氏(テレイグジスタンス)
合成データがあれば、もう現場で集めなくてもいい?
廣惠氏:ここからが本題です。リアルデータと合成データを、これからどう使い分けるのでしょうか。コンピューターで大量にデータを作れるなら、「これからは合成データでいいのでは」とも考えたくなります。
岡野原氏:画像や映像、音声では、合成技術がかなり整ってきました。ただし、何もないところからすべてを作るというより、実際に取得したデータをベースに環境や条件を変える使い方が多いです。
フィジカルAIでは、ロボットの身体や周囲の環境、実行するタスクなど、現実に取れる条件がどうしても限られます。そこで、一つの環境で取得したデータから異なる条件のデータを作り、多様性を増やします。多少品質が落ちても、未知の状況に対応する能力を高めるために役立ちます。
一方で、触覚や未知の物理現象に関係するセンサーになると、状況が変わります。そもそも物理現象をどうシミュレーションすればいいのか、実データとの違いをどう埋めればいいのかという研究がまだ必要です。そこはリアルデータをきちんと集めながら進めなければなりません。
廣惠氏:実際にロボットを現場で運用している立場では、やはりリアルデータが重要なのでしょうか。
佐野氏:基盤モデルに学習させるデータとしては、やはりそのロボット自体を現場で動かしたデータが一番価値が高いと思っています。ただ、合成データを生み出せるワールドモデルそのものには、とても大きな可能性を感じています。
例えば、新しく作ったモデルを実機で動かして検証するのは非常にコストが高いです。その前にワールドモデルの中で動かしてみて、どんな反応をするのか、ある程度賢く動けそうなのかを確認できれば、実機での検証を減らせます。合成された映像そのものを学習に使うだけでなく、世界の変化を理解しているモデルを検証環境として使う価値も大きいと思います。
廣惠氏:松嶋さんはリアルデータと合成データを両方扱っていますが、実際にはどう使い分けていますか。
松嶋氏:シミュレーションだけで学習して実機に持っていく方法は、ロボットでは以前から使われています。ただ、私たちが作りたいのは、いろいろな物を扱える汎用ロボットのモデルです。現実世界にある家具や道具を3D空間ですべて再現しようとすると、IKEAに行って実物を買ってきた方が早い、ということもあります。
そこで基本になるデータはリアルで集めます。ただ、それだけで物の配置や色、物理的な特性をすべてカバーすることはできません。リアルで集めたデータをベースに、シミュレーションで条件を変えてデータを拡張する。リアルか合成かの二者択一ではなく、組み合わせて使うのが基本になります。
企業が集めた貴重なデータは、どこまで共有できる?
廣惠氏:もう一つ大きな問題があります。これだけ価値のある学習データを誰が作り、それは誰のものになるのかという問題です。佐野さんのような事業会社からすると、自社でコストをかけて集めたデータを業界の共有財として出すことには難しさもありますよね。
佐野氏:事業会社なので、自分たちで集めたデータの主権は当然持っていたいです。自社の事業の強さに直結する部分まで、すべて外に出すことはできません。
ただ、今の基盤モデルは、一社だけですべてを作って商用化まで一点突破できる段階ではないとも思っています。基盤となる部分は業界横断で底上げする必要があります。例えば、コンビニの特定の店舗でしか使わない動きではなく、物をつかむ、運ぶといった汎用化に効く基本動作を共有して全体を強くする。その上で、自社が強い部分を自分たちで持つという形です。共有した成果は、最終的に自社にも返ってくると思っています。
廣惠氏:AIRoAでは、企業にデータを出してもらうために、どのような仕組みを考えていますか。
松嶋氏:一社だけを強くするのではなく、その業界全体を一緒に底上げしましょうという形で進めています。例えば小売業なら、実運用に近い環境でデータを作り、ある程度汎用的に使えるモデルまでは共同で作る。そこから先の各社固有の実運用は、それぞれの会社でやってもらうという区分けです。
廣惠氏:経済産業省から見て、企業がデータを共有することへの意識は変わってきていますか。
奥家氏:以前は企業もデータについて非常に保守的でしたが、この2年弱で空気はかなり変わりました。フィジカルAIを念頭に置いて、企業が持つデータをAIで利用できる形にするAI-Ready化も進み、どこまでなら協力できるかという議論ができるようになっています。
わかりやすい例を挙げると、潜水艦の溶接データは絶対に外には出せません。しかし、特殊な溶接を学習するためにも、その前段階となる一般的な溶接動作は必要です。一般的な動作なら各社で出し合って基盤モデルを強くし、潜水艦向けの特殊な部分は自社で追加学習する。そうした切り分けなら協力できる、という理解が広がっています。
社会実装を増やし、現場のデータを次につなげる
廣惠氏:最後に、フィジカルAIをここから一気に進めるためのボトルネックは何でしょうか。それぞれ一つ挙げていただけますか。
佐野氏:もう、やり続けるしかないと思っています。ロボットが普及しないからデータが集まらず、データがないから賢いロボットを作れないという鶏と卵の問題です。それでも前に進み続けるしかありません。
松嶋氏:汎用ロボットが自分たちの職場に来たら、何をやってほしいのかを想像することが大事だと思います。そこから逆算すると、どんなデータを取らなければならないのかが見えてきます。
岡野原氏:社会実装の事例を少しでも増やしていくことだと思います。「フィジカルAIをこう使う」という具体的なイメージが増えれば、必要な学習データも見えてきますし、データを集めようという機運も生まれます。
奥家氏:もう一つお願いしたいのは、データを簡単に捨てないでほしいということです。データは保存するストレージにもお金がかかるので、価値がわからないまま捨ててしまうケースが実際にあります。
自分たちには使い道がわからなくても、別の人から見ると大きな価値を持っているかもしれません。捨ててしまったり死蔵させたりする前に、詳しそうな人や仲間に聞いてみてほしい。フィジカルAIでは、これまで価値が見えなかった現場のデータが、新しい学習資源になる可能性があります。
フィジカルAIの開発競争では、モデルの性能だけでなく、現実世界からどれだけ良質なデータを集められるかが勝負を左右する。今回の議論から見えてきたのは、リアルデータか合成データかを選ぶのではなく、実機から得たデータを軸に、シミュレーションで多様性を広げていく方向性だ。同時に、汎用的に使えるデータは業界で共有しつつ、競争力に直結する部分は各社が守るという役割分担も必要になる。社会実装が増えれば、そこから新たなデータが生まれ、さらに賢いロボットを作れるようになる。この循環をどれだけ早く回せるかが、日本のフィジカルAIの競争力を決めることになりそうだ。
本記事はアフィリエイトプログラムによる収益を得ている場合があります