

ロードマップでわかる!当世プロセッサー事情 第797回
わずか2年で完成させた韓国FuriosaAIのAIアクセラレーターRNGD Hot Chips 2024で注目を浴びたオモシロCPU
2024年11月11日 12時00分更新


テンソル縮約に特化した内部構造
さて第1世代のWarboyでは公開されなかったNPUの中身である。RNGDではTCP(Tensor Contraction Processor)と呼んでいるが、そもそも畳み込みニューラルネットワークなどでは計算の大半がテンソル縮約(Tensor Contraction)の計算に費やされている。
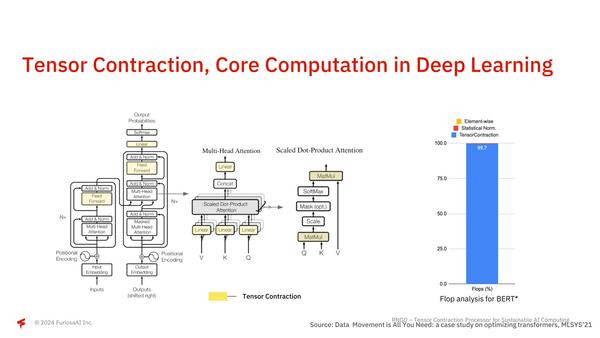
左は実際の処理の中でテンソル縮約が使われる箇所、右はBERTを実施する際の処理の比率で、もうとにかく大半がテンソル縮約であることがわかる
このテンソル縮約は要するに行列積(Matmul)であって、世の中に多く存在するテンソル演算用のアクセラレーター(例えばNVIDIAのGPUに搭載されるTensor Core)はこの行列積を高速に実行するための機構を搭載しているのだが、テンソル縮約≠行列積ではない、とFuriosaAIは主張する。

大抵の行列積の演算は、行列のサイズが決め打ちであり、大規模なテンソル演算の場合には行列を分解して処理をする
要するに扱うべき行列のサイズは、大抵の行列積演算ユニットのものよりはるかに大きいので、固定サイズの行列積演算ユニットを使うのは不効率、というわけだ。RNGDはこれをどうしたかというと、行列のサイズに合わせて行列積の計算に使うコンピュートユニットの数をダイナミックに変更しながら、目的のサイズの行列積を一発で行なえる、というところが異なるとする。
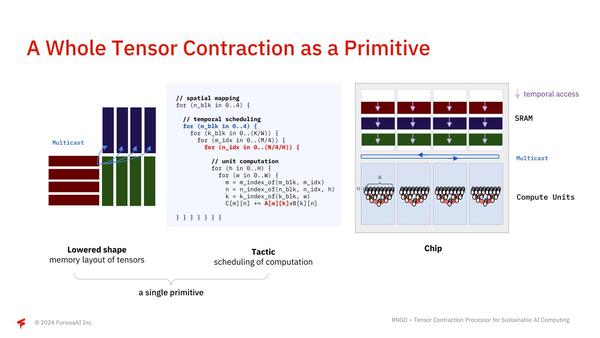
赤と青はそれぞれ積の対象となる行列の要素が入り、緑に演算結果が入る。赤のデータをすべてのコンピュートユニットにマルチキャストする機能が入っているのがポイント
下の画像左側がそのRNGDの構成で、1個あたり64TOPS/32TFlopsの演算性能と32MBのSRAMを搭載するTensor Unitが8つ搭載されている。右側はその個々のTensor Unitの構成で、内部的には8つのプロセッサー・エレメントが配される。

普通は個々のプロセッサー・エレメント内のメモリーと演算ユニットが密結合されており、間にスイッチが入るのはかなり珍しいというか、独特である
ここでFetch/Commit Sequencerと、テンソル縮約を行うContraction EngineやVector Engine/Transpose Engine/Commit Engineの間にスイッチが入っているのがミソで、大規模な行列に対してすべてのContraction Engine類が協調する形で処理できるようになっている。また個々のTensor Unitの間は非常に高速なNoCでつながっており、HBM3の帯域をすべてのTensor Unitで使い切れるような構成になっている。
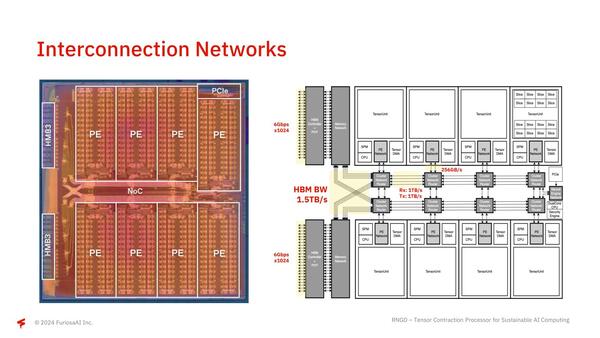
このネットワークは単にHBMとのやり取りだけでなく、Tensor Unit同士での接続にも使える模様。例えば1つのTensor Unitでは収まりきらないような大規模な行列の場合、複数個のTensor Unitで連携して処理できるようだ。それにしてもPCIeのI/Fがずいぶん変なところにある気がする
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第896回
PC
Arm自社設計「AGI CPU」の全貌、10-wideデコードと2ダイ構成で見せた優等生的な実力 -
第895回
PC
IBM ZがArmを取り込む衝撃! 次世代メインフレーム「z18(仮)」のネイティブDual-ISA戦略の狙い -
第894回
PC
AMD「Ryzen AI Embedded X100」のリアルタイムAI制御が、Jetsonの弱点であるCPU性能を突く -
第893回
PC
インテル製GPU「Crescent Island」の正体、容量480GBメモリーでエージェント型AIとKVキャッシュ問題に挑む -
第892回
PC
Hot Chipsで明かされた「Wildcat Lake」の全貌 Foverosを捨てMCPを選んだインテルの舞台裏 -
第891回
PC
謎多き次世代Xeon「Diamond Rapids」を解剖、3D Meshの進化と新命令セットAPXがもたらす変革 -
第890回
PC
Samsung「SF2P」の全貌! GAA最大の弱点であるPMOS性能低下を克服し、TSMC追撃へ準備万端 -
第889回
PC
なぜ巨大チップは歪んで壊れるのか? SK HynixのHBM4「MR-MUF」とTSMCのCoWoS-Lを襲う熱膨張の罠 -
第888回
PC
NVIDIA Rubin Ultra開発中止の真相! 180層CoWoS-Lの歪曲トラブルと、急造ラックNVL576に透ける苦肉の策 -
第887回
PC
AIなしではもはや限界 TSMCが明かすメモリー開発にAIが不可欠となった現実 -
第886回
PC
CFETの足を引っ張るPMOSを救え! imecが提案する新絶縁層と、あえて精度を緩める「Notch Alignment」の妙手 - この連載の一覧へ