ロードマップでわかる!当世プロセッサー事情 第766回
Instinct MI300のI/OダイはXCDとCCDのどちらにも搭載できる驚きの構造 AMD GPUロードマップ
2024年04月08日 12時00分更新


AMDのInstinct MI300に関しては連載701回や連載726回、連載751回などで説明してきたが、今年のISSCCでAMD自身によるDeep Diveの説明があったので、この内容を解説しよう。といっても性能に関しては言及がなく、焦点は3D構造の実装になる。
複雑なMI300A/Xの内部構造
IODは共通で、XCDとCCDのどちらも搭載できる
まずおさらいであるが、MI300A/Xともに複数のGPU(XCD)と、MI300AはさらにCPU(CCD)を、インフィニティ・キャッシュを搭載したI/O Die(IOD)の上に搭載、さらにこのIOD同士を2.5Dで接続し、外付けに8スタックのHBM3を接続する構造になっている。
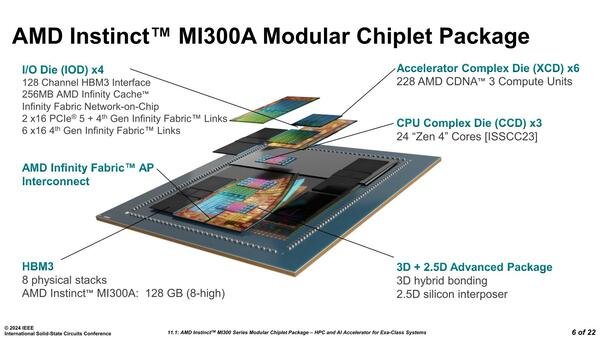
MI300Aの構造。MI300XではCCDがなく、代わりにXCDが×8になる
ちなみにIODの説明だが、128chのHBM3チャンネルや256MBのインフィニティ・キャッシュは4つのIODの合計の数字であり、IOD1つあたりで言えばインフィニティ・キャッシュは64MB、HBM3は32ch(HBM3は1スタックあたり16chのI/Fを持つ)という計算になる。
インフィニティ・ファブリック・リンクの数とPCIeの数が割り切れないのは、おそらくおのおののIODには64ch分のPCIe/インフィニティ・ファブリック共用のPHYが用意されており、インフィニティ・ファブリックは32ch分で1リンクとなるのだろう。したがって4つのIODで合計256chのPHYがあり、このうち224chは7本のインフィニティ・ファブリック・リンクに割り当てられ、残りの32chが2×PCIe Gen5x16に割り当てられるという構造と考えられる。
下の画像が内部構造図なのだが、これはややわかりにくい。左側はあえて簡略化しているのだろうが、XCDには40個のCUが搭載されており、うち2つが無効化され実際に利用されるのは38CUである。これが8つでトータル304CUというわけだ。
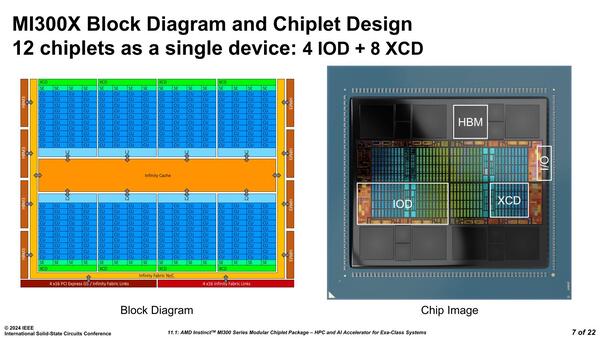
ほかに1つのXCDには4つのACE(Asynchronous Compute Engines)が搭載されており、SEはこのACE(と、その下におのおの8つのHQD:Hardware Queue Descriptors)を指しているものと思われる
2次キャッシュは4MBであるが、メモリー階層構造を見る限り、この2次キャッシュは1つのXCD内のCUで共有という形であり、異なるXCD同士の2次キャッシュは上位のクロスバー(つまりインフィニティ・キャッシュ)経由での接続になるので、グローバル・キャッシュというよりはローカル・キャッシュとみなすべきなのだろう。
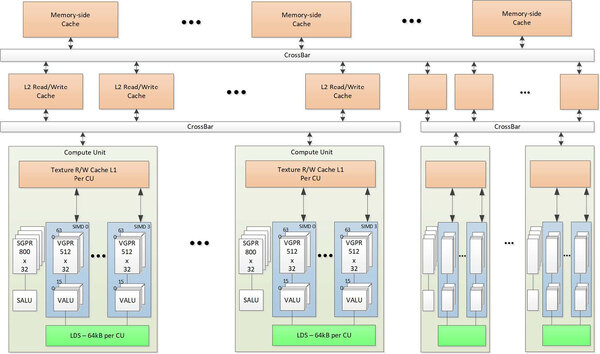
メモリー階層構造。一番下段の箱がCUである。画像を扱うわけではないのに"Texture R/W Cache"というのも変な気がする
"AMD Instinct MI300 Instruction Set Architecture Reference Guide"より抜粋
まず実装方法である。先に書いたように、XCD/CCDはIODの上に載っているが、XCDおよびCCDはどちらも一種類で、これをそのまま載せるか、180度回転させて載せるかであるが、IODに関してはやはりミラー構造を採用することになった。

これはMI300Aの場合で、MI300Xの場合は右上のIODの上にCCDではなくXCDが載るわけだ
このミラーというのは、要するに鏡対称のことだ。これ、Sapphire Rapidsの構造の議論のところでも出てきた話だが、上の画像で言えば左上のIODと左下IODは、回転させてもいろいろつじつまが合わないことになる。
左上と左下は、ちょうど真ん中で相互接続する必要があるし、左端にはPCIe/インフィニティ・キャッシュのI/Fを集約する必要がある。また上下にHBMのI/Fも設けなければならない。これを満たそうとすると、どうやっても鏡対称となる2種類のダイを作らなければ解決しないことになる。
実際Sapphire Rapidsでも4タイル構成のXCC SKUは鏡対称となる2種類のダイが用意されていることが確認されており、AMDもこれにならったわけだ。
このことはそれほど驚きではないのだが、ここではっきり"Four unique tape-outs:two IODs, one XCD and one CCD"とあるのは驚きだった。上の画像の右上にあたるIODは、Instinct MI300AとInstinct MI300Xで共通になるからだ。要するにIODは、XCDとCCDのどちらも搭載できるように設計されているわけだ。てっきり筆者は、XCD用とCCD用で異なるIODを用意していると考えていたからだ。
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第898回
PC
AI特化とは一線を画すHPCの怪物! 富士通「Monaka」が目指す3D積層と256bit SVE2の真価 -
第897回
PC
NVIDIA独自コア「Olympus」の真価 Vera CPUが見せたIPC全振りの重厚構造とメモリー帯域依存 -
第896回
PC
Arm自社設計「AGI CPU」の全貌、10-wideデコードと2ダイ構成で見せた優等生的な実力 -
第895回
PC
IBM ZがArmを取り込む衝撃! 次世代メインフレーム「z18(仮)」のネイティブDual-ISA戦略の狙い -
第894回
PC
AMD「Ryzen AI Embedded X100」のリアルタイムAI制御が、Jetsonの弱点であるCPU性能を突く -
第893回
PC
インテル製GPU「Crescent Island」の正体、容量480GBメモリーでエージェント型AIとKVキャッシュ問題に挑む -
第892回
PC
Hot Chipsで明かされた「Wildcat Lake」の全貌 Foverosを捨てMCPを選んだインテルの舞台裏 -
第891回
PC
謎多き次世代Xeon「Diamond Rapids」を解剖、3D Meshの進化と新命令セットAPXがもたらす変革 -
第890回
PC
Samsung「SF2P」の全貌! GAA最大の弱点であるPMOS性能低下を克服し、TSMC追撃へ準備万端 -
第889回
PC
なぜ巨大チップは歪んで壊れるのか? SK HynixのHBM4「MR-MUF」とTSMCのCoWoS-Lを襲う熱膨張の罠 -
第888回
PC
NVIDIA Rubin Ultra開発中止の真相! 180層CoWoS-Lの歪曲トラブルと、急造ラックNVL576に透ける苦肉の策 - この連載の一覧へ