Ryzenシリーズの最終回は、3月8日に発表されたNaplesの話をしたい。既報の通り、AMDはNaplesと呼ばれる32コアのサーバー向けCPUの存在を明らかにした。
ちなみに、既報の2枚目のスライドは、Naplesのものではない。これは、かつてOpteronでAMDがサーバー市場に参入した際に、64bit(SledgeHammer)も、Native Multicore(Demmark/Italy/Egypt)も、High Speed Coherent Interconnect(HyperTransport Link)も、メモリーコントローラー統合(SledgeHammer)も、Virtualization(Pacifica:後のAMD-V)も、「全部AMDが先鞭をつけた」ことを紹介しているスライドでしかない。
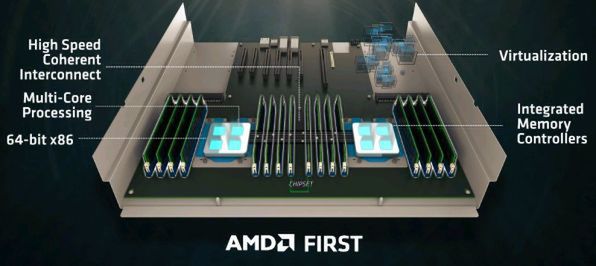
AMDがサーバー市場に参入する発表をした時のスイライド
AMDの次世代サーバーCPU
Naples
それではNaplesとはなにか? というと、1ソケットで32コア/64スレッドのプロセッサーコアと8ch/16枚のDIMM、さらにPCI Expressを合計128レーン利用可能な構成である。ではこれをどう実現しているかを掘り下げてみよう。
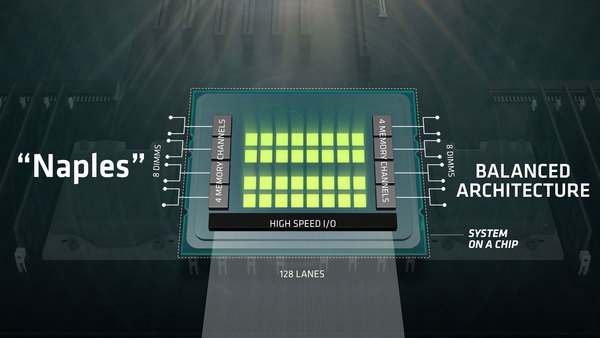
Naplesの概要。あえてPCI Expressではなく“High Speed I/O”と書いてあるあたりがミソ
そもそも現在のRyzen 7のダイはどんな構造かをまずは見直してみたい。下の画像はAMDが公開したダイショットであるが、これを機能ブロック別にしたのがさらにその下の画像である。
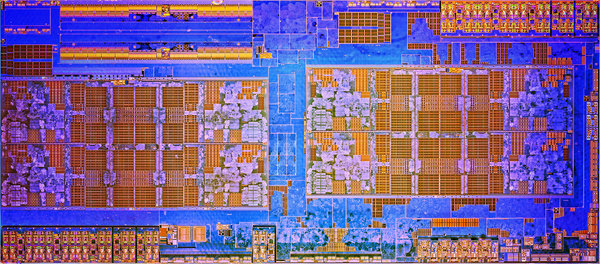
Ryzen 7のダイ。これはAMDがRyzen 7の発表に合わせて公開したもの。すべてのブロックの用途がわかるわけではないが、大まかには見当がつく
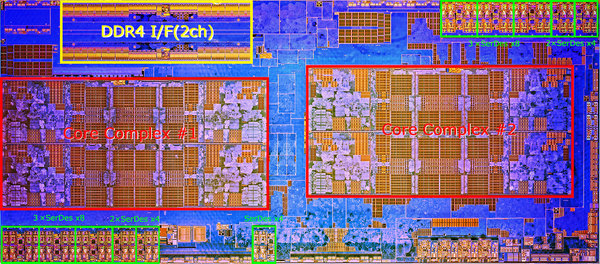
ちなみに下側の中央にある独立したSerDes x4は、おそらく制御用か拡張用と思われる
中央の大きな部分は、4コア+3次キャッシュのコアコンプレックスで、これが2つ存在する。そして左上には、おそらくDDR4のI/Fが2ch分用意されている。
おもしろいのは右上と左下で、これがHigh Speed I/Oのメインとなる部分だが、それぞれ32レーン分搭載されているようだ。ただしSerDesだけでなくコントローラも一緒に入っており、8chのものが3つ、4chのものが2つという構成になっている模様だ。
さて、ここまでAMDはコアコンプレックスの中身やコアの中身については公開してきたが、ダイの内部についてはほとんど紹介してきていない。では実際にどんな感じになっているのか? ということで筆者の想像図が下の画像となる。

筆者が予想するRyzenのダイ構造
実際は周辺回路やAPICなど、まだ欠けている要素はいろいろあるのだが、基本的にはコアコンプレックス2つとメモリーコントローラー、それとPCIe/Infinity Fabric用のSerDes(SERializer/DESerializer:パラレル信号とシリアル信号の双方向変換器)がInfinity Fabricで接続されているという構造になっているのではないかと思われる。
ひょっとするとメモリーコントローラーとコアコンプレックスの間には専用の高速バスが搭載されている可能性があるので、これは黄色の破線で示したが、よほどInfinity Fabricの性能が低いのでない限り、おそらくこの専用バスはなしでいいだろう。
実はこの構造は、K8に非常に良く似ている。K8の世代ではマルチプロセッサーに対応するために、メモリーコントローラーをローカルのCPUコアやキャッシュと切り離して、間をクロスバーでつなぐことで、自身のメモリーアクセスと他のノードからHyperTransport Link経由でやってきたメモリーアクセスを同等に扱える工夫がなされているが、おそらくはRyzenのダイにも同じ工夫があると思われる。
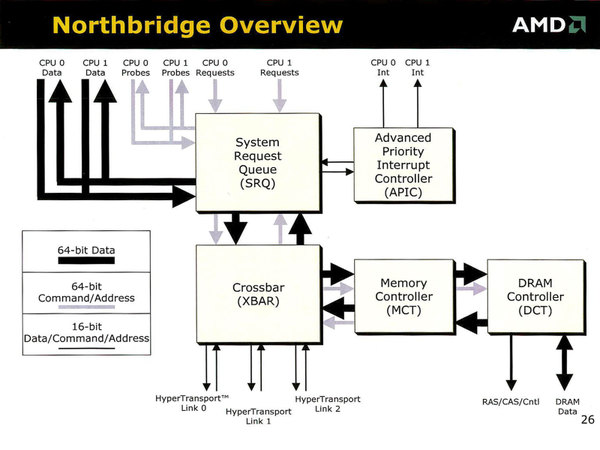
2001年のMicroProcessor Forumで公開されたK8(SledgeHammer)の構造。2つのCPUコアとメモリーコントローラー、APICが全部SRQとクロスバー経由でつながっており、その先がHyperTransport Linkとなっている
前回の記事でScalable Data FabricがHyperTransport Linkに似ているという話があったが、実際Ryzenのダイ内部もInfinity Fabricでコンポーネントが接続されていると考えると、確かに似ているとするのは理解できる。
Ryzen 7やRyzen 5は、2つのコアコンプレックスとメモリーコントローラー、それとSerDes20レーン分(うち16レーンがGPU用、残り4レーンが300シリーズチップセット接続用)が有効にされて提供されている形であろう。
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第894回
PC
AMD「Ryzen AI Embedded X100」のリアルタイムAI制御が、Jetsonの弱点であるCPU性能を突く -
第893回
PC
インテル製GPU「Crescent Island」の正体、容量480GBメモリーでエージェント型AIとKVキャッシュ問題に挑む -
第892回
PC
Hot Chipsで明かされた「Wildcat Lake」の全貌 Foverosを捨てMCPを選んだインテルの舞台裏 -
第891回
PC
謎多き次世代Xeon「Diamond Rapids」を解剖、3D Meshの進化と新命令セットAPXがもたらす変革 -
第890回
PC
Samsung「SF2P」の全貌! GAA最大の弱点であるPMOS性能低下を克服し、TSMC追撃へ準備万端 -
第889回
PC
なぜ巨大チップは歪んで壊れるのか? SK HynixのHBM4「MR-MUF」とTSMCのCoWoS-Lを襲う熱膨張の罠 -
第888回
PC
NVIDIA Rubin Ultra開発中止の真相! 180層CoWoS-Lの歪曲トラブルと、急造ラックNVL576に透ける苦肉の策 -
第887回
PC
AIなしではもはや限界 TSMCが明かすメモリー開発にAIが不可欠となった現実 -
第886回
PC
CFETの足を引っ張るPMOSを救え! imecが提案する新絶縁層と、あえて精度を緩める「Notch Alignment」の妙手 -
第885回
PC
TSMCも次世代「CFET」の全貌を披露! Forksheetスキップの背景と、世界最小6T SRAM実証で見えた2030年への布石 -
第884回
PC
Samsungが次世代CFETの試作に成功! IBMの10万ドル方式に対抗する、量産重視な「一括形成プロセス」のリアリティ - この連載の一覧へ