ロードマップでわかる!当世プロセッサー事情 第897回
NVIDIA独自コア「Olympus」の真価 Vera CPUが見せたIPC全振りの重厚構造とメモリー帯域依存
2026年10月12日 12時00分更新


独自技術「Spatial Multithreading」の狙いと
88コアを敷き詰めたダイ構造
さてOlympusコアの特徴なのが、Spatial Multithreadingである。いわゆるマルチスレッドには実装がいろいろあるが、Hyper-ThreadingやZenコアのSMTなどの場合、基本的には同一プロセス空間の中で複数スレッドを動かして処理するのに効果的になりやすい構成である。
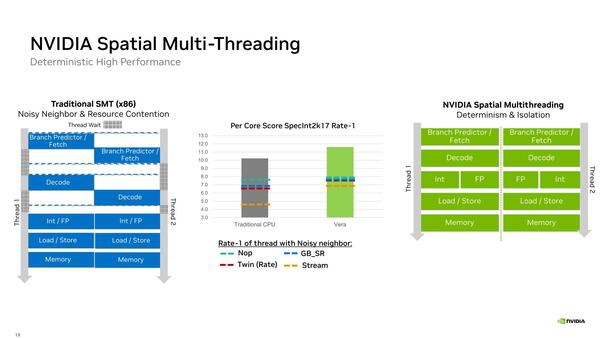
Olympusコアの特徴。Mid coreと言い始めたのは、Front endが分離のIn-Order、Mid coreが混合のIn-Order、Scheduler/Executeが混合のOut-of-Orderということなのかもしれない。それはともかくこの右の図、点線がExec/LoadStore/Memoryまで完全にきていて、これではSMTにする意味がない
Fetchは共通なので、あるスレッドが属するプロセス空間のメモリーから、次のプログラムコードを取り込んでデコードに送ることになる。したがって、同一プロセスに属する2つのスレッドをSMTで動作させると、共通のメモリー空間にアクセスすることになるので効果が出やすい。
一方で異なるプロセスに属するスレッド同士を組み合わせると、両方のプロセスのメモリー空間からプログラムコードを取り込むことになるので効率が悪い。これが上の画像にある左側の説明である。
当たり前の話で、FetchはProcess AとProcess Bの両方のメモリーから同時にFetchを行なったりはしないから、1サイクルごとに異なるメモリー空間からそれぞれ取り込むことになる。これを受けてデコードもサイクルごとにProcess A/Bの命令を解釈するので、言っていることそのものは正しい。
これに対してNVIDIAのSpatial Multithreadingは、Process A用とProcess B用でFetch/Decodeを分離している。これにより、効率的に2つのスレッドを実行できる(上の画像の右側)わけだ。
実際に、従来型のSMTとOlympusのSpatial MultithreadingをSPECint2017 Rateを使って比較した場合、特にStreamなどでは性能が向上しているとされる。理屈はわからなくもないのだが、冷静に考えると話がおかしい。
質疑応答の中でも、Spatial Multithreadingを非対称に分けられる(例えばThread AにDecode×2、Thread BにDecode×8)という話はなかったし、これを実現しようとするとFetchもそれに合わせて帯域を変えないといけないので、現実問題として均等(つまりThread A/BともにFetch/Decodeが5命令/サイクル)になるが、これは単純に性能が落ちるだけの話になる。
あと、Thread A/Bがまったく異なるプロセスの場合には確かに性能が確保できるかもしれないが、逆に同じプロセスに属する2つのスレッドの場合、むしろデメリットになりかねない。同じメモリー空間に対して、Fetchは半分の帯域で2回読み出しをかけることになるからだ。
そもそもSpatial Multithreadingの目的がやや疑問である。というのはx86なら単純にSMTを無効化すればいいだけだからだ。これはOlympusも同じで、単純にMulti-Threadingを辞めればいい。それができないのは、コア数が88個しかないからだろう。
要するにSMTを使って見かけ上のコア数を増やさなければ競争力が確保できず、ところがそれをやると性能が落ちるケースがあるのでSpatial Multithreadingを実装した、という流れに思える。ただこれが帳尻として合っているかは微妙な感じがするのだが、それは後述する。
さて、VeraはこのOlympusコアを88個搭載したCompute Dieと、LPDDR5Xを2ch(256bit)接続できるMemory Controller Die×4、それとPCIe/CXLを搭載したSystem I/O Dieから構成される。
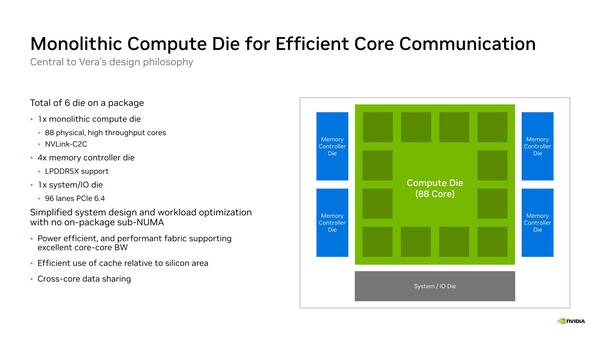
System I/O Dieは6×PCIe 6.4 x16のみを搭載。NVLink C2CはCompute Dieの方に実装される。システム簡単化のためにNUMAの分割サポートはなし。ダイ内で1つのNUMAエリアを構成する
このダイ部分をアップにしたのが下の画像だ。
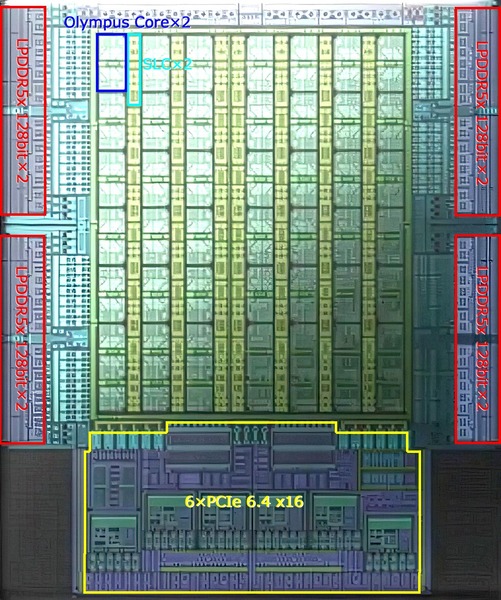
これはNVIDIAのTech Blogにあったスライドからダイ部分を切り出し、輝度を上げたもの。縦横比は一致していると思うが、元がCGなのでどこまで正確かはわからない
Memory Controller DieとSystem I/O Dieはほぼもう見ての通りで違和感はないが、問題はCompute Dieの方。左上にCore×2とSLC×2と思われる場所を示したが、コアの方は13×7=91個のブロックから構成される。この91個のブロックは、NVIDIA独自のネットワークで相互接続される構造だ。
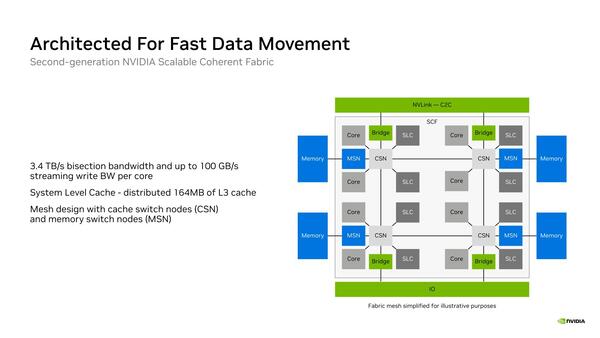
この図ではCSNが2×2の4個で表現されているが、これはあくまでも簡略化した図で、実際には7×7の49個のCSNがあり、そこにOlympus Core×2とSLC×2、それとMemory/IO向けのブリッジが必要に応じてぶら下がる構造になる
CPUコアについては3個を冗長コア扱いにして88コア構成になる。
一方SLCの方だが、実は微妙に縦の高さがコアと一致していないのは2つ上の画像でも示した通り。したがって、縦方向が12個だとすると12×7=84で、うち2つを冗長ブロックとして2MB×82個=164MB、というあたりが正確なところな気もする。
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第896回
PC
Arm自社設計「AGI CPU」の全貌、10-wideデコードと2ダイ構成で見せた優等生的な実力 -
第895回
PC
IBM ZがArmを取り込む衝撃! 次世代メインフレーム「z18(仮)」のネイティブDual-ISA戦略の狙い -
第894回
PC
AMD「Ryzen AI Embedded X100」のリアルタイムAI制御が、Jetsonの弱点であるCPU性能を突く -
第893回
PC
インテル製GPU「Crescent Island」の正体、容量480GBメモリーでエージェント型AIとKVキャッシュ問題に挑む -
第892回
PC
Hot Chipsで明かされた「Wildcat Lake」の全貌 Foverosを捨てMCPを選んだインテルの舞台裏 -
第891回
PC
謎多き次世代Xeon「Diamond Rapids」を解剖、3D Meshの進化と新命令セットAPXがもたらす変革 -
第890回
PC
Samsung「SF2P」の全貌! GAA最大の弱点であるPMOS性能低下を克服し、TSMC追撃へ準備万端 -
第889回
PC
なぜ巨大チップは歪んで壊れるのか? SK HynixのHBM4「MR-MUF」とTSMCのCoWoS-Lを襲う熱膨張の罠 -
第888回
PC
NVIDIA Rubin Ultra開発中止の真相! 180層CoWoS-Lの歪曲トラブルと、急造ラックNVL576に透ける苦肉の策 -
第887回
PC
AIなしではもはや限界 TSMCが明かすメモリー開発にAIが不可欠となった現実 - この連載の一覧へ