

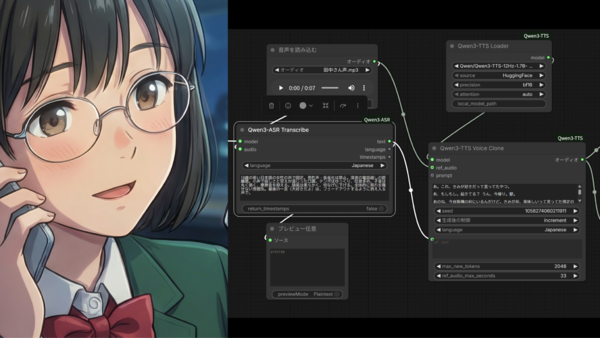
Qwen3-TTSで音声を生成しているComfyUIの画面と、ゲストキャラクターの田中さん(筆者作成)
高性能化する音声系のオープンモデルが話題になっています。1月22日に、アリババが「Qwen3-TTS Family」をオープンモデルとして公開しました。TTSは「Text-to-Speech」の略で、テキストを音声に変換するためのモデルです。わずか4秒ほどの音声ファイルを参考音声として読み込めば、かなりの精度で音声を再現できるという恐ろしく高性能なものです。筆者の声、動画AIから抽出した声などを使って、再現精度を検証しました。
Qwen3-TTSの強力さをわかりやすく理解できる例として、まず、筆者の音声で作例を作ってみました。2022年、YouTube Liveでの筆者の講演から、7秒分の音声を抽出しました。オンラインであることもあって若干音がこもっていますがよしとします。音声をQwen3-TTSに読み込ませ、過去の連載の冒頭を読み上げさせました。生成された音声は25秒となりました。たった7秒の声から生み出したにも関わらず、筆者の声真似を見事に実現しています。
▲筆者の声を使った作例。動画冒頭の7秒は筆者の元々の講演時の声、後半25秒がAI生成の声。
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第179回
AI
無料の画像生成AI「Moss-Image」がすごい 日本語も漫画も生成、商用利用OKの実力を試した -
第178回
AI
GPT-4o級モデルが自宅のPCで動いた! ローカルAIの常識を変える「Strata」 -
第177回
AI
AIに「法隆寺の五重塔」を作らせてみた 修正を重ねてたどり着いた驚きの完成度 -
第176回
AI
無料ツールとAIでMV制作が激変 After Effectsまで自動操作できた -
第175回
AI
AIが人間のようにゲームをプレイ 話題の「Jev」を試してわかったこと -
第174回
AI
AIでMVを作るのは想像以上に大変だった 制作34時間、繰り返した“ダメ出し”でわかったこと -
第173回
AI
OpenAI「Astra」は何でもできる、だからこそ“プロの指示”が必要になる -
第172回
AI
ついにAIキャラクターと“ビデオチャット”へ 「MiniMax H3」がリアルタイム生成に接近 -
第171回
AI
5秒の動画を3秒で出せる 動画生成AI「MiniMax H3」が爆速に進化 -
第170回
AI
「うわ、すげえ!」Unreal EngineをCodexに操作させたら制作の常識が変わった -
第169回
AI
もはやローカル動画生成AIの枠におさまらない。MiniMax H3の奥が深すぎる - この連載の一覧へ