SambaNovaは連載510回で説明したあと、連載792回でHotChips 24での説明を元にSN40Lを紹介したが、この時にはいろいろ謎が残った。なのだが、ISSCCのInvited Industryセッション(Session 16)で同社が"SambaNova SN40L: A 5nm 2.5D Dataflow Accelerator With Three Memory Tiers for Trillion Parameter AI"(Session 16.4)として不明な点を明らかにしてくれたので、連載792回で間違っていた部分の訂正もかねて解説したい。
SN40Lの脇に12本づつのRDIMMスロットを用意して
メモリーの実装を実現
まず不明点というか間違っていた点の訂正から。EETimesの2022年9月28日の記事の最後の写真には"SambaNova unveiled its SN30 RDUーwith two compute chiplets and 1 TB of direct-access DDR in this package."というキャプションが付いており、「どうやったらこのパッケージにDDRメモリーを全部収められるんだ?」と相当頭をひねった結果が下の画像だったわけだが、案の定こんなことはなかった。
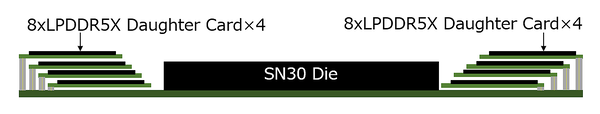
連載792回で筆者が想定したSambaNova SN30の構造
下の画像はSN40Lを2つ搭載したXRDLU基板の写真だが、SN40Lの脇に12本づつのRDIMMスロットが用意されている。常識的な実装で一安心である。
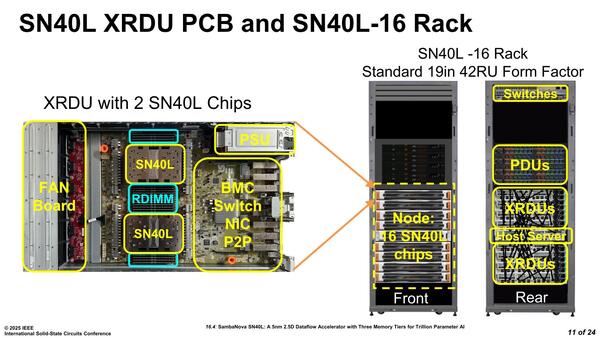
SN40Lを2つ搭載したXRDLU基板。最初からこの写真を出していてくれれば、パッケージ内にDIMMを突っ込むなんていうアイディアをひねりだす必要はなかった
ということでここからはISSCCでの発表を。下の画像はHotChipsのものと同じであるが、それぞれのSN40Lには12本のRDIMMスロットが接続される。ということでスロットあたり128MB、12スロットで1.5TBという計算かと思われる。
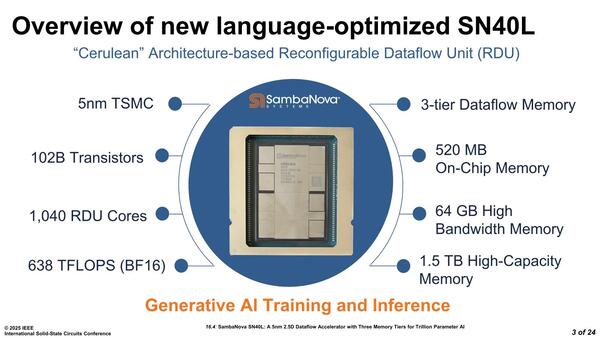
右上および左下のHBMのようなものはダミーであり、実際には1つのチップに2つのHBMが接続される構造。「だったら片側に寄せればパッケージが小型化できるのに」と思うが、おそらくチップを180度回転させて接続している関係で、こういう構造にせざるを得なかったのだろう
それはいいのだが、これが12ch(つまりチップあたり6ch)なのか、6ch(チップあたり3ch)なのか、というのが次の疑問である。メモリー階層図(下図)を見ると、HBMは1.6TB/秒、RDIMMは100GB/秒となっている。
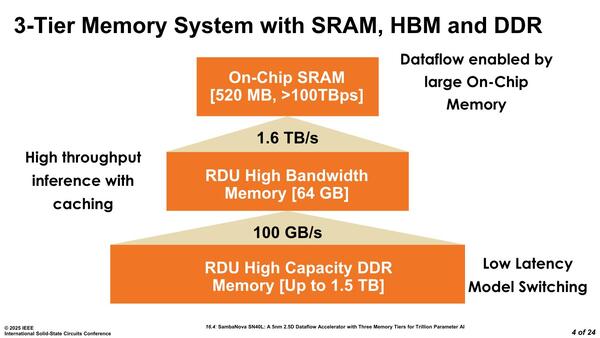
HBMはチップあたりHBMが2スタックで1.6TB/秒、容量64GBとなっており、つまり1スタックで800GB/秒、32GBという計算になるので、おそらくHBM3eをベースにしているものと思われる
前提として、DDR5の場合2 DIMM/chで安定して動作するのはDDR5-4400までとされており、実際これを超えるとまともに動かないケースがほとんどである。仮にDDR5-4400とすると1chあたり35.2GB/秒、これを3chにすると105.6GB/秒になって、ちょうど100GB/秒という計算になる(あるいは安定性を重視してDDR5-4200とかDDR5-400駆動の可能性もある。これでも四捨五入すればだいたい100GB/秒である)。
一方1 DIMM/chであればそれこそDDR5-6400まで可能なのだが、一応DDR5-4800の場合を考えると1chあたり38.4GB/秒で、これが6chだと230.4GB/秒になって数字が合わない。つまり最初から1chあたり2DIMM構成であることを前提にチップあたり3ch/6 DIMM、SN40L全体で6ch/12 DIMM構成を取ることにしたものと思われる。
ここでなぜ12ch構成にしなかったか? であるが、おそらくパッケージの限界(DDR5は1chあたり288ピンの信号線を必要とする。もちろん電源やGNDのように共通化できるものもあるが、それでも1ch増やすと100本以上は平気で増えるので、6chと12chでは1000本近くピン数が変わってくる)ことと、そもそも高速なメモリーという意味ではHBMがあり、ここで無理して12ch構成にして帯域を上げてもそれほど大きな性能向上にはつながらない(仮にDDR5-6000だとしても288GB/秒程度にしかならず、1.6TB/秒のHBMとのギャップは大きい)し、むしろ消費電力が増えるだけという判断があったのだと思われる。
実際のところDDR5-6000×12chとDDR5-4400×6ch×2 DIMMでは、DIMM全体の消費電力は倍近く変わる。性能面での寄与がそれほどないわりに消費電力が増える、というあたりも嫌われたのだろう。
それでも、最大で1.5TBもあればかなり大規模なLLMであってもすべてをオンメモリーで処理できることになる。これがCelebrasならSwarmX経由でMemory Xからパラメーターをロードする必要があるし、NVIDIAのGPUを含むその他のAIアクセラレーターだったらホスト(NVIDIAならGrace CPU、その他ならXeonなりEPYCなり)からPCIe(かNVLink)経由などでパラメーターを転送するしかない。
"Low Latency Model Switching"というのは、こうしたホスト経由での転送よりはるかに迅速にパラメーターの入れ替えやロードが可能になる、という意味である。
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第898回
PC
AI特化とは一線を画すHPCの怪物! 富士通「Monaka」が目指す3D積層と256bit SVE2の真価 -
第897回
PC
NVIDIA独自コア「Olympus」の真価 Vera CPUが見せたIPC全振りの重厚構造とメモリー帯域依存 -
第896回
PC
Arm自社設計「AGI CPU」の全貌、10-wideデコードと2ダイ構成で見せた優等生的な実力 -
第895回
PC
IBM ZがArmを取り込む衝撃! 次世代メインフレーム「z18(仮)」のネイティブDual-ISA戦略の狙い -
第894回
PC
AMD「Ryzen AI Embedded X100」のリアルタイムAI制御が、Jetsonの弱点であるCPU性能を突く -
第893回
PC
インテル製GPU「Crescent Island」の正体、容量480GBメモリーでエージェント型AIとKVキャッシュ問題に挑む -
第892回
PC
Hot Chipsで明かされた「Wildcat Lake」の全貌 Foverosを捨てMCPを選んだインテルの舞台裏 -
第891回
PC
謎多き次世代Xeon「Diamond Rapids」を解剖、3D Meshの進化と新命令セットAPXがもたらす変革 -
第890回
PC
Samsung「SF2P」の全貌! GAA最大の弱点であるPMOS性能低下を克服し、TSMC追撃へ準備万端 -
第889回
PC
なぜ巨大チップは歪んで壊れるのか? SK HynixのHBM4「MR-MUF」とTSMCのCoWoS-Lを襲う熱膨張の罠 -
第888回
PC
NVIDIA Rubin Ultra開発中止の真相! 180層CoWoS-Lの歪曲トラブルと、急造ラックNVL576に透ける苦肉の策 - この連載の一覧へ