

ロードマップでわかる!当世プロセッサー事情 第816回
シリコンインターポーザーを使わない限界の信号速度にチャレンジしたIBMのTelum II ISSCC 2025詳報
2025年03月24日 12時00分更新


性能はTelum比で1.3倍
AIアクセラレーターに関してはあまり新情報はないのだが、「自分のチップ内のAIアクセラレーターがBusyで、同じDrawer内の別のチップのAIアクセラレーターが空いている場合、そのAIアクセラレーターを利用できるので、最大192TOPSの性能」というのは、Virtual L4と同じような発想である。
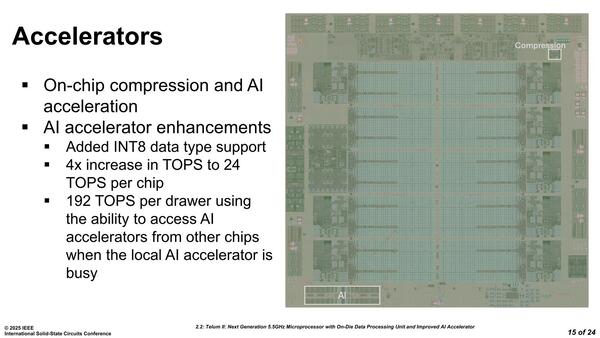
連載790回の画像とあまり差がない。ただチップ右上にCompression Moduleがあることが今回明らかにされた
A-Bus経由で別のDrawerのAIアクセラレーターまで駆動できるかどうかは定かではないが、この書き方からするとVirtual L4に同一Drawer内に限られるようだ。これで足りなければ連載790回で書いたようにSpyreアクセラレーターを使うという形になる。
Telum IIにある個々のコアが下の画像で、パフォーマンス改善に関してはレジスター数の増加、ストアーバッファのライトバック機能の搭載、それと分岐予測の改善が挙げられている。逆に言えばこれと動作周波数向上が主な性能完全の要因とみられ、パイプラインの大幅変更などは特にされていないようだ。
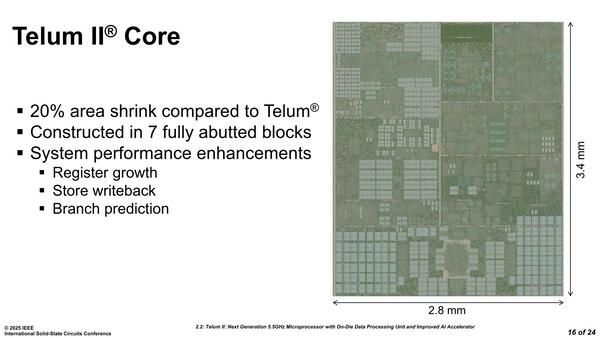
Telum IIにある個々のコア。Area shrinkは主にプロセス微細化によるものと思われる
連載790回でDPUのブロック構造を紹介したが、実際の実装が下の画像だ。個々のクラスターには8つのMCUが配されるという説明があったが、スライドを見ていると最上段に4つ、左右に2つづつ配されているようだ。その真ん中になにが入っているのかは不明だが。
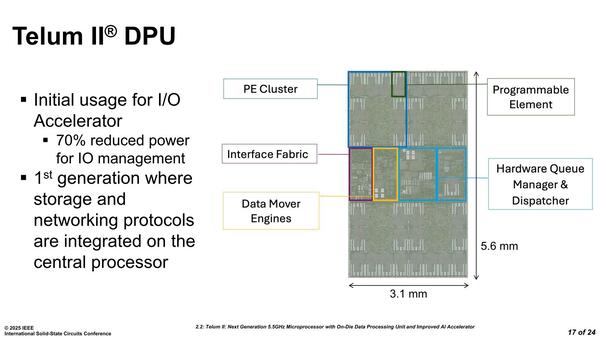
ブロック図でCluster A~Dに当たるのが上下に2つづつ配されたPE Clusterというブロックで、その間にCoherent FabricやHardware Queue Manager&Dispatcher、Data Mover Engineが配される
最後に性能について。下の画像は絶対性能ではなく、同一消費電力当たりのIPCを比較したものであるが、順調に性能を伸ばしているとする。ほぼどの処理でもTelum比で1.3倍ということになっており、世代ごとの性能比としては妥当なところと思われる。
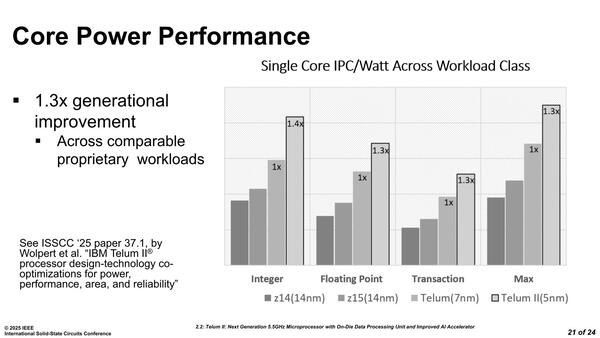
縦軸の単位が不明だが、Telumを1.0とした時には全項目でTelum IIは1.3~1.4倍の性能とされる。ところでMaxは何のテストなのだろう?
問題があるとすればチップあたりのコアの数が10→8に減っていることで、これはDPUを搭載したのが主な要因と思われる。記事冒頭の画像を見返すと、例えばDPUを2つに分割して"Package/Drawer interface"ブロックの両脇に配するなどの方法もありそうに思えるのだが、そうしなかったのはなにか理由があるのだろう。そのあたりの事情を知りたいものである。
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第896回
PC
Arm自社設計「AGI CPU」の全貌、10-wideデコードと2ダイ構成で見せた優等生的な実力 -
第895回
PC
IBM ZがArmを取り込む衝撃! 次世代メインフレーム「z18(仮)」のネイティブDual-ISA戦略の狙い -
第894回
PC
AMD「Ryzen AI Embedded X100」のリアルタイムAI制御が、Jetsonの弱点であるCPU性能を突く -
第893回
PC
インテル製GPU「Crescent Island」の正体、容量480GBメモリーでエージェント型AIとKVキャッシュ問題に挑む -
第892回
PC
Hot Chipsで明かされた「Wildcat Lake」の全貌 Foverosを捨てMCPを選んだインテルの舞台裏 -
第891回
PC
謎多き次世代Xeon「Diamond Rapids」を解剖、3D Meshの進化と新命令セットAPXがもたらす変革 -
第890回
PC
Samsung「SF2P」の全貌! GAA最大の弱点であるPMOS性能低下を克服し、TSMC追撃へ準備万端 -
第889回
PC
なぜ巨大チップは歪んで壊れるのか? SK HynixのHBM4「MR-MUF」とTSMCのCoWoS-Lを襲う熱膨張の罠 -
第888回
PC
NVIDIA Rubin Ultra開発中止の真相! 180層CoWoS-Lの歪曲トラブルと、急造ラックNVL576に透ける苦肉の策 -
第887回
PC
AIなしではもはや限界 TSMCが明かすメモリー開発にAIが不可欠となった現実 -
第886回
PC
CFETの足を引っ張るPMOSを救え! imecが提案する新絶縁層と、あえて精度を緩める「Notch Alignment」の妙手 - この連載の一覧へ