ロードマップでわかる!当世プロセッサー事情 第902回
なぜGPUとTPUを混載するのか? あえてCPUを外しFP8も捨てたWaymo独自プロセッサーの徹底した割り切り
2026年11月16日 12時00分更新


レイテンシー13倍改善を実現したcarTPUの分割動作と同期メカニズム
SFPの胆はcarTPUになるわけだが、そのcarTPUはWaymoのAIモデルに最適化する形で構築された。
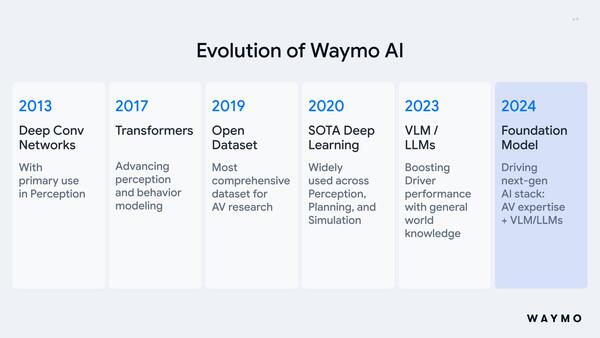
WaymoのAIの変遷。最初から完璧なモデルが構築できるわけもないわけで、2013年からスタートして13年ほどさまざまなモデルを構築し、それを改善してきた。2024年のFoundation Modelはもう全部入りという感じになっている
スペックを並べたのが下の画像である。FP8やFP4のサポートはなく、むしろINT16やFP32のサポートが残っているあたりは、おそらく同社の自動運転のアルゴリズムではまだFP4/FP8のような、精度の低い数値型を使っての動作が想定されていないのだろう(あるいは、そもそも精度が足りなくて十分な能力が発揮できないのか。そのあたりは明かされなかった)。
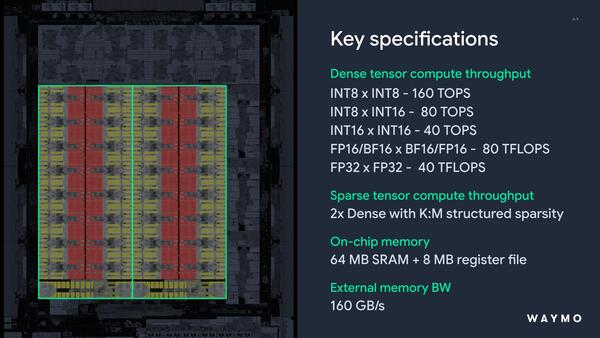
SFPのスペック。そしてこの写真の最下段は、64MBとは別に2MBの制御用SRAMと、あとはRISC-Vコアが配されている
レイアウトを見ると2つ並んだ塊の中央の赤い部分が合計64MBのSRAMに見える。興味深いのは、このcarTPUの外部メモリーへの帯域は160GB/秒ということで、LPDDR5xの帯域をフルに使い切っているわけではないことだ。おそらく帯域の残りはGPUやISPに分配されるのだろう。
TPUの内部構造が下の画像だ。大きく2ブロック(Waymoはこれをコアと称している)に分かれるが、おのおのは16個のPEから構成され、全体はリングバス構成となっている。それぞれのPEにローカルで2MBのSRAMが割り当てられ、それがリングバスで共有されるという、ちょうどインテルのPコアとLLCのような構造になっている。
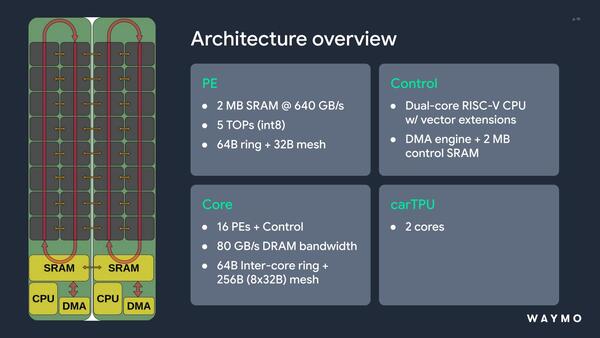
リングバスは64Bytes幅だが、横方向の接続(Mesh)は32Byte幅と半減しているのが興味深い。PE1個あたりで5 TOPSというのは結構な性能ではある
一番下にRegister FileとDMA Engine、およびこれを制御するためのRISC-V CPUが搭載されている。ただこのCPU、Vector Extension付きとは言え、積極的に演算に使うというよりは、TPUのPEで処理できないような例外的な処理を行なう以外はDMAの制御など向けという感じで、全体のオーケストレーションの処理というよりは、その処理の下請け業務向けである。おそらくオーケストレーション用のCPUは、SFPの外にあるものと思われる。
このcarTPUだが、2つに分割して独立動作することも、まとめて動作することも可能となっている。性能が必要な場面ではまとめて1つ、同時に複数処理をさせたいケースでは2つに分割して独立に動かすという仕組みだ。
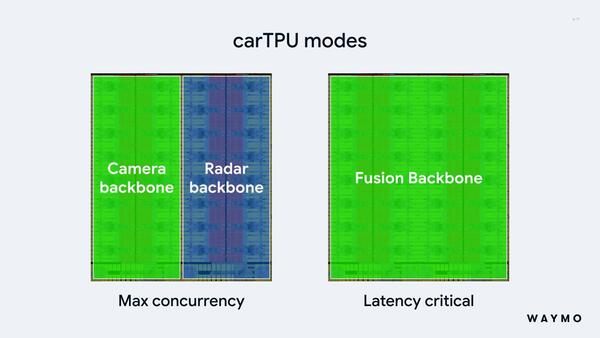
2つに分けたのはLockstep動作ではなさそう。システム構成を見るとcarTPU単体でASIL-Dを実現するのは放棄して、必要ならSFPを2つ並べてLockstep的な動作をさせるつもりかもしれない
さて先程も少し出てきたが、そのcarTPUの設計の基となる、Waymoが想定するデータフローをまとめたのが下の画像である。carTPUはSensor Fusion、つまり複数のセンサーデータを基にWorld Decoderへの入力値を生成するのが目的となる。
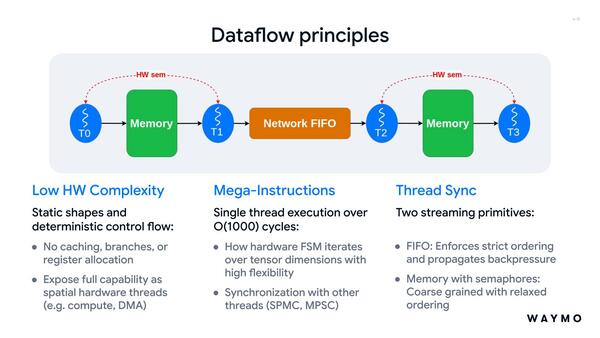
個々のスレッド動作は「有限状態機械」と呼ばれるモデルに従うが、同期はSPMC(Single-Producer Multi-Consumer 1:Nの同期)や逆にMPSC(Multi-Producer Single-Consumer N:1の同期)などが入り乱れたものになりがちとなる
第一段階はセンサーからのデータをメモリーに格納する処理で、これはcarTPUの処理外というか、DMAエンジンとCPUの仕事である。もちろん点群データの場合は、それを意味ある形にするためにGPUがフルに稼働することになるのだろうが。
その結果は一旦メモリーに入り、そこからcarTPUが稼働してそのデータを基にWorld Decoder向けのデータを生成していくわけだが、この処理は猛烈に並列度が高いもの(O(1000)とあるので、数千スレッドが動作すると思われる)であり、しかもおのおのの処理のスレッド同士での同期が必要になることもある。
この結果は再びメモリーに戻され、最終的にWorld Decoderに送り出されるわけだが、おそらくは同じタイミングで取得したデータをそろえて送りだすような格好になるだろう。というのはWorld Decoderの側も、例えばカメラは0.1秒前のデータ、LiDARは0.2秒前のデータ、Radarは0.3秒前のデータを送り付けられたとしても、それを活用するのは難しいからだ。0.1秒前なら0.1秒前でそろっていないといけない。最後のSemaphoreはこの同期をとるために必要となる。
こうしたデータフローを処理するために、PEの内部は4つのスライスに分割され、それぞれが独立してGEMV(General Matrix-Vector Multiplication:一般行列ベクトル積)を実行できる構成になっている。
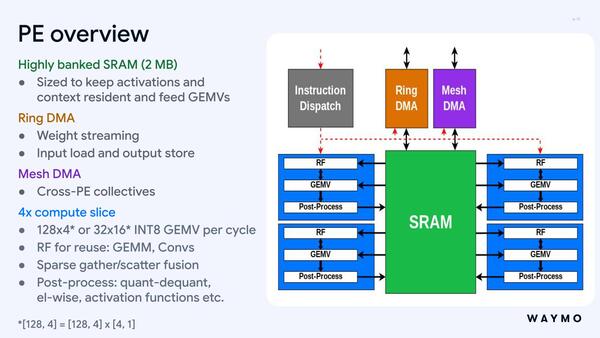
PEの概要。ついでにこのスライドでリングとメッシュの使い分けも明確にされた。リングはいわばWeightのブロードキャスト用と、演算開始前/終了後の入力データや出力の移動用(この場合のあて先はコントロール部のDMAエンジンとなるのだろう)で、メッシュはPE同士の連携用である
SIMDというよりもMatrixエンジンが4組入っている、という構造に見える。ただ一般的なMatrixエンジンと違って次数が低い(M=1)から、それほど大規模な構成にはならないだろう。実際にこのMatrixエンジンの動き方をまとめたのが下の画像だ。
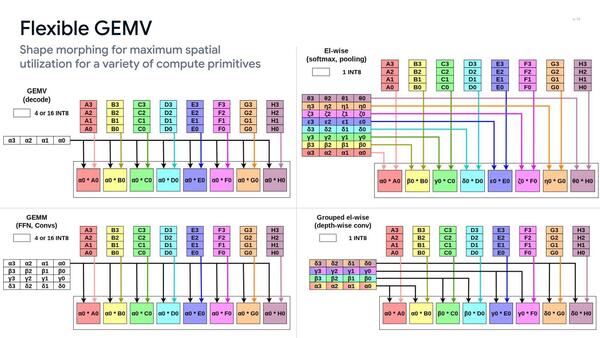
Matrixエンジンの動き方。この図の例で言えば、すべての計算を行なうのにEl-wiseは8サイクル、それ以外は4サイクル必要である。仮に1サイクルで計算を終わらせたとしても、その結果を書き出す帯域が足りないし、そもそもこのMatrixエンジンが多数あるからトータルのスループットは十分あるので、別に1サイクルで丸ごと計算を終える必要はない
いわゆるGEMV(これはLLMのデコードで多用される)以外にGEMM(General Matrix Multiply:一般行列乗算、いろいろな行列演算で多用される)、EL-Wise(Element-Wise:要素別の処理。ここではSoftmax関数やPoolingなど)などを実行できるとしている。
実際にこのcarTPUの性能がどの程度かを評価したのが下の画像である。Baselineというのは外部のアクセラレーターを利用したもので、おそらくこれはソフトウェア開発用にSFPが完成前から利用していたAIプロセッサーと思われるが、これと比較して性能で最大2.8倍、レイテンシーで13倍以上を実現できたとしている。
もちろんアプリケーションによって向上率はだいぶ違っており、映像処理(Vision ConvNet)やセンサー情報の統合(Sensor Backbone)、ThinkFast VLMでは性能改善が著しい一方で、必ずしも性能がBaselineからそれほど上がらないものもある。
ちなみに質疑応答では、「ミリ秒オーダーのレイテンシーを強調していたが、VLMモデルの場合にWaymoが求めるTTFT(Time To First Token)とTPOT(Time Per Output Token)の目標値は?」という質問に対し、「ミリ秒オーダーのレイテンシーはThinking Fast Pathに属する。VLMモデルはThinking Slowエンコーダーに属しており、処理にもっと時間が掛かる」という返答だった。SFPはあくまでもセンサー情報およびThinkFast VLMの処理に特化している、と考えるのが正しいのだろう。
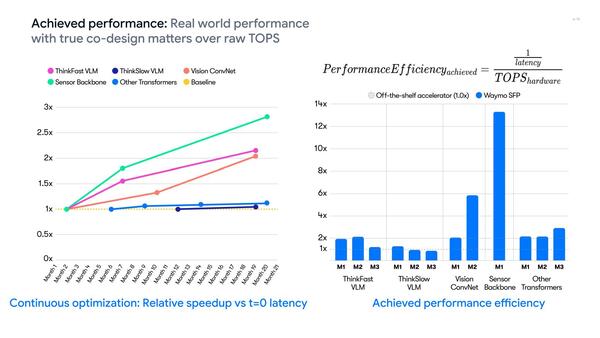
ThinkSlow VLMなどはSFPの外部で処理されると思われる。あくまでも「仮にcarTPUを使ったらどうなるか」を検証しただけであって、この結果であれば外部のアクセラレーターを使っても性能が下がらないからだ
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第901回
PC
Teslaの「カメラ単体」を否定する理由 Waymoが明かした自動運転の壁と自社製プロセッサー -
第900回
PC
元Samsung副社長が率いるBOSの勝算 Tenstorrent製NPUとオープン規格で挑む車載AI「Eagle-N」 -
第899回
PC
NVLink追撃の現実解「UALoE」 AMD Instinct MI400が挑む次世代ラック実装とBlackwell対抗 -
第898回
PC
AI特化とは一線を画すHPCの怪物! 富士通「Monaka」が目指す3D積層と256bit SVE2の真価 -
第897回
PC
NVIDIA独自コア「Olympus」の真価 Vera CPUが見せたIPC全振りの重厚構造とメモリー帯域依存 -
第896回
PC
Arm自社設計「AGI CPU」の全貌、10-wideデコードと2ダイ構成で見せた優等生的な実力 -
第895回
PC
IBM ZがArmを取り込む衝撃! 次世代メインフレーム「z18(仮)」のネイティブDual-ISA戦略の狙い -
第894回
PC
AMD「Ryzen AI Embedded X100」のリアルタイムAI制御が、Jetsonの弱点であるCPU性能を突く -
第893回
PC
インテル製GPU「Crescent Island」の正体、容量480GBメモリーでエージェント型AIとKVキャッシュ問題に挑む -
第892回
PC
Hot Chipsで明かされた「Wildcat Lake」の全貌 Foverosを捨てMCPを選んだインテルの舞台裏 - この連載の一覧へ