ロードマップでわかる!当世プロセッサー事情 第838回
驚異のスループット! NVLink Fusionで最大900GB/秒を超えるデータ転送速度を実現する新世代AIインフラ
2025年08月25日 12時00分更新


COMPUTEX TAIPEI 2025でNVLink Fusionを発表
従来のPCIeを大幅に上回る帯域幅と低遅延を実現
NVLinkやNVSwitchは(AMDのInfinity Fabric同様に)NVIDIA独自のものであり仕様などは一切公開されていないのだが、今年のCOMPUTEXにおいてNVIDIAはNVLink Fusionを発表した。
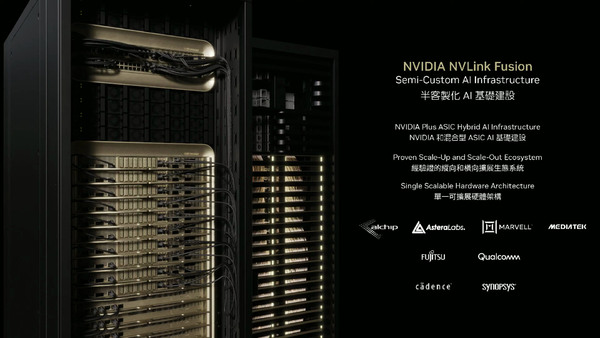
NVLink Fusionでは、顧客のカスタムASICの隣にNVLinkチップレットを配置し、NVIDIAのコンピュートボードやAIスーパーコンピューターのエコシステムに統合する
もっとも、発表時の説明を読んでも今ひとつ内容がわかりにくい。端的に言えば、CPUベンダーあるいは独自のASICを製造しているベンダーが、自社の製品にNVIDIAのGPUを組み合わせるにあたって、PCIeではなくNVLinkを利用できるようにする、というものだ。
PCIe経由での接続であれば今すぐにも可能なのだが、これはGPU同士の通信には遅くなりすぎる。そこでNVIDIAからNVLinkの利用権をライセンスする形を取って、自社のCPUやASICとNVIDIAのGPUをNVLinkで利用できるようにする、というのがNVLink Fusionになる。
もともとNVIDIAはGrace Hopperの世代にNVLink C2C(Core to Core)というCPUとGPUを接続するためにNVLinkの拡張をしている。これを一歩進めたのがNVLink Fusionという言い方もできるかもしれない。
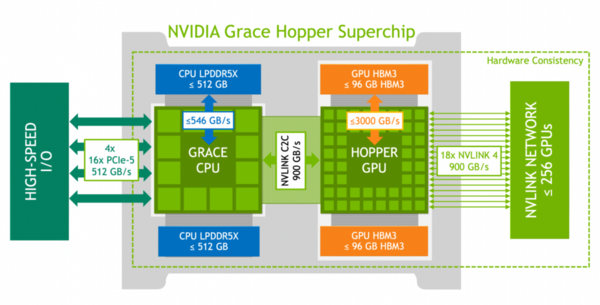
Grace CPUとHopper CPUの間がNVLinkで接続されている
さてそのNVLink Fusionだが、下の画像を見ると、上で書いた「自社CPUにNVIDIAのGPU」だけでなく、「自社GPU/アクセラレーターにNVIDIAのCPU」という組み合わせもNVLink Fusionでサポートされるようだ。
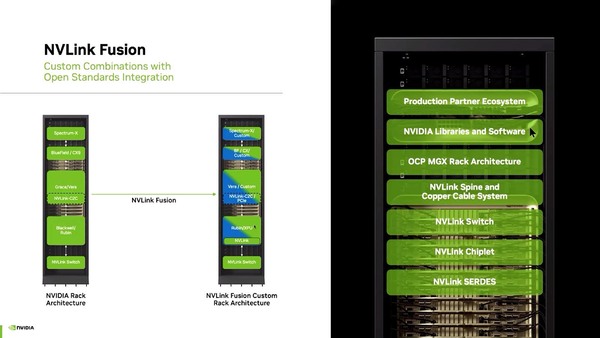
外部ネットワークであるSpectrum-X/BlueFieldが他のソリューション(青色)で代替されるのはともかく、CPUであるVeraとGPUであるRubinのどちらも他のソリューション(青色)で代替可能というのは興味深い
実際NVLink Fusionでサポートされる最初の世代は次のVera/Rubinの組み合わせになるが、現在のNVL72の構成のまま、カスタムチップで混在可能と説明されている。
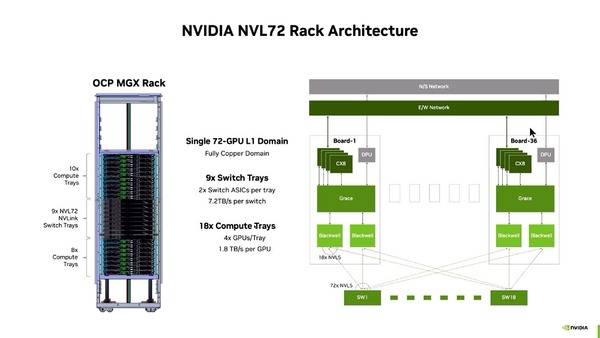
こちらは現在のNVL72の構成。2つのBlackwellと1つのGraceを載せたボード36枚が、18本のCompute Trayに収まる格好だ
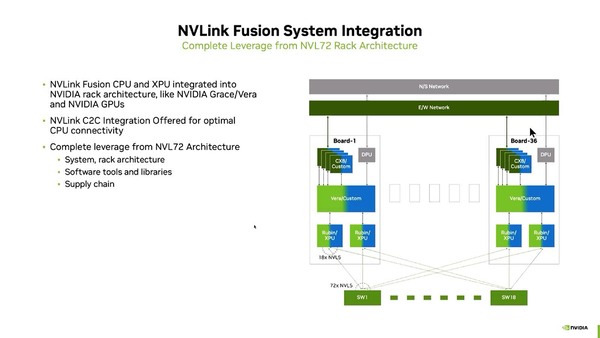
カスタムチップで混在可能。GraceがVeraないしカスタムCPUに、BlackwellがRubinないしXPUに変更される格好だ
もっともこれは概念図かと思われる。少なくともNVLink Fusionを使う場合にはNVL72のラックをそのまま流用しなければいけないという縛りはなく、ただ構成を説明するのにNVL72と同じような構成が利用できるというだけかと思われる。
なにげにサラッと描かれているが、GPU/XPU同士の接続には引き続きNVLink Switchが必要になっており、ここはNVIDIAとしては外部にライセンスするつもりはないようだ。このページの最初の画像でパートナーの中にMarvellが入ってはいるが、これはNVLink Switchのライセンスを提供しているわけではなく、おそらくはチップレット接続部分の実装に向けたものと思われる。
Marvellはネットワーク関連製品の製造以外に、自社以外のASICの物理実装の設計と製造の受託というビジネスをしている。Broadcomも同じくこうしたビジネスをしており、富士通のMonakaは過去の経緯を考えるとBroadcomにMonakaの物理実装を依頼しているのではないかと筆者は考えていたのだが、今回パートナー企業にBroadcomではなくMarvellの名前があるあたり、ひょっとすると物理実装のパートナーがMarvellに変わった可能性もありそうだ。
本記事はアフィリエイトプログラムによる収益を得ている場合があります

この連載の記事
-
第894回
PC
AMD「Ryzen AI Embedded X100」のリアルタイムAI制御が、Jetsonの弱点であるCPU性能を突く -
第893回
PC
インテル製GPU「Crescent Island」の正体、容量480GBメモリーでエージェント型AIとKVキャッシュ問題に挑む -
第892回
PC
Hot Chipsで明かされた「Wildcat Lake」の全貌 Foverosを捨てMCPを選んだインテルの舞台裏 -
第891回
PC
謎多き次世代Xeon「Diamond Rapids」を解剖、3D Meshの進化と新命令セットAPXがもたらす変革 -
第890回
PC
Samsung「SF2P」の全貌! GAA最大の弱点であるPMOS性能低下を克服し、TSMC追撃へ準備万端 -
第889回
PC
なぜ巨大チップは歪んで壊れるのか? SK HynixのHBM4「MR-MUF」とTSMCのCoWoS-Lを襲う熱膨張の罠 -
第888回
PC
NVIDIA Rubin Ultra開発中止の真相! 180層CoWoS-Lの歪曲トラブルと、急造ラックNVL576に透ける苦肉の策 -
第887回
PC
AIなしではもはや限界 TSMCが明かすメモリー開発にAIが不可欠となった現実 -
第886回
PC
CFETの足を引っ張るPMOSを救え! imecが提案する新絶縁層と、あえて精度を緩める「Notch Alignment」の妙手 -
第885回
PC
TSMCも次世代「CFET」の全貌を披露! Forksheetスキップの背景と、世界最小6T SRAM実証で見えた2030年への布石 -
第884回
PC
Samsungが次世代CFETの試作に成功! IBMの10万ドル方式に対抗する、量産重視な「一括形成プロセス」のリアリティ - この連載の一覧へ