

AIエージェントが人間に代わって業務を実行する時代、企業が持つデータをどのように管理し、活用していくべきなのか。CEATEC 2026では、AI・データ基盤を提供する企業と、データ戦略を推進する企業の双方が登壇し、「Agentic AIとデータ基盤の未来-Open Data Spacesが拓く、AIネイティブ経営のための技術戦略」と題したセッションが開催された。
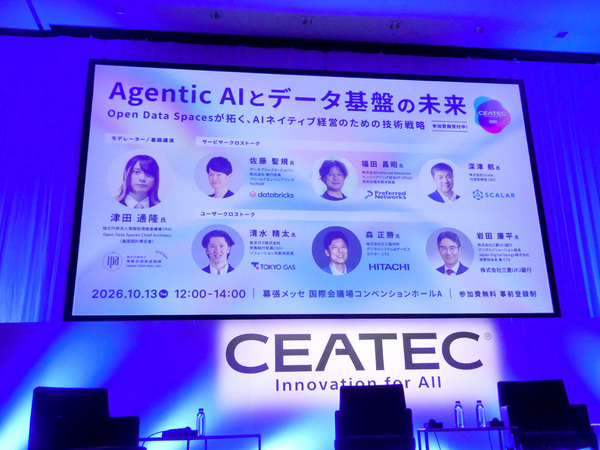
CEATEC 2026「Agentic AIとデータ基盤の未来-Open Data Spacesが拓く、AIネイティブ経営のための技術戦略」セッション
セッションは基調講演、サービサーセッション、ユーザーセッションの3部構成。基調講演では、AI時代の競争力を左右する企業固有のデータとコンテキストの重要性や、分散データマネジメントを実現するOpen Data Spacesの取り組みを紹介。続くサービサーセッションでは、データとAIの技術を提供する3社が、AIエージェントの権限管理やデータの信頼性、企業間連携の課題を議論し、ユーザーセッションでは、東京ガス、日立製作所、三菱UFJ銀行の3社が、実際の事業におけるデータ活用の取り組みと、組織や制度の壁について語った。
基調講演:AI時代の競争力を左右するのは企業固有のデータとコンテキスト
本セッションの基調講演には、独立行政法人情報処理推進機構(IPA)でOpen Data Spaces Chief Architect(最高設計責任者)を務める津田通隆氏が登壇。AI時代において企業の競争力の根源となるのは「データとコンテキスト」であると説明した。
IPAでOpen Data Spaces Chief Architectを務める津田通隆氏
現在、米国のAI開発企業は、大規模言語モデルの性能向上に向け、学習データや計算資源の確保に巨額の投資を行っている。しかし、インターネット上のテキストデータはすでに大量に学習に利用されており、現在の学習速度では、2032年までにAIの学習に利用できるテキストデータが不足するとの予測もある。そのため、足りないデータをどう確保するかが重要な課題になる。
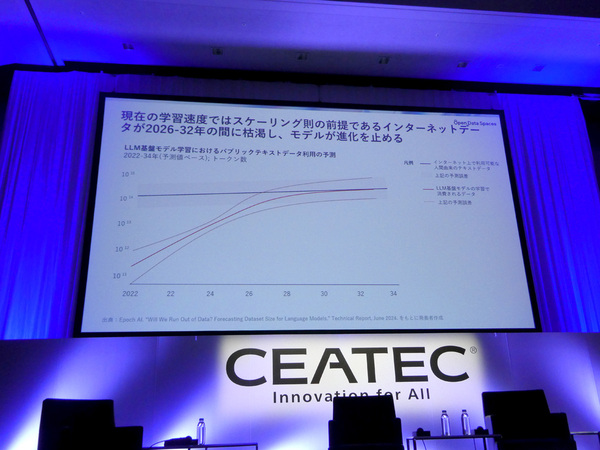
現在の速度では、2032年までに学習し尽くすという予測
さらに企業がAIを業務に活用するには、モデルの性能向上とは別の問題がある。ClaudeやChatGPTのCodexなど、すでに提供されているAIは多くの業務に対応できる能力を備えている。重要なのは、一般的な知識を持つAIに対し、個々の企業や業界特有の情報をどう与えるかという点だと津田氏は語った。「皆さんのドメイン特有の、皆さんしか知らないコンテキストをどういうふうにAIに統合するんですか、というのが一番の論点」(津田氏)
しかし、企業におけるAI活用は必ずしも成果につながっていない。津田氏はMITのレポートを引用し、調査対象となった企業の生成AI導入の取り組みのうち、95%が測定可能な損益上のリターンを生み出していないという結果を紹介した。津田氏は、その背景として、企業固有のコンテキストを適切な制御のもとでAIに渡せていない問題を指摘した。こうした課題は、AIが質問に答えるだけでなく、人間の代理として判断や業務の実行まで担うAIエージェントへと進化することで、さらに重要になってくる。
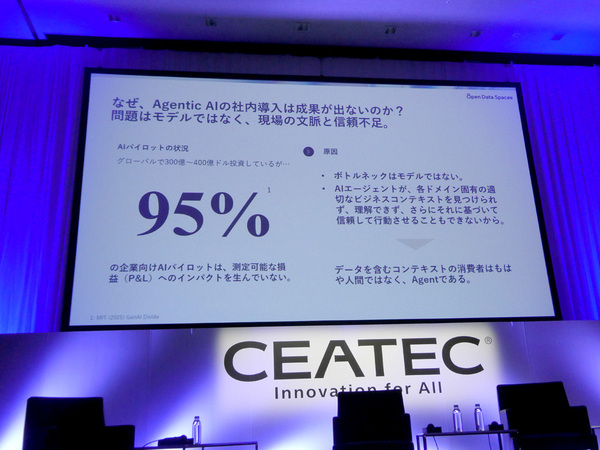
企業向けAIパイロットは測定可能な損益へのインパクトを生んでいない
AIエージェントが業務を実行するには、企業固有のデータや業務システムを利用する必要がある。そのため、従来のソフトウェアの使い方も変わっていくという。これまでのSaaSは、人間がGUIを操作し、ユーザー数に応じて料金を支払う形だった。これに対し、AIエージェントがAPIを通じて機能を利用するようになれば、課金体系もトランザクション単位へと変化し、ソフトウェアには機能の提供だけでなく、実際の業務成果が求められる。
また、従来のSaaSを構成していたGUI、業務データを記録・管理するSoR(System of Record)、ビジネスロジックの役割も変わる。GUIの一部はAIエージェントに置き換わり、AIエージェントが必要に応じて既存のソフトウェアを呼び出し、業務を処理する。こうした中、SoRには、企業固有のデータとその意味を、AIが利用できる形で保持する役割が求められる。ここで重要なのは、単にデータを集約するのではなく、それぞれの業務で使われている意味や文脈を維持することだと津田氏は語った。
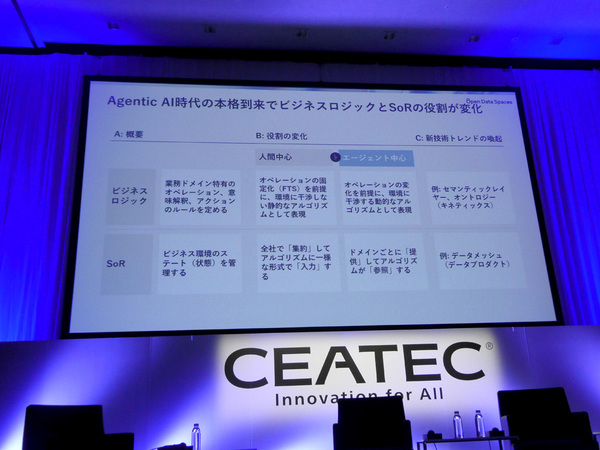
AIエージェントの普及によって、GUIやSoR、ビジネスロジックの役割も変化していく
●データの集中管理から、文脈を維持する分散管理へ
津田氏はAI時代のデータ活用を支える考え方として「データメッシュ」を紹介した。これまでのデータマネジメントでは、社内のさまざまなシステムに存在するデータを中央集権的に集約することが重視されてきた。しかし、全社のデータ管理を担う中央チームに要求が集中し、対応待ちが発生するという問題が生じる。
さらに、データを集約する過程で、実際の業務を知らない担当者が加工や変換を行うと、そのデータが本来持っていた意味や文脈が失われる場合があるといい、津田氏は、自身が携わっていた航空業界を例に説明した。
航空業界では、同じ「高さ」という項目でも、地上からの高さを示す対地高度と、東京湾平均海面を基準とする標高では意味が異なる。どちらもデータ上の項目名が「高さ」だったとしても、その違いを理解せずに組み合わせれば、航空事故につながりかねない。
データの意味を最も理解しているのは、実際にその業務を担当する現場の人間だ。そこでデータメッシュでは、データを中央に集めて一括管理するのではなく、それぞれの業務領域であるドメインが管理責任を持ち、ほかの部門やAIに提供する仕組みを採用する。この考え方自体は2019年に登場したものだが、近年はデータレイクハウスなどの技術が発展し、データを分散して管理したまま利用できる環境が整いつつあるという。
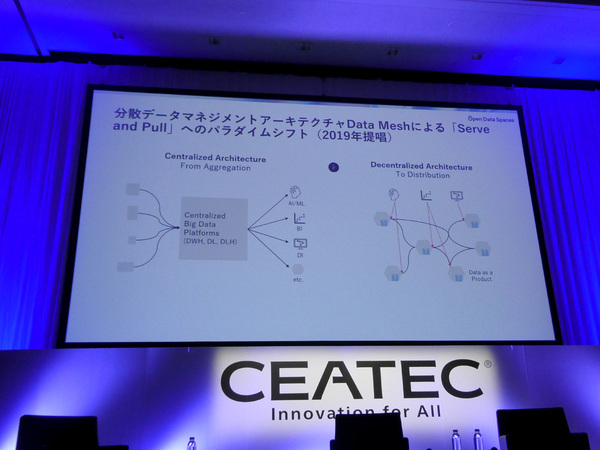
Data Meshによる「Serve and Pull」へのパラダイムシフト
●企業のデータを守りながら活用するOpen Data Spaces
こうした分散データマネジメントを基盤として開発が進められているのが「Open Data Spaces」だ。津田氏は、AIエージェントが企業や業界の枠を超えて活動する時代には、それぞれの組織が自らのデータに対する管理権限を維持しながら、信頼できる相手に必要なデータを提供できる仕組みが必要になると説明した。
企業が保有するデータやコンテキストは、AI時代の競争力の源泉となる。それを無条件に外部へ公開するのではなく、利用条件やアクセス権限を管理しながら、必要な相手やAIエージェントに選択的に提供する。Open Data Spacesは、こうしたデータの保護と組織を超えた活用の両立を目指している。
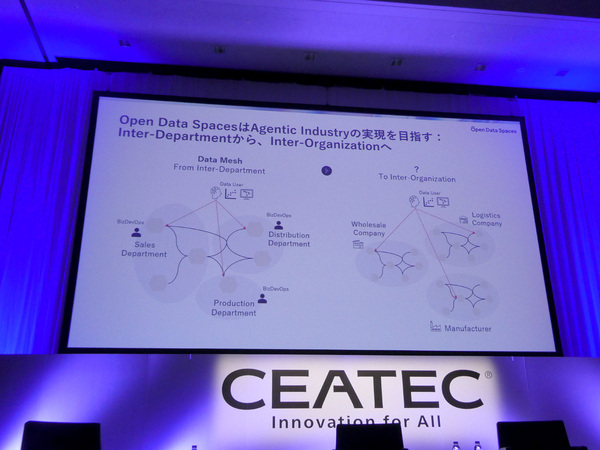
データの管理権限を維持しながら、組織を越えたデータ共有を目指すOpen Data Spaces
この取り組みは完全なオープンソースとして進められており、2026年4月にはアーキテクチャのリファレンスモデルやプロトコルを公開。日米の企業100社以上が参加するコミュニティ活動も展開している。津田氏は今回のセッションで、データやAIのサービスを提供する企業と、それらを実際の事業に活用する企業の双方の話を聞き、分散データマネジメントの可能性と課題を紐解いていくといい、基調講演を終了した。
サービサーセッション:データとAIの活用を支える3社の技術
基調講演に続くサービサーセッションは津田氏をモデレーターに、データブリックス・ジャパンの執行役員 フィールドエンジニアリングTechGMを務める佐藤聖規氏、Preferred Networksのエンジニアリング担当VP(VPoE)技術企画本部本部長を務める福田昌昭氏、Scalarの代表取締役CEOを務める深津 航氏が登壇した。
サービサーセッションに登壇した津田氏、データブリックス・ジャパン 佐藤聖規氏、Preferred Networks 福田昌昭氏、Scalar 深津 航氏
データブリックス・ジャパンの佐藤氏は、データとAIを統合的に扱う同社のプラットフォームを紹介した。同社は大規模データの分散処理を実現する「Apache Spark」、データレイクの信頼性を高める「Delta Lake」、データウェアハウスとデータレイクを統合するレイクハウスアーキテクチャなど、データ活用の技術的課題に取り組んできた。
データブリックス・ジャパンの佐藤聖規氏
現在のプラットフォームでは、異なるクラウド環境に対応し、構造化データと非構造化データの両方をAIに活用できるようにしている。佐藤氏が特に重要だと説明したのが、データとAIのガバナンスだ。データの管理やAIの利用を適切に制御する仕組みに加え、データに意味を持たせるセマンティックレイヤーも備えている。こうした技術を統合することで、企業が保有するデータをAIに活用し、競争力につなげるための基盤を提供していると紹介した。
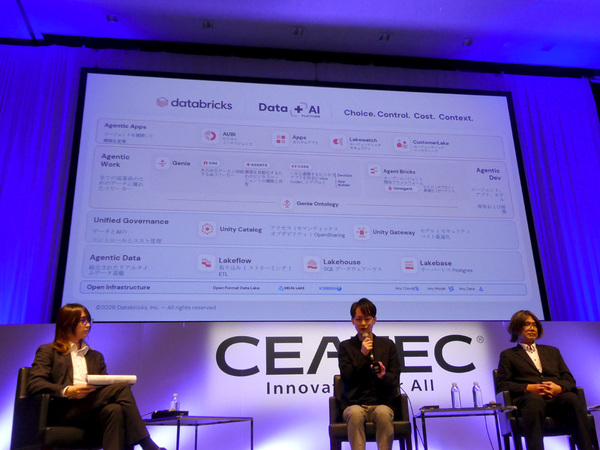
データとAIを統合的に管理し、企業のデータ活用を支えるDatabricksのプラットフォーム
Preferred Networksの福田氏は、同社のAI技術と今後の展望を紹介した。同社は創業以来AIの研究開発に注力し、現在は第3世代、第4世代の半導体開発を進めるとともに、独自の計算基盤やクラウドサービス、生成AIの基盤モデルを開発。これらの技術を活用し、製造業を中心に、ヘルスケアや教育、エンターテインメントなど幅広い分野へAIソリューションを提供している。
Preferred Networksの福田昌昭氏
福田氏が今後の重要な領域として挙げたのが、AIの活用をサイバー空間から現実世界へと広げる「フィジカルAI」だ。生成AIの技術革新に続き、現実世界でもAIが判断し、行動する技術が発展すると予測。その際には、データの意味や管理方法、アクセス権限、利用条件などを維持しながら、異なるシステムや組織をどう連携させるかが大きな課題になるという。福田氏は、同社が掲げる「現実世界を計算可能にする」というビジョンにも触れ、Open Data Spacesの取り組みを通じて、技術を現実世界に還元したいと語った。
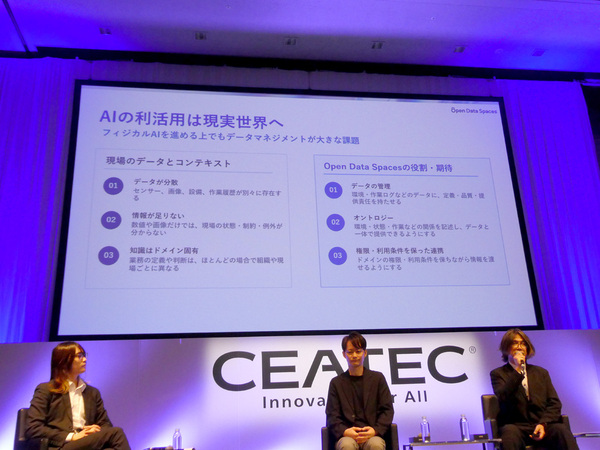
AIの活用領域をサイバー空間から現実世界へ広げるフィジカルAI
Scalarの深津氏は、AIエージェントが企業間のデータを自動的に取引する時代を見据え、データの整合性や取引の証拠性を確保する技術を紹介した。同社が開発する「ScalarDB」は、業務領域ごとに分散したデータの取引処理や整合性を保つための製品。「ScalarDL」は、データの改ざんを検知し、取引の証拠性を確保する。深津氏は、企業間でデータをやり取りする際に、誰がどのような権限や条件でデータを利用し、何を実行したのかを機械的に証明できる仕組みが重要になると説明した。
Scalarの深津 航氏
さらに、開発中のオープンソースソフトウェアも紹介した。既存のデータベースをスキャンしてデータの内容や関係性を把握し、意味や利用条件を整理することで、AIが適切なデータを利用できるようにするものだ。データの意味を誤解したり、利用条件を間違えたりする問題への対応を目指しており、複数のデータベースに対応し、データを分散した状態で管理・活用する仕組みだという。
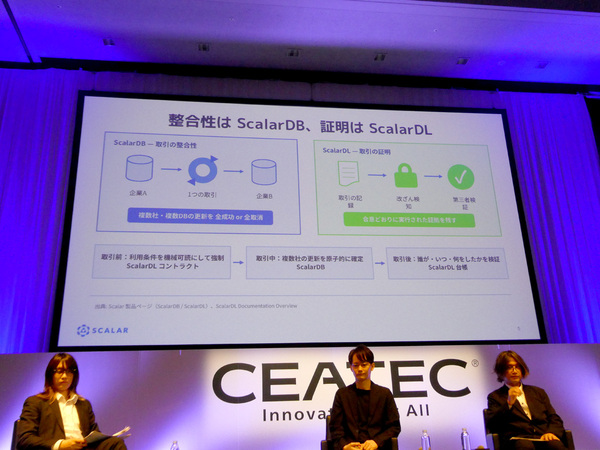
分散データの整合性や取引の証拠性を確保し、AIエージェントによるデータ利用を支える技術
●AIエージェントに何を任せ、どこまで信頼できるのか
3社のプレゼンテーションに続くクロストークでは、AIエージェントの普及に伴う課題が議論された。
佐藤氏は、米国ではチャット形式のAIを利用する段階から、自律的に業務を進めるAIエージェントの導入へと移行が進んでいると説明した。特にコーディングエージェントの普及が著しく、顧客データを扱うCDP(カスタマーデータプラットフォーム)や、セキュリティインシデント対応などにも活用が広がっているという。
福田氏が指摘したのは、AIエージェントの権限管理だ。例えば、社内でAIエージェントを開発する際、開発者本人の権限をそのままエージェントに与えてしまうケースがあり、AIエージェントが本来アクセスすべきでない情報まで扱ってしまう可能性がある。また、個人間でやり取りしている情報をAIエージェントが読み取り、別の相手に伝えてしまうことも考えられる。AIがロボットなどの身体性を持ち、現実世界で行動するようになれば、その結果に誰が責任を持つのかという問題も生じるという。
深津氏は、米国の決済事業者から聞いた事例を紹介した。その企業では1週間に約4PBものデータが発生するが、分析基盤へ転送するには2週間かかるという。膨大なデータをすべて中央に移動させて処理するのは難しい。
さらに、AIエージェントが扱うデータは人間が直接確認できる範囲を超えるため、データを生み出す段階から適切に管理することが重要になる。深津氏は、AIエージェント同士がデータを交換する際、そのデータを特定の目的に利用してよいのか、内容が正しいのか、途中で改ざんされていないかを確認できる仕組みが必要だと説明した。また、万一情報が漏洩した場合に、そのデータが自社のものであると証明できることも重要になると語った。
津田氏をモデレーターに、AIエージェントの普及に伴う課題について議論した
●AI時代に変わる開発環境と日米の違い
次の話題は、日米のAI活用やシステム開発環境の違い。佐藤氏は、米国ではデータ管理やガバナンスの基盤を整えたうえで、AIを具体的な業務にどう活用するかという議論が進んでいると説明した。しかし、日本では組織面・技術面の課題が残る企業も多く、経営課題としてデータとAIに投資する姿勢にも違いがあるという。
深津氏は、日米のシステム開発文化の違いを指摘した。米国では担当者の入れ替わりを前提にドキュメントを整備し、リリース後も継続的に改善する開発スタイルが一般的なのに対し、日本では大規模な更新時にまとめてシステムを変更するケースが多いという。
ただし、日本でもAIを使ったソフトウェア開発によって、開発の進め方が変わり始めている。深津氏によれば、同社が複数の企業で検証した例では、開発コストが従来の約15分の1になった。これまで大きな投資判断が必要だった開発も、まず小規模に試し、結果を見ながら改善する方法を取りやすくなる。
福田氏は、AIやデータ活用の進展は国ごとの違いよりも、企業や業種による違いが大きいのではないかと指摘。特に日本が強みを持つ製造業やインフラ分野のデータは、今後の競争力を左右する重要な資産になるとの見方を示した。
AIを活用した開発では、従来の約15分の1までコストを削減できた検証例も紹介された
●企業や組織の壁を越えたデータ連携
企業間のデータ連携について佐藤氏は、データを各組織で管理しながら、交換先やAIによる利用範囲を制御する仕組みを紹介した。実際に同社の技術でデータメッシュを構築している顧客も多数いるという。
深津氏は、既存の仕組みを大きく変えずにデータ連携を進める方法として、PDFとJSONを組み合わせた例を挙げた。例えば、請求書や商品価格の情報をPDFでやり取りする際、JSON形式のデータを添付して電子署名を付ければ、受け取った側はデータの正当性を検証し、システムで自動処理できる。
さらに、スマートコントラクトなどを利用してデータの利用条件をプログラムで扱えるようにすれば、既存システムを大きく変えずに企業間のデータ流通を進められる可能性があるという。
福田氏は、企業が保有するデータを眠らせておくのはもったいないが、企業間でデータを活用するには、共通のプロトコルや権限管理の仕組みだけでなく、どこで競争し、どこで協調するのかを整理する必要があると指摘した。
サービサーセッションの最後には、3氏が経営者に向けてメッセージを送った。佐藤氏は、AIやデータの活用は個々の企業だけで完結するものではなく、企業や技術者が協力して取り組むことが重要だと呼びかけ、福田氏は、技術の導入に先立ち、何を解決したいのかを明確にする必要があると指摘した。
深津氏は、経営者自身がAIを実際に利用すれば、トークンコストやデータの問題などに直面し、AIを活用するために必要なシステムやデータ基盤を具体的に考えられるようになるといい、まず使ってみることを勧めた。
ユーザーセッション:AI活用を事業につなげる3社の取り組み
サービサーセッションに続くユーザーセッションには、東京ガスの常務執行役員CDO・ソリューション共創本部長を務める清水精太氏、日立製作所のデジタルシステム&サービスセクターCTOを務める森 正勝氏、三菱UFJ銀行のデジタルソリューション部長で、Japan Digital Designの取締役会長兼CTOも務める岩田廉平氏が登壇した。
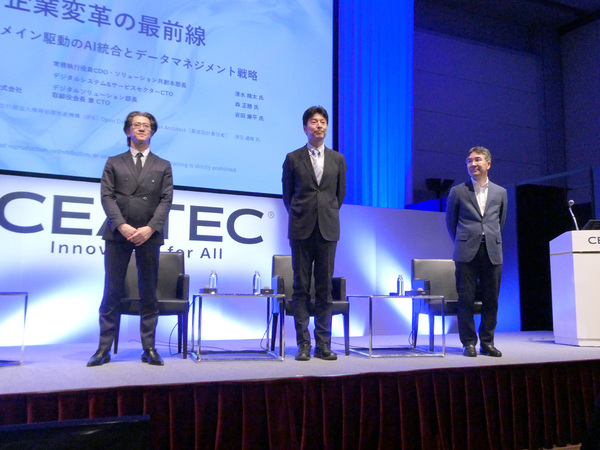
ユーザーセッションに登壇した東京ガス 清水精太氏、日立製作所 森 正勝氏、三菱UFJ銀行 岩田廉平氏
東京ガスの清水精太氏は、同社が目指す「AIネイティブ企業」に向けた取り組みを紹介した。同社はエネルギーを供給するだけでなく、顧客がエネルギーを使って解決したい課題に応えることを重視し、ソリューションブランド「IGNITURE(イグニチャー)」を展開。脱炭素、最適化、レジリエンスの3分野で蓄積したデータの活用を進めている。
東京ガスの清水精太氏
データ基盤の整備では、当初は中央集約型を目指したものの、部門ごとにデータの質や量が異なるため、各部門がそれぞれのペースで整備を進めるデータメッシュ型を採用した。AI活用もオフィス業務から現場や顧客向けのソリューションへ広げ、業績に貢献する成果が出始めているという。今後の課題として、AIで解くべき問題の見極めや、LLMとSLMの使い分けを挙げた。また、企業に蓄積されたデータには偏りがある可能性を指摘し、その特性を理解したうえでAIによる価値創出につなげる重要性を強調した。
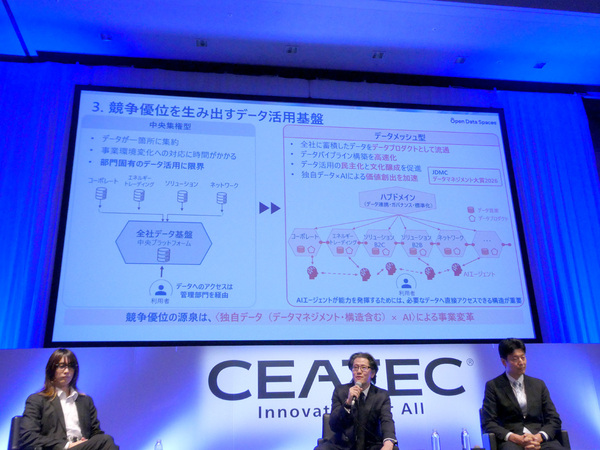
東京ガスでは各部門が主体となってデータ基盤を整備し、AI活用を現場や顧客向けのソリューションにも広げている
日立製作所の森 正勝氏は、エネルギー、鉄道、産業分野などの社会インフラ事業とデジタル技術を組み合わせたAI活用の取り組みを紹介した。同社が重視するのは、長年にわたり顧客の現場で培ってきたドメインナレッジ(業務領域の専門知識)をAIに取り込み、現場へ還元することだ。現在は「HMAX(エイチマックス)」を通じて、AIとドメインナレッジを組み合わせ、社会インフラの運用を支援する仕組みの提供を進めている。
日立製作所の森 正勝氏
そのため、データの収集からAIによる活用、現場へのフィードバックまでを継続的に回す運用も、顧客に提供しているという。また、社内でもAI活用を進めており、熟練者が持つ暗黙知の継承や、複雑な工程を伴う素材開発などに応用。人手不足が進む中、AIによって現場の人を支援する取り組みを進めている。
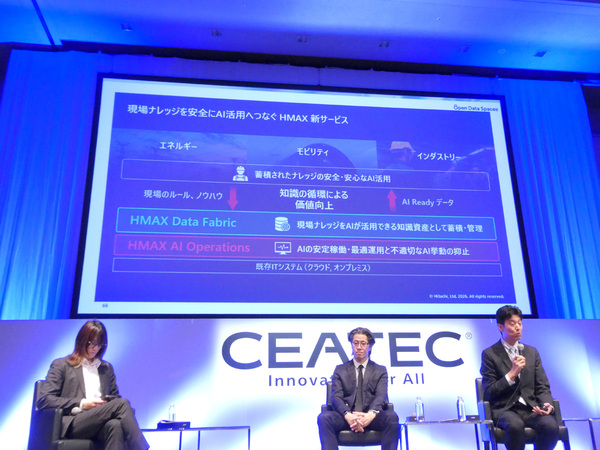
AIと現場で培ったドメインナレッジを組み合わせ、社会インフラの運用を支援するHMAX
三菱UFJ銀行の岩田廉平氏は、AIネイティブ企業への変革に向けた取り組みと、AIエージェント時代に必要なデータ基盤について説明した。同社は、銀行、信託、証券など多様なグループ会社を抱え、海外にも事業を展開しているため、データの統合には課題があるという。現在のAI活用は、AIの回答をもとに人間が行動する形が中心だが、AIエージェントが自律的に行動するようになれば、より厳格なガバナンスが必要になる。特に、AIが正しいデータに適切な権限でアクセスできることが重要だと指摘した。
三菱UFJ銀行の岩田廉平氏
そのためのデータ基盤について、岩田氏は4つの論点を挙げた。1つ目は、特定の技術に依存しないオープンな仕様の採用。2つ目は、データを一元化せず、分散した状態でも仮想的にアクセスできる仕組みだ。グループ各社や海外拠点のデータは法規制の面からも一元化が難しいという。3つ目は、データの意味やコンテキストの管理と、AIエージェントに対するアクセス権限の設計。4つ目は、AIによる大量のデータアクセスに対応できる処理基盤の性能確保だ。今後はこれらの課題について実際に検証し、問題点を洗い出したうえで、社内への横展開を進める考えを示した。
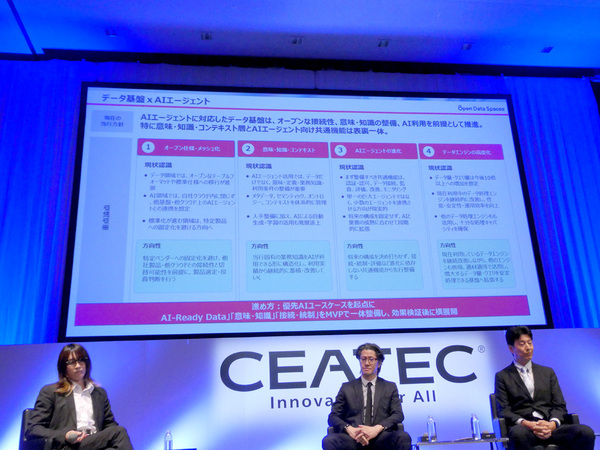
三菱UFJ銀行が挙げた、AIエージェント時代のデータ基盤に必要な4つの論点
●データ活用を進める企業が直面する組織と制度の壁
3社のプレゼンテーションに続き、津田氏をモデレーターに、AI時代のデータマネジメントと組織運営について議論が交わされた。
清水氏は、生成AIの登場によって、正しいデータを利用できる状態にすることの重要性が経営層にも理解されやすくなったと説明した。ただし、データ基盤の必要性を技術面から説明するだけでは投資につながりにくい。そこで同社では、海外のエネルギー事業者の先進事例を示し、経営層の関心や危機感を高めてきたという。
データメッシュ型のアプローチによって各部門が主体的にデータ基盤を整備できるようになった反面、部門ごとの縦割りが強まるという課題も生じている。これに対応するため、東京ガスでは部門横断のプロジェクトやタスクフォースを増やしている。特定のテーマにプロジェクトオーナーを置き、異なる部門のデータを組み合わせて活用する方法だ。
AI時代のデータマネジメントと組織運営について議論する3社の登壇者
AI時代のデータマネジメントと組織運営について議論する3社の登壇者
森氏は、各事業領域で蓄積したドメインナレッジを共有する際にも、現場ごとの違いを踏まえることが重要だと説明。鉄道やエネルギーなどの分野では、それぞれ異なる業務知識や運用上の制約があるため、単純にデータや技術を横展開するだけでは対応できないと語った。
岩田氏が挙げたのは、国境や法人を越えたデータ活用の難しさ。例えば、同じ顧客がニューヨーク、ロンドン、シンガポール、東京で行っている取引を横断的に把握できれば、より適切な提案やサービスの提供につながる可能性がある。
しかし、実現には各国のデータ越境規制や個人情報保護への対応に加え、法人ごとに異なる顧客同意の取得・管理などの問題がある。技術的にデータを集められたとしても、それだけで自由に利用できるわけではないという。
●AIエージェント時代に変わる組織とデータの扱い方
AIエージェントが人間に代わって業務を実行するようになったとき、企業の組織や仕事の進め方はどう変わるのか。岩田氏が挙げたのは、ベテラン社員が持つ知識や経験の継承だ。同社でも一部の組織では社員の高齢化が進んでいることが課題となっている。
融資業務やバックオフィスの事務処理では、申込書の内容に応じて細かな判断が必要になるが、その中にはマニュアルや文書に書き切れない暗黙知も多い。こうした知識をベテラン社員が退職する前に組織内に蓄積し、AIエージェントが利用できるようにすることで、人が入れ替わっても安全かつ安定的に業務を続けられるようにしたいという。
清水氏は、同社のAIエージェントは現時点では複数の選択肢を提示する段階で、最終的な判断や実行は人間が担っていると説明した。今後、AIが実行まで担うようになれば、部門をまたぐ業務の連携が必要になるが、現在の組織や業務プロセスは必ずしもそれを前提に設計されていない。
さらに、情報の共有に対する組織内の抵抗も大きな課題だと指摘した。企業では、特定の情報を持っていることが、その人の立場や権限につながる場合もある。情報を広く共有することで自分の立場が脅かされると感じる人もおり、技術だけでは解決できない感情的な問題が生じるという。今後、複数のAIエージェントが部門をまたいで連携するようになれば、従来の階層的な管理体制や業務プロセスそのものを見直す必要があると語った。
日立製作所の森氏が取り上げたのは、顧客との契約上の制約だ。同社は多くの顧客企業と共同で技術やソリューションを開発しているが、そこで得られたデータや知識を別の顧客向けのAIに利用するには、契約上の確認や合意が必要になる場合がある。国や地域によってデータの取り扱いに関する規制が異なることも課題となる。こうした契約や規制の問題を整理することで、企業間のより高度な知識共有が可能になるとの考えを示した。
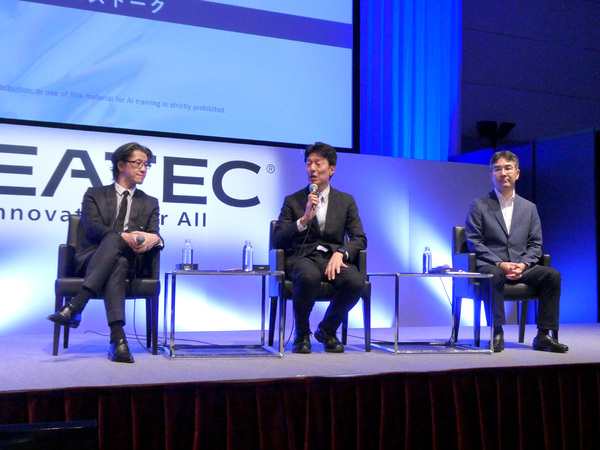
AIエージェントの活用に向け、データ共有を阻む組織や制度の課題について意見が交わされた
クロストークの終盤には、3氏が経営者に向けてメッセージを送った。清水氏は、AIを使って企業価値を高めるには、まず何を実現したいのかという強い思いが必要だと語った。森氏も、AIはあくまでツールであり、技術があるから使うのではなく、実現したいことのためにどう活用するかが重要だと指摘した。
岩田氏は、全社のデータや暗黙知を一度に整備しようとしても膨大な時間がかかるとして、まず具体的な業務上のニーズを明確にし、それに必要なデータや知識から整備するという進め方を勧めた。
最後に津田氏は、AIエージェントのアクセス制御には技術だけでなく、企業間の契約や法務面の判断も必要だと指摘した。Open Data Spacesについても、組織内に閉じず、グループ企業や外部パートナーとデータや知見を共有し、AIエージェントの基盤として活用することが今後の課題だという。日本国内だけでなく、米国との関係も視野に入れながら、データマネジメントのあり方を議論していきたいと語り、セッションを締めくくった。
国内だけでなく、米国も視野に入れながらデータマネジメントのあり方を議論していきたいという津田氏
本記事はアフィリエイトプログラムによる収益を得ている場合があります